Buka Tiket
 +373 79 600002
 Obrolan Langsung Telegram
 F.A.Q
 Indonesia
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 中文 (中国)









 untuk semua layanan hosting


Ollama vs llama.cpp di 2026: Runtime LLM Lokal Mana yang Harus Anda Gunakan?
Вы хотите запускать языковую модель с открытыми весами на оборудовании, которым управляете сами: на ноутбуке, рабочей станции, домашнем сервере или приватном удалённом сервере. Одно руководство указывает на Ollama и модель, которую можно загрузить по имени. Другое указывает на llama.cpp, файл модели и множество дополнительных настроек.
Тогда утверждения начинают противоречить друг другу. Ollama называют более простым, а llama.cpp — более быстрым; один вариант представляют как более практичный, другой — как более мощный. Эти утверждения часто сравнивают разные модели, настройки, оборудование или уровни программного стека.
Полезный вопрос не в том, какое название побеждает, а в том, сколько рабочего процесса запуска модели должен брать на себя инструмент и насколько ваша задача требует, чтобы он открывал доступ к этим возможностям.
Jawaban dalam 60 Detik
Pilih Ollama jika Anda menginginkan runner dan layanan model yang terintegrasi. Penyiapan, pengambilan model bernama, dan penyimpanan berbagi satu alur kerja. Pengaturan default dan resep kustomisasi mencakup konfigurasi rutin, sementara API lokal yang siap pakai memberi aplikasi antarmuka yang stabil. Ini biasanya merupakan pilihan default yang lebih rapi untuk eksperimen, alat coding, dan utilitas internal yang tidak memerlukan administrasi runtime tingkat rendah.
Pilih llama.cpp jika Anda memerlukan kontrol inferensi secara langsung. Anda dapat memilih build dan backend perangkat keras, mengunci artefak model yang tepat, serta mengelola keputusan terkait proses, memori, dan tuning. Pilihan ini juga cocok untuk perangkat lunak yang harus menyematkan inferensi, alih-alih menggunakannya dari layanan terpisah.
Tidak ada yang selalu unggul secara universal: Ollama dapat menangani penyajian rutin, sedangkan llama.cpp mandiri dapat menangani eksperimen terkontrol. Sebelum membandingkan performa, pastikan kecocokan model, kuantisasi, konteks, dan perangkat keras. Sisa perbandingan ini menguji alur kerja, perangkat keras, integrasi, dan deployment—bukan benchmark yang dibuat-buat.
Ollama và llama.cpp nằm ở các tầng khác nhau
Inference nghĩa là chạy một mô hình đã được huấn luyện để tạo ra đầu ra; inference engine là thành phần thực hiện phép tính đó. llama.cpp là một thư viện và bộ công cụ C/C++ có tính di động cao. Thư viện lõi của nó đi cùng các công cụ dòng lệnh và llama-server, bao gồm một Web UI. Nó cũng cung cấp các tiện ích chuyển đổi và lượng tử hóa cùng bản phân phối chính thức llama, vì vậy llama.cpp không chỉ là CLI.
Ollama là một trình chạy mô hình và dịch vụ, đặt một quy trình làm việc có quan điểm riêng xung quanh inference. Nó quản lý việc lấy và lưu trữ mô hình, áp dụng template hoặc Modelfile, và lập lịch inference. Truy cập API và một số backend được chọn cũng thuộc cùng dịch vụ này. Do đó, Ollama không chỉ là một lớp bao giao diện đồ họa; vòng đời mô hình là trọng tâm của sản phẩm.
Sơ đồ tầng đơn giản hóa
| Đường dẫn | Mô hình tư duy theo tầng |
|---|---|
| Luồng Ollama | Ứng dụng hoặc CLI → Ollama API, vòng đời mô hình, template và lập lịch → thành phần inference đi kèm (đường dẫn GGUF hiện tại: llama-server được ghim phiên bản) → backend phần cứng được chọn |
| Luồng llama.cpp | Ứng dụng, CLI hoặc Web UI → thư viện llama.cpp hoặc llama-server → bản build/backend được chọn trực tiếp và các tùy chọn runtime → phần cứng |
Mô hình tư duy đơn giản hóa—không phải kiến trúc đầy đủ. Mô tả dễ tiếp cận: Ollama bổ sung quản lý mô hình và điều phối dịch vụ phía trên các thành phần inference đi kèm, trong khi llama.cpp để lộ thư viện và server của mình gần hơn với các tùy chọn phần cứng.
Theo kiểm chứng vào ngày 5 tháng 9 năm 2026, đường dẫn GGUF được phát hành của Ollama khởi chạy một llama-server upstream được đóng gói và ghim phiên bản, nằm bên dưới lớp dịch vụ của nó. Nói ngắn gọn, llama.cpp cung cấp động cơ và các công cụ điều khiển ở mức xưởng, còn Ollama đóng gói các cơ chế đó thành một chiếc xe sẵn sàng lái với bảng điều khiển đơn giản hơn. Phép so sánh này giải thích sự trừu tượng hóa, chứ không phải mọi thành phần hay đường dẫn mô hình.
📝 Lưu ý: Việc đóng gói một llama-server được ghim phiên bản không làm cho Ollama giống hệt llama.cpp upstream. Ollama vẫn cung cấp các giá trị mặc định, template, cơ chế lập lịch và API công khai riêng. Các đường dẫn không dùng GGUF hoặc thử nghiệm cũng có thể khác biệt.
Enam Istilah Kunci yang Memudahkan Perbandingan
Anda tidak perlu glosarium lengkap tentang rekayasa inferensi. Keenam istilah ini mencakup pilihan model, memori, dan perangkat keras yang akan dibahas.
| Istilah | Arti dalam Bahasa Sederhana | Mengapa Memengaruhi Pilihan Ini |
|---|---|---|
| 📦 GGUF | Wadah biner berorientasi inferensi untuk tensor dan metadata model, yang menjadi pusat ekosistem llama.cpp. GGUF sendiri tidak menentukan tingkat kuantisasi. | Ini adalah artefak portabel utama yang digunakan langsung oleh llama.cpp dan jalur impor yang didukung untuk Ollama. |
| 🗜️ Kuantisasi | Representasi tensor model dengan presisi lebih rendah, yang umumnya mengurangi kebutuhan penyimpanan dan memori. Dampak pada kualitas dan kecepatan bervariasi tergantung metode, model, backend, dan beban kerja. | Kuantisasi yang dipilih dapat menentukan apakah model muat dan berkinerja baik, terlepas dari runtime. |
| 📏 Panjang konteks | Anggaran token aktif yang tersedia bagi model untuk instruksi, input, riwayat, dan output. | Konteks aktif yang lebih besar mengonsumsi lebih banyak memori, sehingga kapasitas maksimum yang diiklankan bukanlah kapasitas gratis. |
| ⚙️ Backend | Jalur komputasi spesifik perangkat keras, seperti CUDA, Metal, HIP/ROCm, atau Vulkan. | Dukungan runtime dan build untuk backend terbaik pada mesin dapat menentukan apakah akselerasi bekerja dengan baik. |
| 🚀 GPU offloading | Menempatkan lapisan atau komputasi model yang memenuhi syarat pada GPU, alih-alih menjalankan semua pekerjaan di CPU. | Jumlah dan penempatan offload dapat mengubah penggunaan memori dan kecepatan lebih besar daripada pembungkus layanan. |
| 🗃️ KV cache | Status atensi yang disimpan sehingga model dapat menggunakan kembali konteks sebelumnya saat menghasilkan teks. Ukurannya bertambah seiring dengan konteks aktif dan jumlah sekuens. | Konteks panjang dan pengguna bersamaan dapat mengonsumsi RAM atau VRAM yang cukup besar selain file model itu sendiri. |
The Spesifikasi GGUF menjelaskan artefak tersebut; kuantisasi mengubah cara tensornya direpresentasikan. Konteks dan KV cache membentuk jejak memorinya, sementara backend dan offloading menentukan di mana komputasi dijalankan.
Tetapkan Kriteria Sebelum Membandingkan
Kedua proyek dapat menjalankan model open-weight pada perangkat keras yang dikendalikan pengguna dan menyediakan inferensi melalui API. Kemampuan bersama tersebut tidak menentukan hasil perbandingan. Gunakan delapan pertanyaan yang sama di seluruh pembahasan:
- Seberapa besar kerumitan pengaturan yang dapat Anda terima sebelum permintaan berguna pertama?
- Apakah layanan sebaiknya mengelola siklus hidup model, atau apakah Anda sebaiknya memiliki file pasti dan pilihan peluncuran?
- Seberapa besar kontrol tingkat rendah yang benar-benar dibutuhkan beban kerja?
- Opsi mana yang memiliki kecocokan perangkat keras dan backend yang tepat untuk mesin ini?
- Apakah aplikasi memerlukan layanan HTTP atau integrasi dalam proses yang lebih ketat?
- Apa keamanan operasional yang harus melindungi endpoint?
- Siapa yang akan menangani pemeliharaan, pembaruan, dan kemampuan replikasi?
- Apakah inferensi akan berjalan di perangkat, di server pribadi jarak jauh, atau di cloud vendor?
Perbandingan kinerja memerlukan artefak model yang tepat—file yang telah dikonversi beserta metadata yang dijalankan—bukan sekadar nama keluarga yang sama. Samakan templat yang dirender dan konteks aktif, lalu selaraskan backend, perilaku offload, dan perangkat keras. Gunakan versi perangkat lunak, batching, dan kondisi konkurensi yang sama. Dengan rubrik ini sudah ditetapkan, mulailah dengan perbedaan yang paling terlihat: alur kerja harian.
Рабочий процесс: удобство управляемых инструментов против явного контроля
Ошибка: текст на английском, целевой язык — индонезийский. Ниже — перевод на индонезийский.
Alur Kerja Harian: Kemudahan Terkelola vs Kontrol Eksplisit
Pengaturan awal menunjukkan perbedaannya:
- Ollama menyediakan instalasi siap pakai untuk macOS, Windows, dan Linux, yang mengarah ke alur kerja layanan dengan lebih sedikit pilihan di awal
- Distribusi resmi llama, package manager, dan rilis prebuilt menyediakan jalur llama.cpp yang mudah diakses
- Container dan build dari source menambah kontrol ketika opsi siap pakai tidak sesuai
Ini bukan lagi sekadar “installer yang ramah versus compile semuanya,” tetapi llama.cpp tetap menyediakan lebih banyak keputusan terkait akuisisi, build, dan peluncuran.
Setelah terpasang, penanganan model membuat perbedaannya semakin nyata. Library bernama Ollama dan perilaku pull-on-run menyederhanakan akuisisi, sementara penyimpanan terkelola, perintah lifecycle, dan default menangani pekerjaan rutin yang berulang. llama.cpp dimulai dari artefak GGUF tertentu, meskipun tooling terkini dapat mengambil dan menyimpan cache model Hugging Face yang kompatibel dengan -hf; server/router-nya juga dapat menemukan model dan mengelola pemuatan. Keunggulan Ollama bukan sekadar memiliki fitur manajemen model, melainkan menyatukannya dalam satu rutinitas.
Untuk kustomisasi, Modelfile adalah resep deklaratif Ollama. Ia mengidentifikasi model dasar dan parameter, mendefinisikan perilaku prompt atau system, serta melampirkan adapter. Dengan llama.cpp, kemampuan repetisi dimulai dari GGUF dan build yang tepat; backend dan konfigurasi peluncuran mengunci lebih banyak mekanisme di baliknya.
Ollama tidak terbatas pada library model-nya. Alur impor-nya menerima file GGUF yang didukung serta model atau adapter Safetensors, dengan batasan arsitektur dan konversi. GGUF tetap menjadi format portabel utama llama.cpp, tetapi tooling resmi juga menangani akuisisi dan caching.
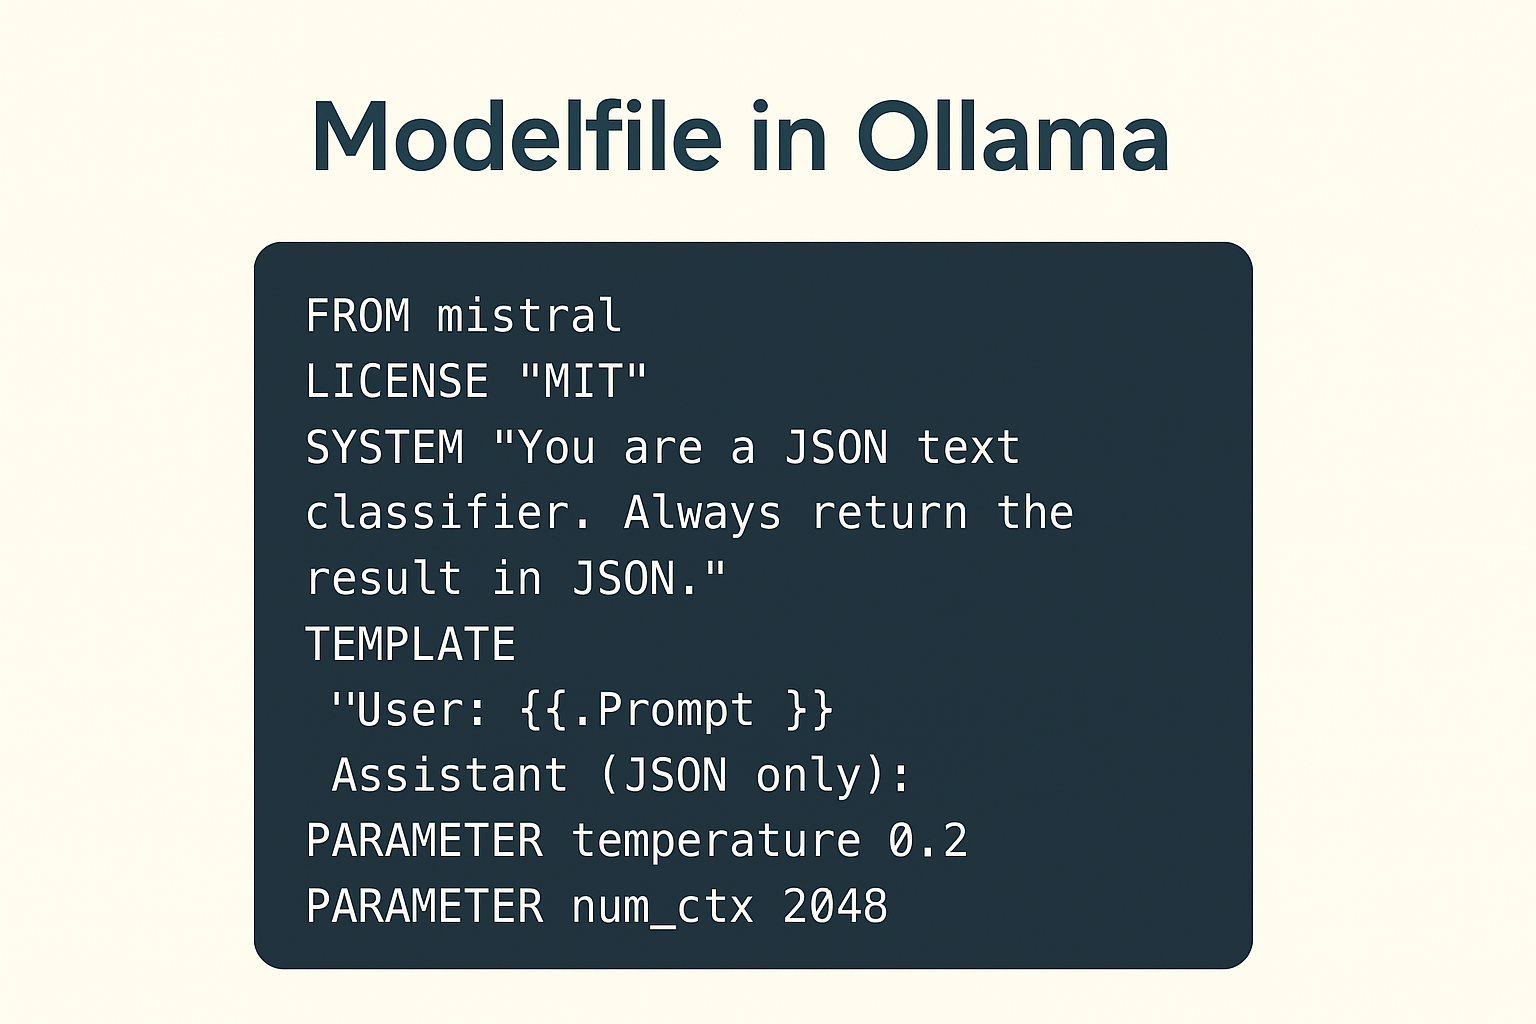
Pembaruan dan repetisi mengambil bentuk yang berbeda. Ollama dapat mereproduksi pengaturan sehari-hari melalui model bernama, Modelfile, dan default terkelola, meskipun revisi internal dapat berubah saat pembaruan. llama.cpp memungkinkan operator mengunci build, artefak, dan pengaturan, tetapi mereka harus memelihara detail tersebut. Pertukarannya adalah beban administratif versus visibilitas: default mengurangi keputusan berulang, sementara pengaturan eksplisit membuat perilaku khusus lebih mudah diperiksa.
Производительность, память и оборудование: почему не существует универсального победителя
Ah, wait — the target language is Indonesian, not Russian. Here is the correct translation:
Performa, Memori, dan Perangkat Keras: Mengapa Tidak Ada Pemenang Universal
Sebuah runtime bisa memuat dengan cepat tetapi menghasilkan output dengan lambat, atau memproses prompt panjang secara efisien tetapi kesulitan dengan generasi bersamaan. Cold loading, pemrosesan prompt, dan pembuatan token adalah fase yang terpisah. Satu label “lebih cepat” menyembunyikan fase yang diukur dan apakah fase tersebut menyerupai beban kerja nyata.
Bahkan prompt harus sama hingga di balik teks yang terlihat. Dua layanan dapat menerima pesan yang sama tetapi merender chat template, penanda peran, atau special token yang berbeda. Hal itu mengubah input token dan beban kerja sebelum generasi. Perilaku sampling dan panjang output menambah perbedaan lebih lanjut.
Ukuran file GGUF bukanlah kebutuhan memori puncaknya. Tensor model membentuk dasar, sementara KV cache menambah memori untuk konteks dan sekuens yang aktif. Compute buffer, adapter, dan multimodal projector menambah overhead. Draft model atau model residen lainnya mengonsumsi kapasitas lebih banyak, dan sistem operasi memerlukan ruang cadangan. Konteks yang lebih panjang dan lebih banyak sekuens bersamaan dapat, oleh karena itu, memperbesar penggunaan memori secara substansial. Jika model tidak muat, selesaikan masalah ukuran sebelum membandingkan runtime.
llama.cpp secara langsung menyediakan penempatan thread, ukuran konteks dan batch, serta tipe KV-cache. Penempatan perangkat dan GPU layer, pemisahan multi-GPU, serta jalur speculative tetap menjadi pilihan operator. Ollama mengotomatisasi lebih banyak, tetapi tetap menyediakan konteks aktif, permintaan paralel, residensi model, dan penjadwalan GPU. Flash Attention dan kontrol KV-cache tetap tersedia melalui konfigurasi, Modelfile, atau opsi API. Kontrol tersebut hanya berguna jika Anda memiliki alasan untuk menyetelnya.
Dukungan perangkat keras juga sulit dinilai secara sederhana. Ollama mengemas jalur CPU dan GPU yang umum, dengan Metal, CUDA, ROCm, dan Vulkan sebagai contoh. Matriks build yang lebih luas milik llama.cpp menjangkau target yang umum maupun yang tidak biasa. Backend yang terdokumentasi mungkin belum matang atau tidak disertakan di setiap binary prebuilt. Performa bergantung pada build, driver, perangkat, dan seberapa baik model memanfaatkan kernel yang relevan.
⚠️ Peringatan: Nama model yang sama atau satu tangkapan layar tokens-per-second bukanlah perbandingan yang terkontrol. Artefak atau template yang berbeda mengubah beban kerja yang diukur; konteks, default, dan kondisi warm-up mengubah kondisi pengujian.
Untuk pemeriksaan performa Ollama vs llama.cpp yang adil:
- Gunakan artefak model yang sama persis atau checksum yang sama, kuantisasi, adapter, dan multimodal projector jika berlaku.
- Cocokkan chat template dan token prompt yang dirender, panjang output yang diminta, dan perilaku sampling.
- Cocokkan konteks, representasi KV-cache, pengaturan batch dan microbatch, slot paralel, serta kondisi antrean atau konkurensi.
- Cocokkan versi dan build perangkat lunak, backend, driver, pemilihan perangkat, serta perilaku offload atau split GPU.
- Laporkan cold load, pemrosesan prompt yang sudah warm, dan pembuatan token secara terpisah.
- Ulangi pengujian di bawah konkurensi dan bentuk permintaan yang akan digunakan aplikasi nyata.
Banyak GPU atau kuantisasi bit lebih rendah tidak menjamin inferensi yang lebih cepat. Interkoneksi dan pergerakan memori dapat membatasi pengaturan multi-GPU, sementara kernel dan bentuk permintaan dapat mengubah hasil. Pilih konfigurasi yang muat dengan ruang cadangan, lalu ukur fase dan pola yang akan digunakan aplikasi Anda.
API и интеграция: сначала сервис или сначала инструментарий?
Ollama изначально задумана как долгоживущий сервис для моделей. Она предоставляет собственный API — свой формат запросов и ответов — а также официальные клиенты для Python и JavaScript. Это подходит для плагина или внутреннего инструмента, которому нужна стабильная локальная HTTP-конечная точка. Ollama загружает модель, а приложение лишь отправляет запросы.
Ollama документирует отдельные маршруты, совместимые с OpenAI и Anthropic. Текущий llama-server документирует оба стиля наряду с нативными эксплуатационными конечными точками. Эти слои позволяют существующим клиентам использовать знакомую форму API с другой средой выполнения.
Проверенная замена базового URL в стиле OpenAI может сэкономить усилия на интеграцию, но она не гарантирует поддержку всех функций. Структурированный вывод и использование инструментов зависят от маршрута, модели и шаблона промпта. Эмбеддинги или мультимодальный ввод могут зависеть от сборки и клиента. Проверяйте эти возможности в рамках приложения, а не как простые галочки в описании среды выполнения.
📝 Примечание: «Совместимость» означает совместимость выбранных маршрутов и полей. Сначала проверьте точную конечную точку и поля запроса. Затем проверьте поведение потоковой передачи и форматы вызовов инструментов, а также обработку изображений, подсчет токенов, поля ответа и ошибки, которые использует ваше приложение.
llama-server — серьезный вариант для развертывания, а не демонстрационная обертка. Его веб-интерфейс предоставляет браузерную поверхность, а параллельное декодирование и непрерывная пакетная обработка поддерживают совместное обслуживание. Маршрутизация и загрузка моделей добавляют управление жизненным циклом на уровне сервера; совместимые маршруты и нативные эксплуатационные конечные точки дополняют интерфейс. Он может быть лучшим HTTP-слоем, когда важнее прямой контроль, чем управляемый жизненный цикл Ollama.
Когда HTTP недостаточно, C-подобная библиотека llama.cpp может встроить инференс непосредственно в процесс. Приложение контролирует инициализацию и завершение работы, а низкоуровневые настройки остаются рядом с его кодом. Ollama обычно работает как отдельный сервис. Выбирайте llama.cpp, когда инференс должен поставляться внутри приложения; выбирайте Ollama, когда предпочтительнее отдельная конечная точка.
От ноутбука до постоянно работающего частного сервера
Ваша инструкция: переведи на индонезийский. Вот перевод:
Dari Laptop ke Server Pribadi yang Selalu Aktif
Ada tiga batas eksekusi.
- Inferensi di perangkat berjalan di laptop atau workstation yang membuat permintaan.
- Self-hosting pribadi jarak jauh berjalan di server yang dikendalikan organisasi; ini dapat mempertahankan kontrol operasional, tetapi permintaan melewati jaringan dan eksekusi tidak bersifat lokal pada perangkat.
- Inferensi cloud yang dihosting vendor berjalan di infrastruktur penyedia.
Perbedaan ini penting karena model dengan tag cloud dari Ollama berjalan di cloud-nya meskipun klien localhost mengirim permintaan. “Menggunakan Ollama” tidak membuktikan eksekusi lokal. Penerapan strict-local harus mengecualikan atau menonaktifkan fungsi cloud sesuai dokumentasi terkini.
Kedua proyek secara default hanya mengekspos jaringan secara lokal. Ollama terikat ke lokal, dan API-nya tidak memiliki autentikasi bawaan. llama-server juga secara default menggunakan loopback—hanya dapat diakses dari host yang sama—dan menawarkan opsi API-key dan TLS. Kedua default tersebut bukan batas penerapan publik yang lengkap.
⚠️ Peringatan: API lokal Ollama tidak memiliki autentikasi bawaan, dan kunci placeholder yang diterima oleh contoh kompatibilitas tidak mengamankannya. Jangan pernah mengekspos endpoint default mentah langsung ke internet publik.
Sebelum membuat salah satu endpoint dapat dijangkau dari jarak jauh, gunakan kontrol berikut sebagai gerbang minimum:
- Alamat bind yang disengaja dan batas jaringan privat atau VPN.
- Autentikasi di server atau gateway yang terautentikasi.
- TLS untuk transport jaringan.
- Firewall, CORS, batas ukuran permintaan, konkurensi, dan batas sumber daya.
- Supervisi proses, pembaruan terkontrol, health check, dan pemantauan.
- Pencatatan log yang memperhatikan privasi, retensi, dan penanganan data yang mencegah kebocoran prompt, respons, atau kredensial.
Tentukan ukuran model dan kuantisasi sebelum mempertimbangkan kapasitas GPU sewaan. Perhitungkan konteks aktif dan konkurensi untuk memperkirakan VRAM dan cadangan operasional. Jika laptop tidak dapat memenuhi target performa atau uptime, infrastruktur GPU sewaan yang mendukung LLM—dengan AlexHost sebagai salah satu contoh—menjadi pilihan, bukan jalan pintas untuk melewati penentuan ukuran.
Pernyataan privasi vendor bukan audit independen. Dokumentasikan di mana inferensi berjalan dan jaringan mana yang dilewati permintaan. Catat siapa yang mengelola sistem dan apa yang disimpan dalam penyimpanan atau log. Catatan tersebut mendefinisikan batas privasi lebih jelas daripada logo runtime.
Которой версией стоит воспользоваться? Рекомендации по сценариям использования
Не путайте этот раздел с Indonesian…
Ниже перевод на индонезийский язык.
Mana yang Sebaiknya Anda Pilih? Rekomendasi Berdasarkan Kasus Penggunaan
Rekomendasi ini menggambarkan kesesuaian beban kerja, bukan tingkat keterampilan. Kemudahan bisa menjadi kebutuhan rekayasa; kontrol langsung bisa menjadi beban tambahan yang tidak perlu. Pilihan berubah ketika persyaratan spesifik melampaui batas abstraksi.
Eksperimen lokal pertama atau alat pengembang: Pilih Ollama ketika penyiapan cepat itu penting dan Anda ingin model dipanggil berdasarkan nama. API siap pakainya memberi alat tersebut antarmuka yang stabil tanpa pekerjaan pengelolaan siklus hidup yang tidak membantu evaluasi atau integrasi. Pilih llama.cpp sebagai gantinya jika Anda memerlukan backend yang tidak didukung, build yang tepat, atau pengaturan tingkat rendah yang tidak tersedia.
Inferensi kustom yang dapat direproduksi atau aplikasi tertanam: Pilih llama.cpp ketika produk harus memiliki artefak dan build yang tepat. Ia juga mengontrol inisialisasi dan pengaturan runtime secara langsung, yang penting ketika inferensi berjalan di dalam aplikasi. Pilih Ollama sebagai gantinya jika layanan HTTP terpisah dan kontrol tingkat Modelfile sudah sepenuhnya memenuhi kebutuhan produk.
Perangkat keras terbatas atau tidak biasa, atau penyetelan maksimal: Mulailah dengan llama.cpp ketika cakupan backend yang lebih luas atau penempatan eksplisit memecahkan persyaratan tertentu. Pertama-tama pastikan bahwa model sesuai dengan kapasitas. Pilih Ollama ketika ia mendukung perangkat keras dengan baik dan penyetelan langsung hanya akan menambah beban pemeliharaan tanpa kontrol yang berguna atau peningkatan yang terukur.
Layanan privat yang dapat diakses tim: Ollama biasanya merupakan titik awal dengan hambatan lebih rendah untuk siklus hidup dan penyajian, asalkan operator menambahkan batas jaringan yang terautentikasi. Pertimbangkan llama-server ketika kunci API native, kontrol penyajian langsung, atau penyetelan backend lebih penting. Tolak kedua opsi jika tim tidak dapat memenuhi persyaratan selalu aktif di atas.
Gunakan keduanya: Pertahankan Ollama dan llama.cpp mandiri sebagai titik masuk dan domain siklus hidup yang terpisah. Aplikasi dapat memilih endpoint yang sudah diuji untuk penyajian rutin atau eksperimen terkontrol, tetapi tidak dapat berasumsi perilaku API yang identik. Setiap runtime dapat memiliki penyimpanan model, port, dan proses sendiri; jika keduanya memuat model, keduanya dapat bersaing untuk RAM atau VRAM. Ollama tidak menggunakan layanan llama.cpp terpisah Anda.
Matriks di bawah ini merangkum pilihan-pilihan tersebut. Jangan menghitung baris sebagai poin: satu persyaratan wajib dapat mengalahkan semua kemudahan di bagian lain.
| Area keputusan | Ollama | llama.cpp |
|---|---|---|
| 🚀 Mulai tercepat | Jalur instalasi, model, dan layanan yang terintegrasi | Pilihan akuisisi, build, dan peluncuran tetap terlihat |
| 🔄 Siklus hidup model | Pull berdasarkan nama, penyimpanan terkelola, Modelfile, residensi, dan penjadwalan | GGUF langsung atau cache Hugging Face ditambah kontrol router, preset, dan pemuatan; kurang beropini secara menyeluruh |
| 🎛️ Penyetelan terperinci | Default otomatis dengan konfigurasi terpilih dan kontrol API | Kontrol langsung yang lebih luas atas build, perangkat, penempatan, cache, dan batch |
| 🧩 Penyematan dalam proses | Biasanya dikonsumsi sebagai layanan terpisah | Library gaya C adalah kecocokan langsung yang lebih kuat |
| 🌐 Layanan API | API native plus lapisan kompatibilitas terbatas | llama-server dengan kompatibilitas terbatas dan rute operasional native |
| ⚙️ Fleksibilitas backend | Dukungan paket yang dikurasi | Matriks backend saat build yang lebih luas, dengan catatan tentang build dan kematangan |
| 🛠️ Tanggung jawab operasional | Siklus hidup model/layanan terintegrasi; autentikasi eksternal diperlukan di luar penggunaan lokal | Kepemilikan server lebih eksplisit serta opsi kunci dan TLS native; pengerasan tetap diperlukan |
| 🎯 Beban kerja paling sesuai | Layanan model lokal atau privat sehari-hari yang dapat diulang | Inferensi tertanam, eksperimental, spesifik perangkat keras, atau sangat disetel |
Bottom Line
Dua jalur dari pembuka tampak bertentangan karena keduanya memberikan kepemilikan yang berbeda. Pilih Ollama ketika alur kerja terintegrasi itu sendiri merupakan fitur utama. Pilih llama.cpp ketika kontrol langsung atas inferensi merupakan fitur utamanya.
Jika Anda ragu, pastikan model dan kuantisasi sesuai dengan perangkat keras. Periksa biaya memori dari konteks yang dimaksud, lalu mulailah dengan Ollama. Beralih ke—atau menambahkan—llama.cpp mandiri hanya untuk kebutuhan tingkat rendah yang konkret: backend atau build tertentu, embedding dalam proses, atau penempatan dan penyetelan yang lebih halus.