提交工单
 +373 79 600002
 Telegram 在线聊天
 常见问题
 中文 (中国)
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia











Ollama vs llama.cpp 在 2026 年:你应该使用哪个本地 LLM 运行时?
你希望在自己可控的硬件上运行开源权重的大语言模型(LLM):笔记本电脑、工作站、家庭服务器或私有远程服务器。一份指南推荐 Ollama,并可以通过名称拉取模型。另一份指南推荐 llama.cpp,需要自备模型文件,但可以进行更多的控制。
接着,这些说法开始相互冲突。Ollama 被称为更易用,llama.cpp 则被称为更快;一个被视为更实用,另一个则被视为能力更强。这些比较往往针对的是不同的模型、设置、硬件或软件栈的不同层级。
有价值的问题不在于哪个名称更胜一筹,而在于这个工具应该替你管理多少模型运行的工作流,以及你的工作负载需要它暴露出多少控制权。
60秒答案
当你需要一个集成的模型运行器和服务时,选择 Ollama。设置、指定模型的获取和存储共享同一套工作流程。默认配置和自定义方案涵盖日常配置,而现成的本地 API 为应用程序提供稳定的接口。对于实验、编程工具和不需要底层运行时管理的内部工具,这通常是更简洁的默认选择。
当你需要直接控制推理过程时,选择 llama.cpp。你可以选择构建版本和硬件后端,固定确切的模型文件,并管理进程、内存和调优决策。它也适用于必须将推理嵌入软件内部、而不是从独立服务中调用的场景。
两者都不是万能的赢家:Ollama 可以处理常规服务,而独立的 llama.cpp 可以处理受控实验。在比较性能之前,请先确认模型、量化、上下文和硬件是否匹配。本次比较的其余部分测试的是工作流程、硬件、集成和部署,而非虚构的基准测试。
Ollama 与 llama.cpp 位于不同的层级
推理(Inference)是指运行已经训练好的模型以生成输出;推理引擎(inference engine)负责执行这一计算。llama.cpp 是一个可移植的 C/C++ 库和工具集。其核心库与命令行工具以及 llama-server 并存,后者包含一个 Web UI。它还提供转换和量化工具,以及官方的 llama 发行版,因此 llama.cpp 并不仅限于 CLI。
Ollama 是一个模型运行器和服务,它为推理提供了一套有明确主张的工作流程。它管理模型的获取与存储,应用模板或 Modelfile,并调度推理任务。API 访问和部分选定的后端也属于同一服务。因此,Ollama 不仅仅是一个图形化外壳;模型生命周期是该产品的核心。
简化的层级图
| 路径 | 分层思维模型 |
|---|---|
| Ollama 路径 | 应用程序或 CLI → Ollama API、模型生命周期、模板与调度 → 内置推理组件(当前 GGUF 路径:固定版本的 llama-server)→ 选定的硬件后端 |
| llama.cpp 路径 | 应用程序、CLI 或 Web UI → llama.cpp 库或 llama-server → 直接选定的构建版本/后端及运行时控制 → 硬件 |
简化的思维模型,并非完整架构。通俗描述:Ollama 在内置推理组件之上增加了模型管理和服务编排,而 llama.cpp 则更贴近硬件地暴露其库和服务器控制。
截至 2026 年 9 月 5 日的核实信息,Ollama 发布的 GGUF 路径会在其服务层之下启动一个内置的、固定版本的上游 llama-server。简而言之,llama.cpp 提供引擎和“工坊式”的控制,而 Ollama 则将这些机制封装成一辆配有更简单仪表盘、可直接驾驶的车辆。该类比解释的是抽象层次,并不涵盖每个组件或模型路径。
📝 注意:内置固定版本的 llama-server 并不意味着 Ollama 与上游 llama.cpp 完全相同。Ollama 仍然提供自己的默认设置、模板、调度和公共 API。非 GGUF 或实验性路径也可能有所不同。
让比较更容易理解的六个关键术语
你不需要完整的推理工程术语表。以下六个术语涵盖了接下来关于模型、内存和硬件选择的内容。
| 术语 | 通俗含义 | 为何影响此选择 |
|---|---|---|
| 📦 GGUF | 一种面向推理的二进制容器,用于存储模型张量和元数据,是 llama.cpp 生态系统的核心。GGUF 本身并不规定量化级别。 | 它是 llama.cpp 直接使用的主要可移植文件格式,也是 Ollama 支持的导入路径。 |
| 🗜️ 量化 | 以较低精度表示模型张量,通常可以减少存储和内存需求。质量和速度的影响因方法、模型、后端和工作负载而异。 | 所选的量化方式会影响模型能否装入以及运行性能如何,与运行时无关。 |
| 📏 上下文长度 | 模型可用于指令、输入、历史记录和输出的活动 token 预算。 | 更大的活动上下文会占用更多内存,因此宣传的最大值并不等于可免费使用的容量。 |
| ⚙️ 后端 | 特定于硬件的计算路径,例如 CUDA、Metal、HIP/ROCm 或 Vulkan。 | 运行时和构建对机器最佳后端的支持,决定了加速能否良好工作。 |
| 🚀 GPU 卸载 | 将符合条件的模型层或计算放到 GPU 上执行,而不是全部交由 CPU 处理。 | 卸载的数量和位置对内存占用和速度的影响,可能比服务封装层更大。 |
| 🗃️ KV 缓存 | 存储的注意力状态,使模型在生成时能够复用先前的上下文。其占用空间随活动上下文和序列数量增长。 | 长上下文和并发用户可能会占用大量 RAM 或 VRAM,超出模型文件本身的占用。 |
GGUF 规范描述了该文件格式;量化改变其张量的表示方式。上下文和 KV 缓存决定其内存占用,而后端和卸载则决定计算在何处运行。
Установите критерии до сравнения
Нет, это текст на английском. Перевод на китайский:
在比较之前设定标准
两个项目都可以在用户可控的硬件上运行开源权重模型,并通过 API 提供推理服务。这些共同的能力并不能决定比较结果。请在整个比较过程中使用以下八个问题:
- 在获得第一个有用的请求之前,你能接受多大的设置门槛?
- 应该由服务来管理模型生命周期,还是由你来掌握确切的文件和启动选项?
- 该工作负载真正需要多少底层控制能力?
- 哪种选项与这台机器的硬件和后端匹配度最高?
- 应用程序需要 HTTP 服务,还是更紧密的进程内集成?
- 端点周围必须具备哪些运营安全措施?
- 谁来负责维护、更新和可重复性?
- 推理将在设备端、远程私有服务器还是厂商云上运行?
性能比较需要使用确切的模型文件——即所运行的转换后文件和元数据——而不仅仅是相同的系列名称。请匹配渲染模板和活动上下文,然后统一后端、卸载行为和硬件。使用相同的软件版本、批处理和并发条件。确定了这一标准之后,从最明显的差异开始:日常工作流程。
日常工作流:托管便捷性与显式控制
初始设置体现了两者的区别:
- Ollama 提供适用于 macOS、Windows 和 Linux 的打包安装程序,之后进入服务工作流,早期需要做的选择较少
- 官方 llama 发行版、包管理器和预构建版本提供了便捷的 llama.cpp 使用途径
- 当打包选项无法满足需求时,容器和源码构建可增加控制能力
这已不再是“友好的安装程序与全部自行编译”的简单对比,但 llama.cpp 仍然在获取、构建和启动环节向用户暴露更多决策。
安装完成后,模型处理方式使这种差异更加具体。Ollama 的命名模型库和运行时拉取行为简化了获取过程,而托管存储、生命周期命令和默认设置则负责处理重复性的日常维护工作。llama.cpp 则从特定的 GGUF 文件开始,不过当前工具可以通过 -hf 获取并缓存兼容的 Hugging Face 模型;其 server/router 也能发现模型并管理加载。Ollama 的优势不仅在于具备模型管理功能,更在于将这些功能整合进了一套统一的流程。
在自定义方面,Modelfile 是 Ollama 的声明式配方。它指定基础模型和参数,定义提示词或系统行为,并附加适配器。对于 llama.cpp 而言,可重复性始于精确的 GGUF 文件和构建版本;后端与启动配置则对底层机制进行了更多固定。
Ollama 并不局限于其模型库。其导入工作流可接受受支持的 GGUF 文件以及 Safetensors 模型或适配器,但需遵守架构和转换方面的限制。GGUF 仍是 llama.cpp 的核心可移植格式,而官方工具也负责获取和缓存等工作。
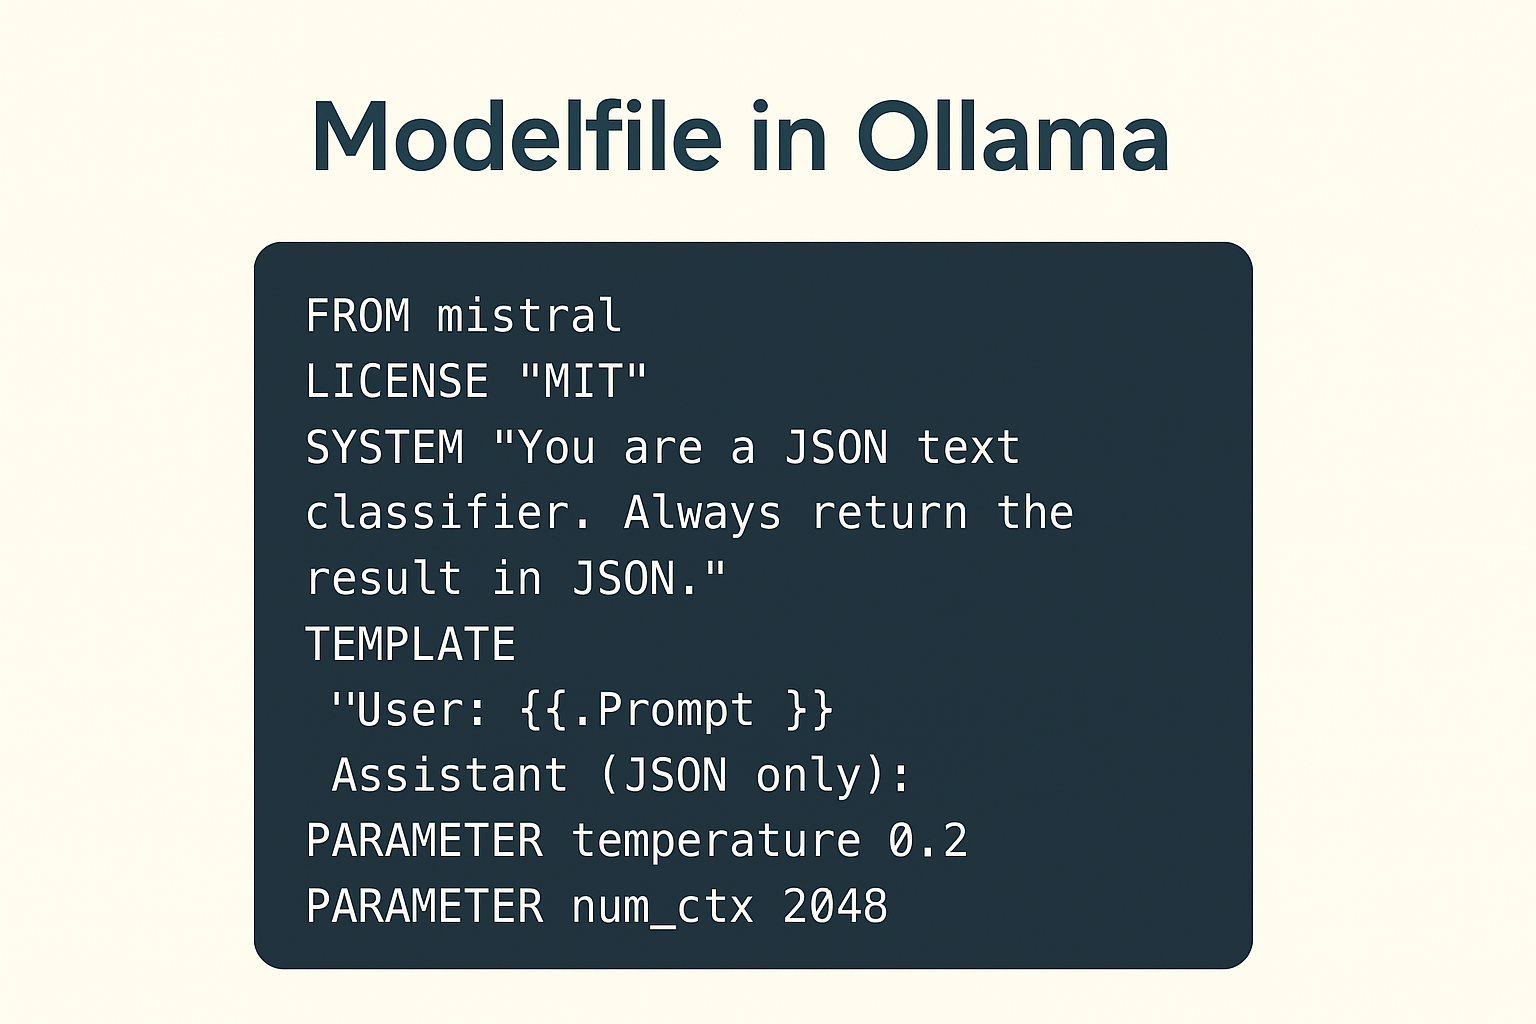
更新与可重复性的表现形式各不相同。Ollama 可以通过命名模型、Modelfile 和托管默认设置复现日常使用的配置,但内部版本可能会随更新而变化。llama.cpp 允许运维人员固定构建版本、制品和设置,但这些细节需要由其自行维护。两者的权衡在于管理负担与可见性:默认设置减少了重复性决策,而显式设置则让特殊行为更易于检查。
性能、内存与硬件:为何不存在通用的赢家
运行时可能加载很快,但生成很慢;或者处理长提示词很高效,却在并发生成时表现吃力。冷加载、提示词处理和词元生成是彼此独立的阶段。单一的“更快”标签掩盖了实际测量的阶段,以及该阶段是否贴近真实工作负载。
即使是提示词,也必须在可见文本之下保持一致。两个服务可能收到相同的消息,但渲染的聊天模板、角色标记或特殊词元不同。这会改变输入词元以及生成之前的工作量。采样行为和输出长度又会带来进一步的差异。
GGUF 文件的大小并不等于其峰值内存需求。模型张量构成基线,而 KV 缓存则为活动上下文和序列增加内存占用。计算缓冲区、适配器和多模态投影器也会带来额外开销。草稿模型或其他常驻模型会占用更多容量,操作系统也需要预留余量。因此,更长的上下文和更多的并发序列可能大幅增加内存使用。如果模型无法装入,请先解决容量规划问题,再比较运行时。
llama.cpp 直接提供线程分配、上下文和批处理大小以及 KV 缓存类型的设置。设备与 GPU 层分配、多 GPU 拆分以及推测性执行路径同样由操作者自行选择。Ollama 自动化程度更高,但仍会暴露活动上下文、并行请求、模型驻留和 GPU 调度等选项。Flash Attention 与 KV 缓存控制可通过配置、Modelfile 或 API 选项使用。只有在确有必要时,这些控制才有调优价值。
硬件支持同样难以简单打分。Ollama 提供主流的 CPU 与 GPU 路径,例如 Metal、CUDA、ROCm 和 Vulkan。llama.cpp 的构建矩阵更广,覆盖主流及特殊目标平台。某个已文档化的后端可能尚不成熟,或未包含在每个预编译二进制文件中。性能取决于构建版本、驱动程序、设备以及模型对相关内核的利用程度。
⚠️ 警告:相同的模型名称或一张每秒词元数的截图并不构成受控对比。不同的构件或模板会改变实际测量的工作量;上下文、默认设置和预热状态也会改变测试条件。
要进行公平的 Ollama 与 llama.cpp 性能对比,请执行以下步骤:
- 在适用的情况下,使用完全相同的模型构件或校验和、量化方式、适配器以及多模态投影器。
- 保持聊天模板与渲染后的提示词词元、请求的输出长度以及采样行为一致。
- 保持上下文、KV 缓存表示、批处理与微批处理设置、并行槽位,以及队列或并发条件一致。
- 保持软件版本与构建、后端、驱动程序、设备选择,以及 GPU 卸载或拆分行为一致。
- 分别报告冷加载、预热后的提示词处理和词元生成。
- 在真实应用将使用的并发量和请求形态下重复测试。
多 GPU 或更低位宽的量化并不保证推理更快。互连和内存数据移动可能限制多 GPU 配置,而内核和请求形态的变化也会改变结果。请选择一个留有余量且能够装下模型的配置,然后测量你的应用将使用的阶段与模式。
API与集成:服务优先还是工具包优先?
Ollama 主要被设计为长期运行的模型服务。它提供原生 API(其自身的请求和响应接口)以及官方的 Python 和 JavaScript 客户端。这适合需要稳定本地 HTTP 端点的插件或内部工具。Ollama 负责获取和加载模型,应用程序只需发送请求即可。
Ollama 记录了部分 OpenAI 兼容和 Anthropic 兼容路由。当前的 llama-server 同时记录了这两种风格以及原生运维端点。这些兼容层让现有客户端能够以熟悉的 API 形式与不同的运行时配合使用。
经过测试的 OpenAI 风格 base-URL 更改可以节省集成工作量,但并不能证明功能支持已经到位。结构化输出和工具调用取决于路由、模型和提示模板。嵌入或多模态输入也可能取决于构建版本和客户端。应将这些能力作为应用程序的一部分进行测试,而不是当作运行时的勾选项。
📝 注意:“兼容”指的是部分路由和字段。请先测试确切的端点和请求字段。然后验证流式传输行为和工具调用格式,接着是应用程序所使用的任何图像处理、token 计数、响应字段和错误处理。
llama-server 是一个严肃的服务选项,而不仅仅是演示封装。它的 Web UI 提供浏览器界面,而并行解码和连续批处理支持共享服务。模型路由和加载增加了服务器级别的生命周期控制;兼容路由和原生运维端点则完善了整个接口。当直接控制比 Ollama 托管的生命周期更重要时,它可以成为更好的 HTTP 层。
当 HTTP 不够用时,llama.cpp 的 C 风格库可以将推理嵌入到你的进程中。应用程序控制初始化和关闭,而底层设置则保留在其代码附近。Ollama 通常是一个独立服务。当推理必须随应用程序一起发布时,选择 llama.cpp;当更倾向于使用独立端点时,选择 Ollama。
从笔记本到常驻私有服务器
存在三种执行边界。
- 设备端推理在发出请求的笔记本电脑或工作站上运行。
- 远程私有自托管在组织控制的服务器上运行;它可以保持运营控制权,但请求需要跨越网络,执行过程并非在本地设备上完成。
- 厂商托管的云推理在服务提供商的基础设施上运行。
这一区别很重要,因为即使本地主机客户端发送请求,Ollama 带云标签的模型仍在其云端运行。“使用 Ollama”并不能证明执行发生在本地。严格本地部署必须根据当前文档排除或禁用云功能。
两个项目默认都只在本地暴露网络。Ollama 绑定本地地址,其 API 没有内置身份验证。llama-server 默认也绑定回环地址——仅同一主机可访问——并提供 API 密钥和 TLS 选项。两种默认设置都不是完整的公网部署边界。
⚠️ 警告:Ollama 的本地 API 没有内置身份验证,兼容性示例中接受的占位密钥无法保护它。切勿将原始默认端点直接暴露在公共互联网上。
在使任一端点可远程访问之前,请将以下控制措施作为最低要求:
- 明确的绑定地址以及私有网络边界或 VPN。
- 在服务器或经过身份验证的网关上进行身份验证。
- 网络传输使用 TLS。
- 防火墙、CORS、请求大小、并发和资源限制。
- 进程监管、受控更新、健康检查和监控。
- 注重隐私的日志记录、保留和数据处理,避免泄露提示词、响应或凭据。
在考虑租用 GPU 容量之前,先确定模型和量化方式。考虑活动上下文和并发量,以估算显存和运行余量。如果笔记本电脑无法满足性能或运行时间目标,租用支持 LLM 的 GPU 基础设施(以 AlexHost 为例)就成为一种选择,但它不能取代容量规划。
厂商的隐私声明并非独立审计。请记录推理运行的位置以及请求经过的网络。记录管理系统的人员,以及存储或日志保留的内容。这份记录比运行时的品牌标识更清楚地界定了隐私边界。
应该选择哪一个?按使用场景推荐
这些建议描述的是工作负载的匹配程度,而不是技能水平。便利性可能是工程需求,而直接控制可能是不必要的额外开销。当某项具体需求超出抽象层的范围时,选择就会改变。
首次本地实验或开发者工具:当快速搭建很重要,并且希望通过名称调用模型时,选择 Ollama。它现成的 API 为工具提供了稳定的接口,无需处理与评估或集成无关的生命周期工作。如果你需要不受支持的后端、精确的构建版本或未开放的底层设置,则改选 llama.cpp。
可复现的自定义推理或嵌入式应用:当产品必须掌控确切的模型文件和构建过程时,选择 llama.cpp。它还能直接控制初始化和运行时设置,这在推理逻辑位于应用内部时尤为重要。如果独立的 HTTP 服务和 Modelfile 级别的控制已完全满足产品需求,则改选 Ollama。
受限或特殊硬件,或需要极致调优:当 llama.cpp 更广泛的后端支持或明确的设备分配能解决某个已知需求时,优先考虑 llama.cpp。首先要验证模型能否装入内存。如果 Ollama 对该硬件支持良好,而直接调优只会增加维护成本,却没有带来有价值的控制或可测量的改进,则选择 Ollama。
团队可访问的私有服务:在运维人员添加了经过身份验证的网络边界的前提下,Ollama 通常是生命周期管理和服务部署方面门槛较低的起点。如果原生 API 密钥、直接的服务控制或后端调优更为重要,则可考虑 llama-server。如果团队无法满足上述常驻运行的要求,则两种方案都不宜采用。
两者并用:将 Ollama 和独立的 llama.cpp 作为各自独立的入口和生命周期域进行管理。应用可以选择经过测试的端点用于日常服务或受控实验,但不能假设两者的 API 行为完全一致。每个运行时可能各自保留模型存储、端口和进程;如果两者都加载了模型,它们可能会争抢 RAM 或 VRAM。Ollama 不会使用你独立部署的 llama.cpp 服务。
下表总结了上述选择。请勿简单地统计各行的得分:一项硬性需求可能会超过其他所有便利性因素的权重。
| 决策领域 | Ollama | llama.cpp |
|---|---|---|
| 🚀 最快上手 | 集成的安装、模型和服务路径 | 获取、构建和启动方式的选择更多,过程更透明 |
| 🔄 模型生命周期 | 具名拉取、托管存储、Modelfile、驻留和调度 | 直接使用 GGUF 或 Hugging Face 缓存,并提供路由器、预设和加载控制;端到端的约束较少 |
| 🎛️ 精细调优 | 自动化默认设置,并可选择配置和 API 控制 | 对构建、设备、分配、缓存和批次拥有更广泛的直接控制 |
| 🧩 进程内嵌入 | 通常作为独立服务使用 | 类 C 的库更直接契合 |
| 🌐 API 服务 | 原生 API,并提供有范围限定的兼容层 | llama-server,提供有范围限定的兼容层以及原生运维路由 |
| ⚙️ 后端灵活性 | 精选的打包支持 | 构建时后端矩阵更广,但需注意构建和成熟度方面的限制 |
| 🛠️ 运维责任 | 集成的模型/服务生命周期;超出本地使用范围时需要外部身份验证 | 服务器归属更明确,提供原生密钥和 TLS 选项;仍需加固 |
| 🎯 最适合的工作负载 | 可重复的日常本地或私有模型服务 | 嵌入式、实验性、针对特定硬件或深度调优的推理 |
结论
开头提到的两条路径看起来相互矛盾,是因为它们对职责归属的划分不同。当集成的工作流本身就是核心功能时,选择 Ollama;当对推理过程的直接控制本身就是核心功能时,选择 llama.cpp。
如果你拿不准,先确认模型和量化方式与硬件相匹配,检查目标上下文的内存开销,然后从 Ollama 开始。只有在出现具体的底层需求时,才需要转向或额外引入独立的 llama.cpp:例如指定特定的后端或构建版本、进程内嵌入,或更精细的设备放置与调优。