Billete abierto
 +373 79 600002
 Chat en directo de Telegram
 F.A.Q
 Español
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 en todos los servicios de hosting


Ollama vs llama.cpp en 2026: ¿Qué runtime de LLM local deberías usar?
Quieres ejecutar un LLM de pesos abiertos en hardware que controlas: una laptop, una estación de trabajo, un servidor doméstico o un servidor remoto privado. Una guía apunta a Ollama y a un modelo que puedes descargar por nombre. Otra apunta a llama.cpp, un archivo de modelo y muchos más controles.
Entonces las afirmaciones chocan. Ollama se presenta como más fácil y llama.cpp como más rápido; una se enmarca como más práctica, la otra como más capaz. Esas afirmaciones a menudo comparan modelos, configuraciones, hardware o capas distintas de la pila de software.
La pregunta útil no es qué nombre gana, sino cuánto del flujo de trabajo de ejecución del modelo debe gestionar la herramienta, y cuánto necesita tu carga de trabajo exponer.
La respuesta en 60 segundos
Elija Ollama cuando quiera un ejecutor de modelos y un servicio integrados. La configuración, la obtención de modelos por nombre y el almacenamiento comparten un único flujo de trabajo. Los valores predeterminados y las recetas de personalización cubren la configuración habitual, mientras que una API local lista para usar ofrece a las aplicaciones una interfaz estable. Suele ser la opción predeterminada más limpia para experimentos, herramientas de programación y utilidades internas que no necesitan administración de bajo nivel del runtime.
Elija llama.cpp cuando necesite control directo de la inferencia. Puede seleccionar la compilación y el backend de hardware, fijar el artefacto exacto del modelo y gestionar las decisiones de procesos, memoria y ajuste. También encaja con el software que debe integrar la inferencia en lugar de consumirla desde un servicio independiente.
Ninguna de las dos es ganadora universal: Ollama puede gestionar el servicio habitual, mientras que llama.cpp independiente puede encargarse de los experimentos controlados. Antes de comparar el rendimiento, confirme que el modelo, la cuantización, el contexto y el hardware son compatibles. El resto de esta comparativa evalúa el flujo de trabajo, el hardware, la integración y el despliegue, no un benchmark inventado.
Ollama y llama.cpp se sitúan en capas diferentes
Inferencia significa ejecutar un modelo ya entrenado para producir una salida; un motor de inferencia realiza ese cálculo. llama.cpp es una biblioteca y un conjunto de herramientas portátiles en C/C++. Su biblioteca central convive con herramientas de línea de comandos y llama-server, que incluye una interfaz web. También ofrece utilidades de conversión y cuantización, y la distribución oficial llama, por lo que llama.cpp no se limita a la CLI.
Ollama es un ejecutor de modelos y un servicio que envuelve la inferencia en un flujo de trabajo con criterios definidos. Gestiona la obtención y el almacenamiento de modelos, aplica plantillas o Modelfiles, y programa la inferencia. El acceso a la API y los backends seleccionados pertenecen al mismo servicio. Por tanto, Ollama no es simplemente un envoltorio gráfico; la gestión del ciclo de vida del modelo es central en el producto.
Un mapa de capas simplificado
| Ruta | Modelo mental por capas |
|---|---|
| Vía de Ollama | Aplicación o CLI → API de Ollama, ciclo de vida del modelo, plantillas y programación → componente de inferencia incluido (ruta GGUF actual: llama-server fijado) → backend de hardware seleccionado |
| Vía de llama.cpp | Aplicación, CLI o interfaz web → biblioteca de llama.cpp o llama-server → compilación/backend seleccionado directamente y controles de ejecución → hardware |
Modelo mental simplificado, no una arquitectura completa. Descripción accesible: Ollama añade gestión de modelos y orquestación de servicios por encima de los componentes de inferencia incluidos, mientras que llama.cpp expone su biblioteca y servidor más cerca de los controles del hardware.
Según se verificó el 5 de septiembre de 2026, la ruta GGUF publicada por Ollama inicia un llama-server upstream incluido y fijado bajo su capa de servicio. Como resumen, llama.cpp proporciona el motor y los controles de taller, mientras que Ollama empaqueta esa mecánica en un vehículo listo para conducir con un panel más sencillo. La analogía explica la abstracción, no todos los componentes ni las rutas de los modelos.
📝 Nota: Incluir un llama-server fijado no hace que Ollama sea idéntico al llama.cpp upstream. Ollama sigue aportando sus propios valores predeterminados, plantillas, programación y API pública. Las rutas no GGUF o experimentales también pueden diferir.
Seis términos clave que facilitan la comparación
No necesitas un glosario completo de ingeniería de inferencia. Estos seis términos cubren las decisiones sobre el modelo, la memoria y el hardware que vienen a continuación.
| Término | Significado en lenguaje sencillo | Por qué afecta a esta elección |
|---|---|---|
| 📦 GGUF | Un contenedor binario orientado a la inferencia para los tensores y metadatos de un modelo, central en el ecosistema llama.cpp. GGUF no especifica por sí mismo un nivel de cuantización. | Es el artefacto portable principal que usa directamente llama.cpp y una ruta de importación compatible para Ollama. |
| 🗜️ Cuantización | Representar los tensores del modelo con menor precisión, lo que generalmente reduce las necesidades de almacenamiento y memoria. Los efectos en calidad y velocidad varían según el método, el modelo, el backend y la carga de trabajo. | La cuantización seleccionada puede cambiar si un modelo cabe y funciona bien, independientemente del runtime. |
| 📏 Longitud de contexto | El presupuesto de tokens activo disponible para el modelo con instrucciones, entrada, historial y salida. | Los contextos activos más grandes consumen más memoria, por lo que el máximo anunciado no es capacidad libre. |
| ⚙️ Backend | La ruta de cálculo específica del hardware, como CUDA, Metal, HIP/ROCm o Vulkan. | El soporte del runtime y de la compilación para el mejor backend de la máquina puede determinar si la aceleración funciona bien. |
| 🚀 Descarga a GPU (GPU offloading) | Colocar capas o cálculos elegibles del modelo en una GPU en lugar de mantener todo el trabajo en la CPU. | La cantidad y la ubicación de la descarga pueden cambiar el uso de memoria y la velocidad más que el envoltorio del servicio. |
| 🗃️ Caché KV | Estado de atención almacenado que permite al modelo reutilizar el contexto anterior durante la generación. Su huella crece con el contexto activo y el número de secuencias. | Los contextos largos y los usuarios concurrentes pueden consumir una cantidad considerable de RAM o VRAM además del propio archivo del modelo. |
La especificación GGUF describe el artefacto; la cuantización cambia cómo se representan sus tensores. El contexto y la caché KV determinan su huella de memoria, mientras que el backend y la descarga determinan dónde se realiza el cálculo.
Establecer los criterios antes de comparar
Ambos proyectos pueden ejecutar modelos de pesos abiertos en hardware controlado por el usuario y exponer la inferencia a través de una API. Esas capacidades compartidas no deciden la comparación. Utilice las mismas ocho preguntas en todo momento:
- ¿Cuánta fricción de configuración puede aceptar antes de la primera solicitud útil?
- ¿Debe el servicio encargarse del ciclo de vida del modelo, o debe usted gestionar los archivos exactos y las opciones de lanzamiento?
- ¿Cuánto control de bajo nivel requiere realmente la carga de trabajo?
- ¿Qué opción tiene el ajuste adecuado de hardware y backend para esta máquina?
- ¿Necesita la aplicación un servicio HTTP o una integración en proceso más estrecha?
- ¿Qué seguridad operativa debe rodear al endpoint?
- ¿Quién se encargará del mantenimiento, las actualizaciones y la repetibilidad?
- ¿Se ejecutará la inferencia en el dispositivo, en un servidor privado remoto o en una nube de proveedor?
Las comparaciones de rendimiento requieren el artefacto exacto del modelo —el archivo convertido y los metadatos que se ejecutan—, no simplemente el mismo nombre de familia. Haga coincidir la plantilla renderizada y el contexto activo, y luego alinee el backend, el comportamiento de descarga (offload) y el hardware. Use la misma versión de software, procesamiento por lotes y condiciones de concurrencia. Con esta rúbrica fijada, comience por la diferencia más visible: el flujo de trabajo diario.
Flujo de trabajo diario: comodidad gestionada frente a control explícito
La configuración inicial muestra la distinción:
- Ollama ofrece instalaciones empaquetadas para macOS, Windows y Linux, que conducen a un flujo de trabajo basado en servicio con menos decisiones iniciales
- La distribución oficial llama, los gestores de paquetes y las versiones precompiladas proporcionan rutas accesibles para llama.cpp
- Los contenedores y las compilaciones desde el código fuente aportan más control cuando las opciones empaquetadas no se ajustan a las necesidades
Ya no se trata de “instalador sencillo frente a compilar todo”, pero llama.cpp sigue exponiendo más decisiones de obtención, compilación y lanzamiento.
Una vez instalado, la gestión de modelos hace evidente la diferencia. La biblioteca con nombre de Ollama y el comportamiento de descargar al ejecutar agilizan la obtención, mientras que el almacenamiento gestionado, los comandos de ciclo de vida y los valores predeterminados se encargan de las tareas de mantenimiento repetitivas. llama.cpp parte de un artefacto GGUF específico, aunque las herramientas actuales pueden descargar y almacenar en caché modelos compatibles de Hugging Face con -hf; su servidor/router también puede detectar modelos y gestionar su carga. La ventaja de Ollama no es simplemente tener funciones de gestión de modelos, sino integrarlas en una rutina única.
Para la personalización, un Modelfile es la receta declarativa de Ollama. Identifica el modelo base y sus parámetros, define el comportamiento del prompt o del sistema y adjunta adaptadores. Con llama.cpp, la repetibilidad comienza con un GGUF exacto y una compilación concreta; el backend y la configuración de lanzamiento fijan más aspectos del mecanismo subyacente.
Ollama no se limita a su biblioteca de modelos. Su flujo de importación acepta archivos GGUF compatibles y modelos o adaptadores en Safetensors, sujetos a límites de arquitectura y conversión. GGUF sigue siendo el formato portable central de llama.cpp, pero las herramientas oficiales también gestionan la obtención y el almacenamiento en caché.
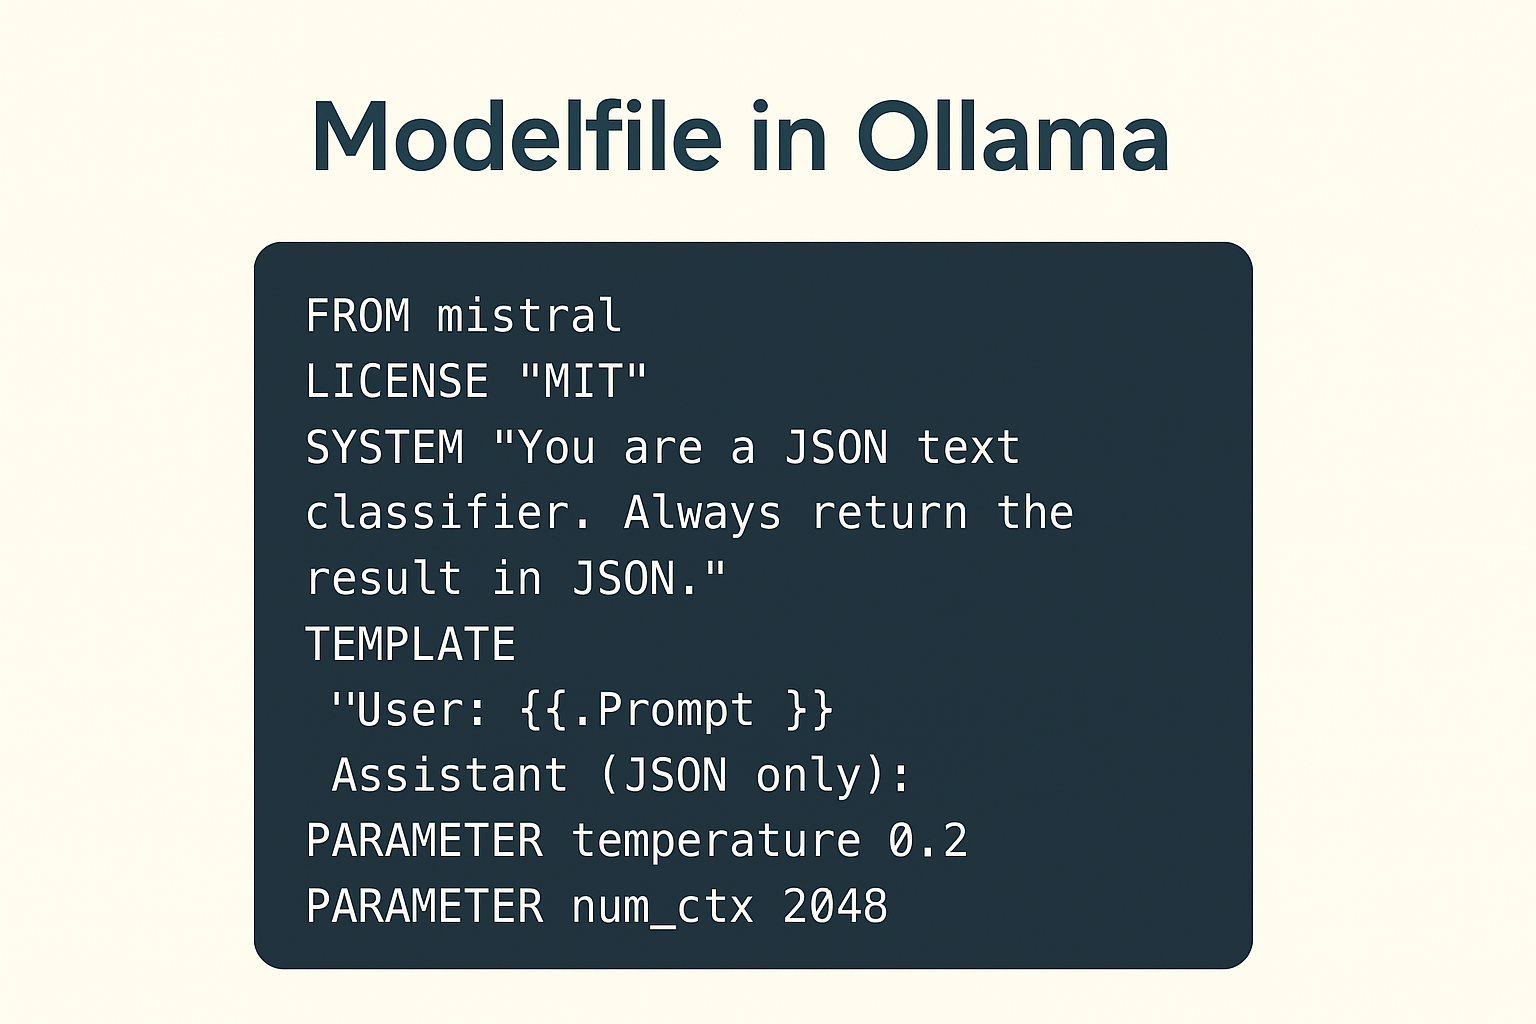
Las actualizaciones y la repetibilidad adoptan formas distintas. Ollama puede reproducir una configuración cotidiana mediante un modelo con nombre, un Modelfile y valores predeterminados gestionados, aunque las revisiones internas pueden cambiar con una actualización. llama.cpp permite a los operadores fijar la compilación, el artefacto y la configuración, pero deben mantener esos detalles por su cuenta. El compromiso es entre la carga administrativa y la visibilidad: los valores predeterminados reducen las decisiones recurrentes, mientras que la configuración explícita facilita la inspección de comportamientos especializados.
Rendimiento, memoria y hardware: por qué no existe un ganador universal
Un runtime puede cargar rápido pero generar lento, o procesar un prompt largo de forma eficiente pero tener dificultades con la generación concurrente. La carga en frío, el procesamiento del prompt y la generación de tokens son fases separadas. Una sola etiqueta de “más rápido” oculta la fase medida y si esta se parece a la carga de trabajo real.
Incluso el prompt debe coincidir más allá del texto visible. Dos servicios pueden recibir el mismo mensaje pero renderizar plantillas de chat, marcadores de rol o tokens especiales distintos. Eso cambia los tokens de entrada y el trabajo previo a la generación. El comportamiento del muestreo y la longitud de salida añaden más diferencias.
El tamaño de un archivo GGUF no es su requisito máximo de memoria. Los tensores del modelo forman la base, mientras que la caché KV añade memoria para el contexto activo y las secuencias. Los búferes de cómputo, los adaptadores y los proyectores multimodales añaden sobrecarga. Un modelo borrador u otros modelos residentes consumen más capacidad, y el sistema operativo necesita margen. Los contextos más largos y más secuencias concurrentes pueden, por tanto, aumentar considerablemente el uso de memoria. Si el modelo no cabe, resuelva primero el problema de dimensionamiento antes de comparar runtimes.
llama.cpp expone directamente la asignación de hilos, los tamaños de contexto y de lote, y los tipos de caché KV. La ubicación de dispositivos y de capas en GPU, la división entre múltiples GPU y las rutas especulativas también siguen siendo decisiones del operador. Ollama automatiza más, pero aun así expone el contexto activo, las solicitudes paralelas, la residencia del modelo y la programación de la GPU. Flash Attention y los controles de caché KV siguen disponibles mediante configuración, Modelfiles u opciones de API. Esos controles solo son útiles cuando tiene un motivo para ajustarlos.
El soporte de hardware también se resiste a una puntuación simple. Ollama empaqueta las rutas principales de CPU y GPU, con Metal, CUDA, ROCm y Vulkan como ejemplos. La matriz de compilación más amplia de llama.cpp llega a objetivos habituales e inusuales. Un backend documentado puede no estar maduro ni incluirse en todos los binarios precompilados. El rendimiento depende de la compilación, el controlador, el dispositivo y de lo bien que el modelo utilice los kernels correspondientes.
⚠️ Advertencia: Un nombre de modelo compartido o una sola captura de tokens por segundo no es una comparación controlada. Los artefactos o plantillas distintos cambian el trabajo medido; el contexto, los valores predeterminados y el estado de calentamiento cambian las condiciones de la prueba.
Para una comparación justa de rendimiento entre Ollama y llama.cpp:
- Use exactamente el mismo artefacto del modelo o la misma suma de comprobación, cuantización, adaptador y proyector multimodal cuando corresponda.
- Haga coincidir la plantilla de chat y los tokens del prompt renderizado, la longitud de salida solicitada y el comportamiento del muestreo.
- Haga coincidir el contexto, la representación de la caché KV, la configuración de lote y microlote, las ranuras paralelas y las condiciones de cola o concurrencia.
- Haga coincidir la versión y compilación del software, el backend, los controladores, la selección de dispositivos y el comportamiento de descarga o división en GPU.
- Informe por separado la carga en frío, el procesamiento del prompt en caliente y la generación de tokens.
- Repita la prueba con la concurrencia y la forma de solicitud que usará la aplicación real.
Varias GPU o una cuantización de menor número de bits no garantizan una inferencia más rápida. Las interconexiones y el movimiento de memoria pueden limitar las configuraciones con varias GPU, mientras que los kernels y la forma de las solicitudes pueden cambiar el resultado. Elija una configuración que quepa con margen y, luego, mida la fase y el patrón que usará su aplicación.
APIs e integración: ¿primero el servicio o primero el kit de herramientas?
Ollama está diseñado principalmente como un servicio de modelos de larga duración. Proporciona una API nativa, es decir, su propia superficie de solicitudes y respuestas, además de clientes oficiales para Python y JavaScript. Esto es adecuado para un plugin o una herramienta interna que necesita un endpoint HTTP local y estable. Ollama adquiere y carga el modelo, y deja que la aplicación envíe las solicitudes.
Ollama documenta algunas rutas compatibles con OpenAI y con Anthropic. El llama-server actual documenta ambos estilos junto con endpoints operativos nativos. Estas capas permiten que los clientes existentes usen una forma de API familiar con un runtime diferente.
Un cambio de URL base de estilo OpenAI que haya sido probado puede ahorrar trabajo de integración; no resuelve por sí solo el soporte de funciones. La salida estructurada y el uso de herramientas dependen de la ruta, el modelo y la plantilla de prompt. Los embeddings o la entrada multimodal también pueden depender de la compilación y del cliente. Pruebe estas capacidades como parte de la aplicación, no como casillas de verificación del runtime.
📝 Nota: “Compatible” significa rutas y campos seleccionados. Pruebe primero el endpoint exacto y los campos de la solicitud. Después verifique el comportamiento del streaming y los formatos de llamadas a herramientas, seguidos de cualquier manejo de imágenes, recuentos de tokens, campos de respuesta y errores que utilice su aplicación.
llama-server es una opción de servicio seria, no un envoltorio de demostración. Su interfaz web proporciona una superficie para el navegador, mientras que la decodificación paralela y el batching continuo permiten un servicio compartido. El enrutamiento y la carga de modelos añaden control del ciclo de vida a nivel de servidor; las rutas de compatibilidad y los endpoints operativos nativos completan la interfaz. Puede ser la mejor capa HTTP cuando los controles directos importan más que el ciclo de vida gestionado de Ollama.
Cuando HTTP no es suficiente, la biblioteca de estilo C de llama.cpp puede incrustar la inferencia dentro de su proceso. La aplicación controla la inicialización y el cierre, mientras que los ajustes de bajo nivel permanecen cerca de su código. Ollama normalmente es un servicio separado. Elija llama.cpp cuando la inferencia deba distribuirse dentro de la aplicación; elija Ollama cuando sea preferible un endpoint separado.
De un portátil a un servidor privado siempre activo
Hay tres límites de ejecución.
- Inferencia en el dispositivo se ejecuta en el portátil o la estación de trabajo que realiza la solicitud.
- Autoalojamiento privado remoto se ejecuta en un servidor controlado por la organización; puede preservar el control operativo, pero las solicitudes cruzan una red y la ejecución no es local al dispositivo.
- Inferencia en la nube alojada por el proveedor se ejecuta en la infraestructura del proveedor.
Esta distinción es importante porque los modelos etiquetados para la nube de Ollama se ejecutan en su nube incluso cuando un cliente localhost envía la solicitud. «Usar Ollama» no demuestra la ejecución local. Las implementaciones estrictamente locales deben excluir o desactivar la funcionalidad en la nube según la documentación vigente.
Ambos proyectos tienen por defecto una exposición de red solo local. Ollama se vincula localmente, y su API no tiene autenticación integrada. llama-server también usa loopback por defecto (accesible solo desde el mismo host) y ofrece opciones de clave API y TLS. Ninguno de los valores predeterminados constituye un límite completo para una implementación pública.
⚠️ Advertencia: La API local de Ollama no tiene autenticación integrada, y las claves de marcador de posición aceptadas por los ejemplos de compatibilidad no la protegen. Nunca exponga directamente el endpoint predeterminado sin procesar a internet público.
Antes de hacer que cualquiera de los endpoints sea accesible de forma remota, use estos controles como barrera mínima:
- Una dirección de enlace deliberada y un límite de red privada o VPN.
- Autenticación en el servidor o en una puerta de enlace autenticada.
- TLS para el transporte de red.
- Límites de firewall, CORS, tamaño de solicitud, concurrencia y recursos.
- Supervisión de procesos, actualizaciones controladas, comprobaciones de estado y monitorización.
- Registro, retención y manejo de datos conscientes de la privacidad que eviten filtrar indicaciones, respuestas o credenciales.
Dimensione el modelo y la cuantización antes de considerar capacidad de GPU alquilada. Tenga en cuenta el contexto activo y la concurrencia para estimar la VRAM y el margen operativo. Si un portátil no puede cumplir el objetivo de rendimiento o disponibilidad, la infraestructura de GPU alquilada compatible con LLM, con AlexHost como un ejemplo, se convierte en una opción, no en un atajo para evitar el dimensionamiento.
Las declaraciones de privacidad de los proveedores no son auditorías independientes. Documente dónde se ejecuta la inferencia y por qué redes cruzan las solicitudes. Registre quién administra los sistemas y qué almacenamiento o registros conservan. Ese registro define el límite de privacidad con más claridad que el logotipo del entorno de ejecución.
¿Cuál debería elegir? Recomendaciones por caso de uso
Estas recomendaciones describen el ajuste a la carga de trabajo, no el nivel de habilidad. La conveniencia puede ser un requisito de ingeniería; el control directo puede ser una sobrecarga innecesaria. La elección cambia cuando un requisito específico cruza el límite de abstracción.
Primer experimento local o herramienta para desarrolladores: Elija Ollama cuando la configuración rápida sea importante y desee modelos por nombre. Su API lista ofrece a la herramienta una interfaz estable sin trabajo de gestión del ciclo de vida que no ayude a la evaluación o a la integración. Elija llama.cpp en su lugar si necesita un backend no compatible, una compilación exacta o una configuración de bajo nivel no expuesta.
Inferencia personalizada reproducible o aplicación integrada: Elija llama.cpp cuando el producto deba controlar el artefacto y la compilación exactos. También controla directamente la inicialización y la configuración de ejecución, lo cual es importante cuando la inferencia vive dentro de la aplicación. Elija Ollama en su lugar si un servicio HTTP separado y el control a nivel de Modelfile satisfacen completamente las necesidades del producto.
Hardware limitado o inusual, o máxima optimización: Comience con llama.cpp cuando su matriz de backends más amplia o su ubicación explícita resuelva un requisito concreto. Primero verifique que el modelo quepa. Elija Ollama cuando sea compatible bien con el hardware y la optimización directa añadiría mantenimiento sin un control útil ni una mejora medida.
Servicio privado accesible para el equipo: Ollama suele ser el punto de partida de menor fricción para el ciclo de vida y el servicio, siempre que el operador añada un límite de red autenticado. Considere llama-server cuando sean más importantes la clave de API nativa, los controles directos de servicio o la optimización del backend. Descarte cualquiera de las dos opciones si el equipo no puede cumplir los requisitos de disponibilidad continua indicados anteriormente.
Use ambos: Mantenga Ollama y llama.cpp independiente como puntos de entrada y dominios de ciclo de vida separados. Las aplicaciones pueden seleccionar un endpoint probado para el servicio rutinario o para experimentos controlados, pero no pueden asumir un comportamiento de API idéntico. Cada runtime puede mantener su propio almacenamiento de modelos, puerto y proceso; si ambos tienen modelos cargados, pueden competir por la RAM o la VRAM. Ollama no utiliza su servicio llama.cpp separado.
La matriz siguiente resume esas opciones. No cuente las filas como puntos: un requisito estricto puede pesar más que todas las comodidades restantes.
| Área de decisión | Ollama | llama.cpp |
|---|---|---|
| 🚀 Inicio más rápido | Ruta integrada de instalación, modelo y servicio | Permanecen visibles más opciones de obtención, compilación e inicio |
| 🔄 Ciclo de vida del modelo | Descargas por nombre, almacenamiento gestionado, Modelfiles, residencia y programación | GGUF directo o caché de Hugging Face más controles de router, preajustes y carga; menos prescriptivo de extremo a extremo |
| 🎛️ Optimización detallada | Valores predeterminados automatizados con configuración y controles de API seleccionados | Control directo más amplio sobre compilaciones, dispositivos, ubicación, cachés y lotes |
| 🧩 Incrustación en proceso | Normalmente se consume como servicio separado | La biblioteca de estilo C es el ajuste directo más sólido |
| 🌐 Servicio de API | API nativa más capas de compatibilidad limitadas | llama-server con compatibilidad limitada y rutas operativas nativas |
| ⚙️ Flexibilidad de backend | Soporte empaquetado y seleccionado | Matriz de backends en tiempo de compilación más amplia, con advertencias de compilación y madurez |
| 🛠️ Responsabilidad operativa | Ciclo de vida integrado de modelo/servicio; se requiere autenticación externa más allá del uso local | Propiedad explícita del servidor y opciones nativas de clave/TLS; aun así se requiere endurecimiento |
| 🎯 Carga de trabajo de mejor ajuste | Servicio de modelo local o privado repetible y cotidiano | Inferencia integrada, experimental, específica de hardware o muy optimizada |
Bottom Line
Los dos caminos del inicio parecían contradictorios porque asignan la propiedad de forma distinta. Elija Ollama cuando el flujo de trabajo integrado sea en sí mismo la función. Elija llama.cpp cuando el control directo sobre la inferencia sea la función.
Si no está seguro, confirme que el modelo y la cuantización se ajustan al hardware. Revise el costo de memoria del contexto previsto y luego comience con Ollama. Pase a llama.cpp independiente, o añádalo, solo por un requisito concreto de bajo nivel: un backend o compilación específicos, incrustación en el mismo proceso, o una colocación y ajuste más finos.