Ticket öffnen
 +373 79 600002
 Telegramm Live Chat
 Häufige Fragen
 Deutsch
 English
 Русский
 Română
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 bei allen Hosting-Diensten


Ollama vs llama.cpp im Jahr 2026: Welche lokale LLM-Laufzeitumgebung sollten Sie verwenden?
Sie möchten ein Open-Weight-LLM auf Hardware betreiben, die Sie selbst kontrollieren: einem Laptop, einer Workstation, einem Heimserver oder einem privaten Remote-Server. Ein Leitfaden verweist auf Ollama und ein Modell, das Sie einfach über seinen Namen herunterladen können. Ein anderer verweist auf llama.cpp, eine Modelldatei und deutlich mehr Steuerungsmöglichkeiten.
Dann widersprechen sich die Aussagen. Ollama wird als einfacher bezeichnet, llama.cpp als schneller; das eine wird als praxistauglicher, das andere als leistungsfähiger dargestellt. Diese Aussagen vergleichen oft unterschiedliche Modelle, Einstellungen, Hardware oder Ebenen des Software-Stacks.
Die entscheidende Frage ist nicht, welcher Name gewinnt, sondern wie viel des Arbeitsablaufs beim Ausführen von Modellen das Tool übernehmen soll – und wie viel davon Ihr Einsatzzweck offenlegen muss.
Die Antwort in 60 Sekunden
Wählen Sie Ollama, wenn Sie einen integrierten Modell-Runner und Dienst möchten. Einrichtung, Beschaffung benannter Modelle und Speicherung folgen einem gemeinsamen Arbeitsablauf. Standardeinstellungen und Anpassungsrezepte decken die routinemäßige Konfiguration ab, während eine fertige lokale API Anwendungen eine stabile Schnittstelle bietet. Dies ist in der Regel der sauberere Standard für Experimente, Coding-Tools und interne Hilfsprogramme, die keine Laufzeitverwaltung auf niedriger Ebene benötigen.
Wählen Sie llama.cpp, wenn Sie direkte Kontrolle über die Inferenz benötigen. Sie können den Build und das Hardware-Backend auswählen, das genaue Modellartefakt festlegen und Entscheidungen zu Prozess, Speicher und Feinabstimmung verwalten. Es eignet sich auch für Software, die Inferenz einbetten muss, anstatt sie von einem separaten Dienst zu beziehen.
Keines von beiden ist ein universeller Gewinner: Ollama kann die routinemäßige Bereitstellung übernehmen, während eigenständiges llama.cpp kontrollierte Experimente abdeckt. Bevor Sie die Leistung vergleichen, prüfen Sie, ob Modell, Quantisierung, Kontext und Hardware zueinander passen. Der restliche Vergleich testet Arbeitsablauf, Hardware, Integration und Bereitstellung – nicht einen erfundenen Benchmark.
Ollama und llama.cpp sitzen auf unterschiedlichen Ebenen
Inferenz bedeutet, ein bereits trainiertes Modell auszuführen, um eine Ausgabe zu erzeugen; eine Inferenz-Engine führt diese Berechnung durch. llama.cpp ist eine portable C/C++-Bibliothek und ein Toolkit. Ihre Kernbibliothek steht neben Kommandozeilenwerkzeugen und llama-server, der eine Web-UI enthält. Außerdem bietet es Konvertierungs- und Quantisierungswerkzeuge sowie die offizielle llama-Distribution, daher ist llama.cpp nicht nur auf die CLI beschränkt.
Ollama ist ein Modell-Runner und Dienst, der um die Inferenz einen eigenwilligen Workflow legt. Er verwaltet Modellbeschaffung und -speicherung, wendet Vorlagen oder Modelfiles an und plant die Inferenz. API-Zugriff und ausgewählte Backends gehören zum selben Dienst. Ollama ist daher nicht bloß eine grafische Hülle; der Modelllebenszyklus steht im Mittelpunkt des Produkts.
Eine vereinfachte Schichtenkarte
| Pfad | Geschichtetes Denkmodell |
|---|---|
| Ollama-Pfad | Anwendung oder CLI → Ollama-API, Modelllebenszyklus, Vorlagen und Planung → gebündelte Inferenzkomponente (aktueller GGUF-Pfad: angepinntes llama-server) → ausgewähltes Hardware-Backend |
| llama.cpp-Pfad | Anwendung, CLI oder Web-UI → llama.cpp-Bibliothek oder llama-server → direkt ausgewählter Build/Backend und Laufzeitsteuerung → Hardware |
Vereinfachtes Denkmodell – keine vollständige Architektur. Verständliche Beschreibung: Ollama fügt Modellverwaltung und Dienst-Orchestrierung oberhalb der gebündelten Inferenzkomponenten hinzu, während llama.cpp seine Bibliothek und seinen Server näher an den Hardware-Steuerungen bereitstellt.
Stand 5. September 2026 startet der veröffentlichte GGUF-Pfad von Ollama unterhalb seiner Dienstschicht ein gebündeltes, angepinntes llama-server des Upstream-Projekts. Vereinfacht gesagt stellt llama.cpp die Engine und die Werkstattsteuerungen bereit, während Ollama diese Mechanik in ein fertig zu fahrendes Fahrzeug mit einem einfacheren Armaturenbrett verpackt. Die Analogie erklärt die Abstraktion, nicht jede Komponente oder jeden Modellpfad.
📝 Hinweis: Das Bündeln eines angepinnten llama-server macht Ollama nicht identisch mit dem Upstream-llama.cpp. Ollama liefert weiterhin eigene Standardwerte, Vorlagen, Planung und die öffentliche API. Nicht-GGUF- oder experimentelle Pfade können ebenfalls abweichen.
Sechs Schlüsselbegriffe, die den Vergleich erleichtern
Sie benötigen kein vollständiges Glossar zur Inferenz-Technik. Diese sechs Begriffe decken die Entscheidungen zu Modell, Speicher und Hardware ab, die noch folgen.
| Begriff | Bedeutung in einfachen Worten | Warum er diese Wahl beeinflusst |
|---|---|---|
| 📦 GGUF | Ein auf Inferenz ausgerichteter binärer Container für Modell-Tensoren und Metadaten, zentral für das llama.cpp-Ökosystem. GGUF legt selbst keine Quantisierungsstufe fest. | Es ist das wichtigste portable Artefakt, das direkt von llama.cpp verwendet wird, und ein unterstützter Importpfad für Ollama. |
| 🗜️ Quantisierung | Darstellung von Modell-Tensoren mit geringerer Genauigkeit, was in der Regel Speicher- und Arbeitsspeicherbedarf senkt. Auswirkungen auf Qualität und Geschwindigkeit variieren je nach Methode, Modell, Backend und Arbeitslast. | Die gewählte Quantisierung kann darüber entscheiden, ob ein Modell passt und gut läuft, unabhängig von der Laufzeitumgebung. |
| 📏 Kontextlänge | Das aktive Token-Budget, das dem Modell für Anweisungen, Eingaben, Verlauf und Ausgaben zur Verfügung steht. | Größere aktive Kontexte verbrauchen mehr Speicher, daher ist ein beworbenes Maximum kein kostenloser Spielraum. |
| ⚙️ Backend | Der hardwarespezifische Rechenpfad, etwa CUDA, Metal, HIP/ROCm oder Vulkan. | Laufzeit- und Build-Unterstützung für das beste Backend des Systems bestimmt, ob die Beschleunigung gut funktioniert. |
| 🚀 GPU-Offloading | Das Auslagern geeigneter Modellschichten oder Berechnungen auf eine GPU, statt die gesamte Arbeit auf der CPU zu belassen. | Umfang und Platzierung des Offloadings können Speichernutzung und Geschwindigkeit stärker beeinflussen als der Dienst-Wrapper. |
| 🗃️ KV-Cache | Gespeicherter Aufmerksamkeitszustand, der es dem Modell erlaubt, frühere Kontexte während der Generierung wiederzuverwenden. Sein Umfang wächst mit aktivem Kontext und Sequenzen. | Lange Kontexte und gleichzeitige Nutzer können neben der Modelldatei selbst erheblichen RAM oder VRAM beanspruchen. |
Die GGUF-Spezifikation beschreibt das Artefakt; die Quantisierung verändert, wie seine Tensoren dargestellt werden. Kontext und KV-Cache bestimmen den Speicherbedarf, während Backend und Offloading festlegen, wo die Berechnung stattfindet.
Festlegen der Kriterien vor dem Vergleich
Beide Projekte können Open-Weight-Modelle auf benutzergesteuerter Hardware ausführen und Inferenz über eine API bereitstellen. Diese gemeinsamen Fähigkeiten entscheiden den Vergleich nicht. Verwenden Sie durchgehend dieselben acht Fragen:
- Wie viel Einrichtungsaufwand sind Sie bereit zu akzeptieren, bevor die erste sinnvolle Anfrage funktioniert?
- Soll der Dienst den Modelllebenszyklus verwalten, oder sollten Sie die genauen Dateien und Startoptionen selbst kontrollieren?
- Wie viel Kontrolle auf niedriger Ebene benötigt die Arbeitslast tatsächlich?
- Welche Option passt am besten zu Hardware und Backend dieses Rechners?
- Benötigt die Anwendung einen HTTP-Dienst oder eine engere In-Process-Integration?
- Welche betriebliche Sicherheit muss den Endpunkt umgeben?
- Wer übernimmt Wartung, Updates und Reproduzierbarkeit?
- Wird die Inferenz auf dem Gerät, auf einem entfernten privaten Server oder in einer Vendor-Cloud ausgeführt?
Leistungsvergleiche erfordern das exakte Modellartefakt – die konvertierte Datei und die ausgeführten Metadaten – und nicht nur denselben Familiennamen. Gleichen Sie die gerenderte Vorlage und den aktiven Kontext ab und stimmen Sie anschließend Backend, Offload-Verhalten und Hardware aufeinander ab. Verwenden Sie dieselbe Softwareversion sowie identische Batching- und Concurrency-Bedingungen. Mit diesem festgelegten Bewertungsraster beginnen wir mit dem auffälligsten Unterschied: dem täglichen Arbeitsablauf.
Täglicher Arbeitsablauf: Verwaltete Bequemlichkeit versus explizite Kontrolle
Die Ersteinrichtung zeigt den Unterschied:
- Ollama bietet fertige Installationen für macOS, Windows und Linux, die in einen Dienst-Workflow mit weniger frühen Entscheidungen münden
- Die offizielle llama-Distribution, Paketmanager und vorgefertigte Releases bieten zugängliche llama.cpp-Wege
- Container und Quellcode-Builds bieten mehr Kontrolle, wenn gepackte Optionen nicht passen
Es geht nicht mehr um „freundlicher Installer versus alles selbst kompilieren“, aber llama.cpp bietet trotzdem mehr Entscheidungen bei Beschaffung, Build und Start.
Nach der Installation wird die Trennung bei der Modellverwaltung konkret. Ollamas benannte Bibliothek und das Pull-on-Run-Verhalten vereinfachen die Beschaffung, während verwalteter Speicher, Lebenszyklusbefehle und Standardeinstellungen wiederkehrende Wartungsaufgaben übernehmen. llama.cpp startet mit einem bestimmten GGUF-Artefakt, obwohl aktuelle Werkzeuge kompatible Hugging-Face-Modelle mit -hf abrufen und zwischenspeichern können; der Server/Router kann Modelle außerdem erkennen und das Laden verwalten. Ollamas Vorteil besteht nicht einfach darin, Modellverwaltungsfunktionen zu haben, sondern diese in einer einzigen Routine zusammenzuführen.
Für die Anpassung ist ein Modelfile Ollamas deklaratives Rezept. Es legt das Basismodell und die Parameter fest, definiert das Prompt- oder Systemverhalten und bindet Adapter ein. Bei llama.cpp beginnt Wiederholbarkeit mit einem exakten GGUF und Build; Backend und Startkonfiguration fixieren mehr vom zugrunde liegenden Mechanismus.
Ollama ist nicht auf seine Modellbibliothek beschränkt. Sein Import-Workflow akzeptiert unterstützte GGUF-Dateien sowie Safetensors-Modelle oder Adapter, vorbehaltlich Architektur- und Konvertierungsgrenzen. GGUF bleibt llama.cpps zentportables Format, doch die offizielle Tooling übernimmt auch Beschaffung und Zwischenspeicherung.
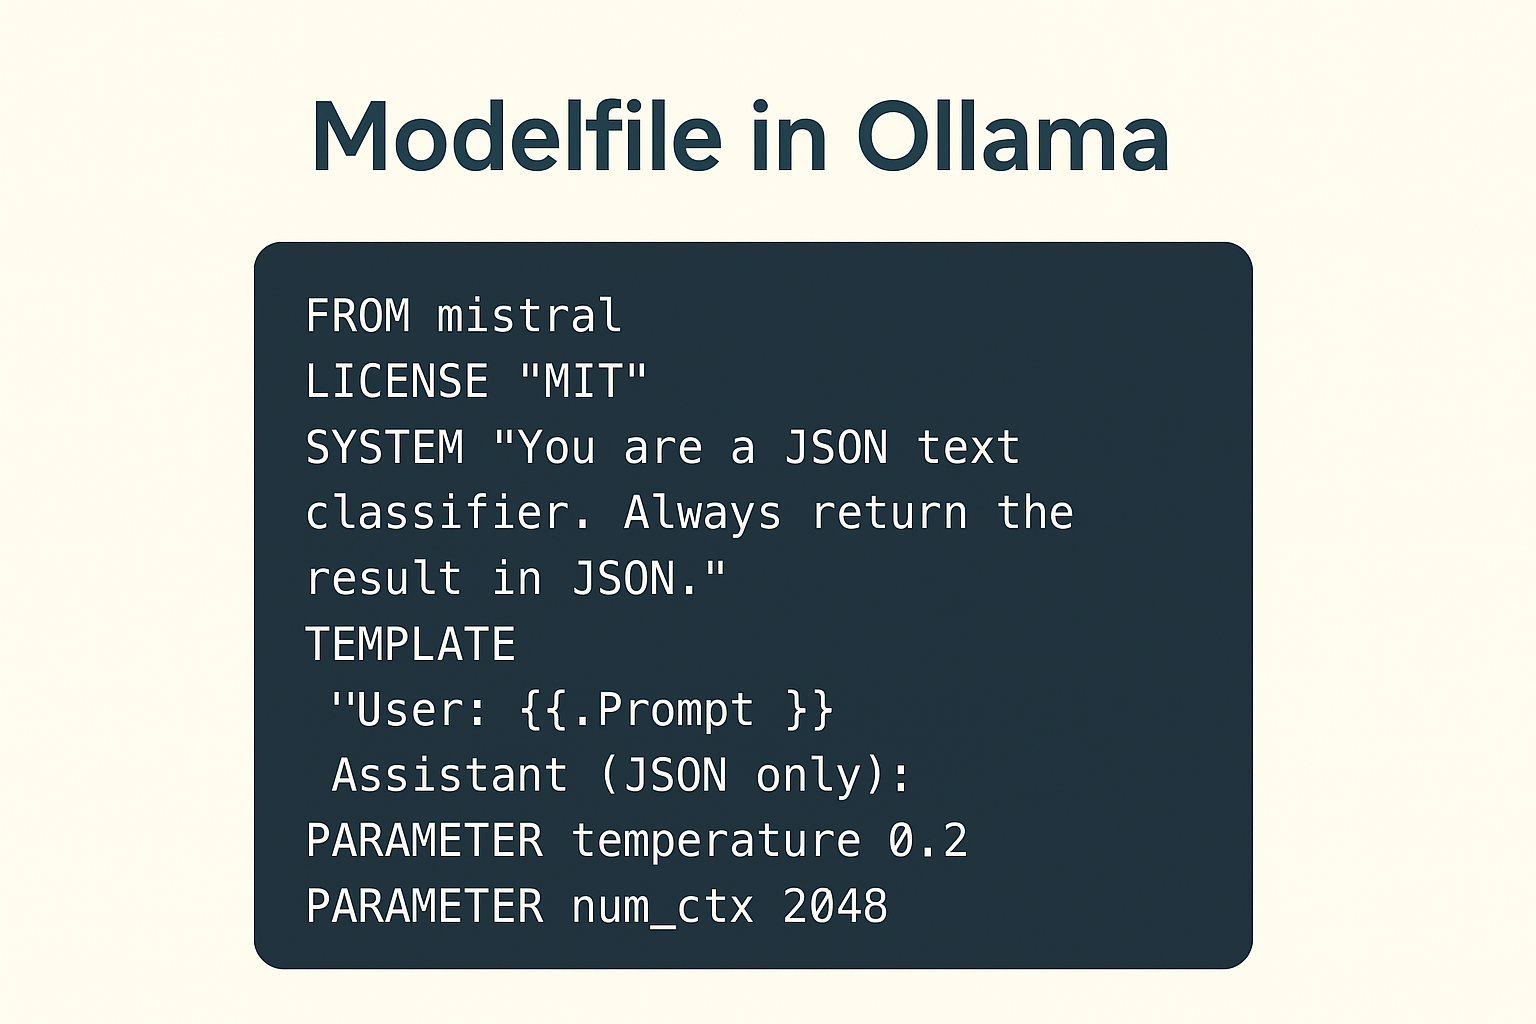
Updates und Wiederholbarkeit nehmen unterschiedliche Formen an. Ollama kann eine alltägliche Konfiguration über ein benanntes Modell, ein Modelfile und verwaltete Standardwerte reproduzieren, obwohl sich interne Revisionen mit einem Update ändern können. llama.cpp erlaubt Betreibern, Build, Artefakt und Einstellungen zu fixieren, sie müssen diese Details jedoch selbst pflegen. Der Zielkonflikt besteht zwischen administrativem Aufwand und Transparenz: Standardwerte reduzieren wiederkehrende Entscheidungen, während explizite Einstellungen spezialisiertes Verhalten leichter nachvollziehbar machen.
Leistung, Speicher und Hardware: Warum es keinen universellen Gewinner gibt
Eine Laufzeitumgebung kann schnell laden, aber langsam generieren, oder einen langen Prompt effizient verarbeiten, dabei aber bei gleichzeitiger Generierung Schwierigkeiten haben. Kaltstart, Prompt-Verarbeitung und Token-Generierung sind getrennte Phasen. Eine einzelne Bezeichnung als „schneller“ verdeckt die gemessene Phase und die Frage, ob diese der realen Arbeitslast entspricht.
Auch der Prompt muss unterhalb des sichtbaren Textes übereinstimmen. Zwei Dienste können dieselbe Nachricht erhalten, aber unterschiedliche Chat-Vorlagen, Rollenmarkierungen oder Sondertokens verwenden. Dadurch ändern sich die Eingabetokens und der Aufwand vor der Generierung. Sampling-Verhalten und Ausgabelänge verursachen weitere Unterschiede.
Die Dateigröße einer GGUF-Datei entspricht nicht ihrem Spitzenspeicherbedarf. Die Modell-Tensoren bilden die Basis, während der KV-Cache zusätzlichen Speicher für den aktiven Kontext und die Sequenzen benötigt. Compute-Puffer, Adapter und multimodale Projektoren verursachen weiteren Aufwand. Ein Draft-Modell oder andere residente Modelle beanspruchen zusätzliche Kapazität, und das Betriebssystem benötigt Reserven. Längere Kontexte und mehr gleichzeitige Sequenzen können den Speicherbedarf daher erheblich erhöhen. Passt das Modell nicht in den Speicher, sollte das Dimensionierungsproblem vor dem Vergleich der Laufzeitumgebungen gelöst werden.
llama.cpp stellt Thread-Platzierung, Kontext- und Batch-Größen sowie KV-Cache-Typen direkt zur Verfügung. Geräte- und GPU-Layer-Platzierung, Multi-GPU-Aufteilung und Speculative-Pfade bleiben ebenfalls Entscheidungen des Betreibers. Ollama automatisiert mehr, stellt aber weiterhin aktiven Kontext, parallele Anfragen, Modell-Residenz und GPU-Scheduling ein. Flash Attention und KV-Cache-Steuerungen sind über Konfiguration, Modelfiles oder API-Optionen verfügbar. Diese Steuerungen sind nur dann nützlich, wenn es einen Grund gibt, sie anzupassen.
Auch die Hardware-Unterstützung lässt sich nicht einfach bewerten. Ollama bietet gängige CPU- und GPU-Pfade, etwa mit Metal, CUDA, ROCm und Vulkan. Der breitere Build-Katalog von llama.cpp umfasst gängige und ungewöhnliche Zielplattformen. Ein dokumentiertes Backend ist möglicherweise nicht ausgereift oder nicht in jeder vorkompilierten Binärdatei enthalten. Die Leistung hängt vom Build, Treiber, Gerät und davon ab, wie gut das Modell die jeweiligen Kernel nutzt.
⚠️ Warnung: Ein gemeinsamer Modellname oder ein einzelner Screenshot mit Tokens pro Sekunde ist kein kontrollierter Vergleich. Unterschiedliche Artefakte oder Vorlagen verändern die gemessene Arbeitslast; Kontext, Standardwerte und Aufwärmzustand verändern die Testbedingungen.
Für einen fairen Leistungsvergleich zwischen Ollama und llama.cpp:
- Verwenden Sie exakt dasselbe Modellartefakt bzw. dieselbe Prüfsumme, Quantisierung, denselben Adapter und gegebenenfalls denselben multimodalen Projektor.
- Stimmen Sie die Chat-Vorlage und die gerenderten Prompt-Tokens, die angeforderte Ausgabelänge und das Sampling-Verhalten ab.
- Stimmen Sie Kontext, KV-Cache-Darstellung, Batch- und Microbatch-Einstellungen, parallele Slots sowie Warteschlangen- bzw. Nebenläufigkeitsbedingungen ab.
- Stimmen Sie Softwareversion und Build, Backend, Treiber, Geräteauswahl sowie GPU-Offload- bzw. Aufteilungsverhalten ab.
- Erfassen Sie Kaltstart, Prompt-Verarbeitung im Warmzustand und Token-Generierung getrennt voneinander.
- Wiederholen Sie den Test unter der Nebenläufigkeit und dem Anfrageaufbau, den die reale Anwendung verwenden wird.
Mehrere GPUs oder niedriger quantisierte Modelle garantieren keine schnellere Inferenz. Verbindungen und Speicherbewegungen können Multi-GPU-Setups begrenzen, während Kernel und Anfrageaufbau das Ergebnis verändern können. Wählen Sie eine Konfiguration, die mit ausreichender Reserve passt, und messen Sie anschließend die Phase und das Muster, die Ihre Anwendung tatsächlich verwenden wird.
APIs und Integration: Service zuerst oder Toolkit zuerst?
Ollama ist in erster Linie als langlebiger Modelldienst konzipiert. Es bietet eine native API – seine eigene Anfrage- und Antwortschnittstelle – sowie offizielle Python- und JavaScript-Clients. Das eignet sich für ein Plugin oder ein internes Tool, das einen stabilen lokalen HTTP-Endpunkt benötigt. Ollama lädt das Modell und lädt es in den Speicher, während die Anwendung die Anfragen sendet.
Ollama dokumentiert ausgewählte OpenAI-kompatible und Anthropic-kompatible Routen. Das aktuelle llama-server dokumentiert beide Stile neben nativen Betriebsendpunkten. Diese Ebenen ermöglichen es bestehenden Clients, eine vertraute API-Struktur mit einer anderen Laufzeitumgebung zu verwenden.
Eine getestete Änderung der Basis-URL im OpenAI-Stil kann Integrationsaufwand sparen; sie klärt jedoch nicht die Funktionsunterstützung. Strukturierte Ausgaben und Tool-Nutzung hängen von der Route, dem Modell und der Prompt-Vorlage ab. Embeddings oder multimodale Eingaben können ebenfalls vom Build und Client abhängen. Testen Sie diese Fähigkeiten als Teil der Anwendung, nicht als reine Laufzeit-Checkliste.
📝 Hinweis: „Kompatibel“ bezieht sich auf ausgewählte Routen und Felder. Testen Sie zuerst den genauen Endpunkt und die Anfragefelder. Überprüfen Sie anschließend das Streaming-Verhalten und die Formate der Tool-Aufrufe, gefolgt von der Bildverarbeitung, Token-Zählungen, Antwortfeldern und Fehlern, die Ihre Anwendung verwendet.
llama-server ist eine ernstzunehmende Serving-Option und kein Demo-Wrapper. Seine Web-UI bietet eine Browseroberfläche, während paralleles Decoding und kontinuierliches Batching gemeinsames Serving unterstützen. Modell-Routing und -Laden ermöglichen eine Lebenszyklussteuerung auf Serverebene; Kompatibilitätsrouten und native Betriebsendpunkte vervollständigen die Schnittstelle. Er kann die bessere HTTP-Schicht sein, wenn direkte Steuerungsmöglichkeiten wichtiger sind als der verwaltete Lebenszyklus von Ollama.
Wenn HTTP nicht ausreicht, kann die C-artige Bibliothek von llama.cpp Inferenz direkt in Ihren Prozess einbetten. Die Anwendung steuert Initialisierung und Beendigung, während Low-Level-Einstellungen nah am eigenen Code bleiben. Ollama läuft normalerweise als separater Dienst. Wählen Sie llama.cpp, wenn die Inferenz in der Anwendung ausgeliefert werden muss; wählen Sie Ollama, wenn ein separater Endpunkt vorzuziehen ist.
Vom Laptop zum immer verfügbaren privaten Server
Es gibt drei Ausführungsgrenzen.
- Inferenz auf dem Gerät läuft auf dem Laptop oder der Workstation, die die Anfrage stellt.
- Privates Self-Hosting auf einem Remote-Server läuft auf einem von der Organisation kontrollierten Server; es kann die betriebliche Kontrolle bewahren, aber Anfragen überqueren ein Netzwerk und die Ausführung findet nicht lokal am Gerät statt.
- Vom Anbieter gehostete Cloud-Inferenz läuft auf der Infrastruktur des Anbieters.
Diese Unterscheidung ist wichtig, da Ollamas mit Cloud-Tag versehene Modelle in dessen Cloud laufen, selbst wenn ein Localhost-Client die Anfrage sendet. „Ollama zu verwenden“ beweist keine lokale Ausführung. Streng lokale Deployments müssen Cloud-Funktionen gemäß der aktuellen Dokumentation ausschließen oder deaktivieren.
Beide Projekte sind standardmäßig auf rein lokale Netzwerkfreigabe eingestellt. Ollama bindet sich lokal, und seine API verfügt über keine integrierte Authentifizierung. llama-server ist ebenfalls standardmäßig auf Loopback eingestellt – nur vom selben Host erreichbar – und bietet API-Schlüssel- und TLS-Optionen. Keine der Standardeinstellungen ist eine vollständige öffentliche Deployment-Grenze.
⚠️ Warnung: Die lokale API von Ollama verfügt über keine integrierte Authentifizierung, und Platzhalter-Schlüssel, die von Kompatibilitätsbeispielen akzeptiert werden, sichern sie nicht ab. Setzen Sie den rohen Standard-Endpunkt niemals direkt dem öffentlichen Internet aus.
Bevor Sie einen der beiden Endpunkte aus der Ferne erreichbar machen, verwenden Sie diese Kontrollen als minimale Hürde:
- Eine bewusst gewählte Bind-Adresse und eine private Netzwerkgrenze oder ein VPN.
- Authentifizierung auf dem Server oder einem authentifizierten Gateway.
- TLS für den Netzwerktransport.
- Firewall-, CORS-, Anfragegrößen-, Parallelitäts- und Ressourcenlimits.
- Prozessüberwachung, kontrollierte Updates, Health Checks und Monitoring.
- Datenschutzbewusstes Logging, Aufbewahrung und Datenverarbeitung, die das Austreten von Prompts, Antworten oder Zugangsdaten verhindern.
Dimensionieren Sie das Modell und die Quantisierung, bevor Sie gemietete GPU-Kapazität in Betracht ziehen. Berücksichtigen Sie aktiven Kontext und Parallelität, um VRAM und Betriebsreserven abzuschätzen. Wenn ein Laptop das Leistungs- oder Verfügbarkeitsziel nicht erreichen kann, wird gemietete LLM-fähige GPU-Infrastruktur – wobei AlexHost ein Beispiel ist – zu einer Option, nicht zu einer Abkürzung um die Dimensionierung herum.
Datenschutzerklärungen von Anbietern sind keine unabhängigen Audits. Dokumentieren Sie, wo die Inferenz läuft und welche Netzwerke Anfragen durchqueren. Halten Sie fest, wer die Systeme administriert und welche Speicher oder Logs aufbewahrt werden. Diese Dokumentation definiert die Datenschutzgrenze klarer als das Logo der Laufzeitumgebung.
Welche sollten Sie wählen? Empfehlungen nach Anwendungsfall
Diese Empfehlungen beschreiben die Eignung für die Arbeitslast, nicht das Kompetenzniveau. Komfort kann eine technische Anforderung sein; direkte Kontrolle kann unnötigen Mehraufwand bedeuten. Die Wahl ändert sich, wenn eine konkrete Anforderung die Abstraktionsgrenze überschreitet.
Erstes lokales Experiment oder Entwicklertool: Wählen Sie Ollama, wenn eine schnelle Einrichtung wichtig ist und Sie Modelle über ihren Namen ansprechen möchten. Seine fertige API bietet dem Tool eine stabile Schnittstelle ohne Lebenszyklus-Aufwand, der weder die Evaluierung noch die Integration unterstützt. Wählen Sie stattdessen llama.cpp, wenn Sie ein nicht unterstütztes Backend, einen exakten Build oder eine nicht offengelegte Low-Level-Einstellung benötigen.
Reproduzierbare individuelle Inferenz oder eingebettete Anwendung: Wählen Sie llama.cpp, wenn das Produkt das exakte Artefakt und den Build selbst verwalten muss. Es steuert außerdem Initialisierung und Laufzeiteinstellungen direkt, was wichtig ist, wenn die Inferenz innerhalb der Anwendung stattfindet. Wählen Sie stattdessen Ollama, wenn ein separater HTTP-Dienst und die Steuerung auf Modelfile-Ebene die Anforderungen des Produkts vollständig erfüllen.
Eingeschränkte oder ungewöhnliche Hardware oder maximale Feinabstimmung: Beginnen Sie mit llama.cpp, wenn seine breitere Backend-Matrix oder die explizite Platzierung eine benannte Anforderung löst. Prüfen Sie zuerst, ob das Modell passt. Wählen Sie Ollama, wenn es die Hardware gut unterstützt und direkte Feinabstimmung zusätzlichen Wartungsaufwand ohne sinnvolle Kontrolle oder messbare Verbesserung bedeuten würde.
Für das Team zugänglicher privater Dienst: Ollama ist in der Regel der reibungsärmere Ausgangspunkt für Lebenszyklus und Bereitstellung, vorausgesetzt, der Betreiber ergänzt eine authentifizierte Netzwerkgrenze. Ziehen Sie llama-server in Betracht, wenn native API-Schlüssel, direkte Serversteuerung oder Backend-Feinabstimmung wichtiger sind. Verwerfen Sie beide Optionen, wenn das Team die oben genannten Dauerbetriebsanforderungen nicht erfüllen kann.
Beides verwenden: Behalten Sie Ollama und eigenständiges llama.cpp als getrennte Einstiegspunkte und Lebenszyklusbereiche bei. Anwendungen können einen getesteten Endpunkt für den Routinebetrieb oder kontrollierte Experimente auswählen, dürfen aber kein identisches API-Verhalten voraussetzen. Jede Laufzeit kann ihren eigenen Modellspeicher, Port und Prozess behalten; wenn beide Modelle geladen haben, können sie um RAM oder VRAM konkurrieren. Ollama nutzt Ihren separaten llama.cpp-Dienst nicht.
Die folgende Matrix fasst diese Entscheidungen zusammen. Zählen Sie die Zeilen nicht als Punkte: Eine harte Anforderung kann jeden Komfortvorteil an anderer Stelle überwiegen.
| Entscheidungsbereich | Ollama | llama.cpp |
|---|---|---|
| 🚀 Schnellster Start | Integrierter Weg für Installation, Modell und Dienst | Mehr Auswahlmöglichkeiten bei Beschaffung, Build und Start bleiben sichtbar |
| 🔄 Modelllebenszyklus | Benannte Pulls, verwalteter Speicher, Modelfiles, Residenz und Planung | Direktes GGUF oder Hugging-Face-Cache plus Router-, Preset- und Ladesteuerung; weniger stark vorgegeben von Anfang bis Ende |
| 🎛️ Granulare Feinabstimmung | Automatisierte Standardwerte mit ausgewählter Konfiguration und API-Steuerung | Breitere direkte Kontrolle über Builds, Geräte, Platzierung, Caches und Batches |
| 🧩 Prozessinterne Einbettung | Wird normalerweise als separater Dienst genutzt | C-Style-Bibliothek ist die stärkere direkte Lösung |
| 🌐 API-Dienst | Native API plus begrenzte Kompatibilitätsschichten | llama-server mit begrenzter Kompatibilität und nativen Betriebsrouten |
| ⚙️ Backend-Flexibilität | Kuratierte paketierte Unterstützung | Breitere Backend-Matrix zur Build-Zeit, mit Hinweisen zu Build und Reife |
| 🛠️ Betriebliche Verantwortung | Integrierter Modell-/Dienstlebenszyklus; externe Authentifizierung über die lokale Nutzung hinaus erforderlich | Explizitere Serververantwortung und native Schlüssel-/TLS-Optionen; Härtung dennoch erforderlich |
| 🎯 Passendste Arbeitslast | Wiederholbarer alltäglicher lokaler oder privater Modelldienst | Eingebettete, experimentelle, hardwarespezifische oder stark abgestimmte Inferenz |
Bottom Line
Die beiden Wege aus der Einleitung wirkten widersprüchlich, weil sie die Verantwortlichkeiten unterschiedlich verteilen. Wählen Sie Ollama, wenn der integrierte Workflow selbst das Feature ist. Wählen Sie llama.cpp, wenn die direkte Kontrolle über die Inferenz das Feature ist.
Wenn Sie unsicher sind, prüfen Sie, ob das Modell und die Quantisierung zur Hardware passen. Berücksichtigen Sie den Speicherbedarf des vorgesehenen Kontexts und starten Sie dann mit Ollama. Wechseln Sie zu eigenständigem llama.cpp oder ergänzen Sie es nur bei einer konkreten Anforderung auf niedriger Ebene: einem bestimmten Backend oder Build, Embedding im Prozess oder feinerer Platzierung und Abstimmung.