Відкритий квиток
 +373 79 600002
 Telegram Онлайн-чат
 Часті запитання
 Українська
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 български
 Polski
 Indonesia
 中文 (中国)









 на всіх хостингових послугах


Ollama проти llama.cpp у 2026: який локальний LLM-рантайм вам варто використовувати?
Вам потрібно запустити LLM з відкритими вагами на обладнанні, яке ви контролюєте: ноутбуці, робочій станції, домашньому сервері або приватному віддаленому сервері. Один посібник рекомендує Ollama та модель, яку можна завантажити за назвою. Інший рекомендує llama.cpp, файл моделі та набагато більше можливостей керування.
Потім твердження суперечать одне одному. Ollama називають простішим, а llama.cpp швидшим; один інструмент подають як практичніший, інший як потужніший. Ці твердження часто порівнюють різні моделі, налаштування, обладнання або рівні програмного стеку.
Корисне питання полягає не в тому, яка назва переможе, а в тому, наскільки великою мірою інструмент має керувати робочим процесом запуску моделі і наскільки вашому навантаженню потрібно, щоб він відкривав доступ до цих можливостей.
Відповідь за 60 секунд
Обирайте Ollama, коли вам потрібен інтегрований сервіс для запуску моделей. Налаштування, отримання потрібних моделей і зберігання працюють в одному робочому процесі. Типові значення за замовчуванням і рецепти кастомізації покривають звичайну конфігурацію, а готовий локальний API надає застосункам стабільний інтерфейс. Це зазвичай кращий вибір за замовчуванням для експериментів, інструментів для програмування та внутрішніх утиліт, яким не потрібне низькорівневе адміністрування середовища виконання.
Обирайте llama.cpp, коли вам потрібен прямий контроль над інференсом. Ви можете вибрати збірку та апаратний бекенд, зафіксувати точний артефакт моделі, а також керувати процесами, пам’яттю та налаштуваннями продуктивності. Він також підходить для програмного забезпечення, яке має вбудовувати інференс, а не отримувати його від окремого сервісу.
Жоден з варіантів не є універсальним переможцем: Ollama може забезпечувати звичайне обслуговування, тоді як окремий llama.cpp підходить для контрольованих експериментів. Перш ніж порівнювати продуктивність, переконайтеся, що модель, квантування, контекст і апаратне забезпечення відповідають один одному. Решта цього порівняння оцінює робочий процес, апаратне забезпечення, інтеграцію та розгортання, а не вигаданий бенчмарк.
Ollama і llama.cpp працюють на різних рівнях
Inference (інференс) означає запуск уже навченої моделі для отримання результату; inference engine (рушій інференсу) виконує це обчислення. llama.cpp — це портативна бібліотека та набір інструментів на C/C++. Її основна бібліотека працює разом із інструментами командного рядка та llama-server, який містить Web UI. Також він надає утиліти для конвертації та квантизації та офіційний дистрибутив llama, тому llama.cpp не обмежується лише CLI.
Ollama — це сервіс і засіб запуску моделей, який додає до інференсу визначений робочий процес. Він керує отриманням і зберіганням моделей, застосовує шаблони або Modelfile та планує інференс. Доступ до API і вибрані бекенди входять до того самого сервісу. Тому Ollama — не просто графічна обгортка; управління життєвим циклом моделей є центральною частиною продукту.
Спрощена карта рівнів
| Шлях | Спрощена модель рівнів |
|---|---|
| Шлях Ollama | Застосунок або CLI → API Ollama, життєвий цикл моделей, шаблони та планування → вбудований компонент інференсу (поточний шлях GGUF: закріплений llama-server) → обраний апаратний бекенд |
| Шлях llama.cpp | Застосунок, CLI або Web UI → бібліотека llama.cpp або llama-server → безпосередньо обрана збірка/бекенд і параметри виконання → апаратне забезпечення |
Спрощена модель — не повна архітектура. Доступний опис: Ollama додає керування моделями та оркестрацію сервісу над вбудованими компонентами інференсу, тоді як llama.cpp надає свою бібліотеку та сервер ближче до апаратних керувань.
Станом на 5 вересня 2026 року, Ollama для випущеного шляху GGUF запускає вбудований, закріплений upstream-llama-server під своїм сервісним рівнем. Для спрощення, llama.cpp надає рушій і «майстерню» керувань, тоді як Ollama упаковує ці механізми в готовий до керування автомобіль із простішою панеллю приладів. Аналогія пояснює абстракцію, а не кожен компонент чи шлях до моделі.
📝 Примітка: Вбудування закріпленого llama-server не робить Ollama ідентичним upstream llama.cpp. Ollama все одно надає власні значення за замовчуванням, шаблони, планування та публічний API. Шляхи не-GGUF або експериментальні можуть відрізнятися.
Шість ключових термінів, що спрощують порівняння
Вам не потрібен повний глосарій з інференс-інжинірингу. Ці шість термінів охоплюють вибір моделі, пам’яті та апаратного забезпечення, що стоять попереду.
| Термін | Значення простими словами | Чому це впливає на вибір |
|---|---|---|
| 📦 GGUF | Бінарний контейнер для інференсу, призначений для тензорів моделі та метаданих, що є основою екосистеми llama.cpp. Сам GGUF не визначає рівень квантизації. | Це основний портативний артефакт, який безпосередньо використовується llama.cpp, а також підтримуваний шлях імпорту для Ollama. |
| 🗜️ Квантизація | Представлення тензорів моделі з меншою точністю, що зазвичай зменшує потребу в сховищі та пам’яті. Вплив на якість і швидкість залежить від методу, моделі, бекенду та навантаження. | Обрана квантизація може визначити, чи поміститься модель і чи працюватиме вона добре, незалежно від рантайму. |
| 📏 Довжина контексту | Активний бюджет токенів, доступний моделі для інструкцій, вхідних даних, історії та виводу. | Більші активні контексти споживають більше пам’яті, тому заявлений максимум не є безкоштовною ємністю. |
| ⚙️ Бекенд | Апаратно-специфічний шлях обчислень, наприклад CUDA, Metal, HIP/ROCm або Vulkan. | Підтримка рантайму та збірки для найкращого бекенду комп’ютера може визначити, чи добре працює прискорення. |
| 🚀 Вивантаження на GPU | Розміщення придатних шарів моделі або обчислень на GPU замість того, щоб виконувати всю роботу на CPU. | Обсяг і розміщення вивантаження можуть змінити використання пам’яті та швидкість сильніше, ніж обгортка сервісу. |
| 🗃️ KV-кеш | Збережений стан уваги, який дозволяє моделі повторно використовувати попередній контекст під час генерації. Його обсяг зростає разом з активним контекстом і кількістю послідовностей. | Довгі контексти та одночасні користувачі можуть споживати значну частину ОЗП або VRAM понад сам файл моделі. |
Специфікація GGUF описує артефакт; квантизація змінює спосіб представлення його тензорів. Контекст і KV-кеш формують обсяг пам’яті, тоді як бекенд і вивантаження визначають, де виконуються обчислення.
Встановіть критерії перед порівнянням
Обидва проєкти можуть запускати моделі з відкритими вагами на апаратному забезпеченні, яке контролює користувач, і надавати інференс через API. Ці спільні можливості не визначають результат порівняння. Використовуйте одні й ті самі вісім запитань протягом усього порівняння:
- Яку складність налаштування ви можете прийняти до першого корисного запиту?
- Чи має сервіс керувати життєвим циклом моделі, чи ви маєте самостійно контролювати точні файли та параметри запуску?
- Наскільки потрібен низькорівневий контроль для вашого навантаження?
- Який варіант має правильну відповідність апаратному забезпеченню та бекенду для цієї машини?
- Чи потрібен застосунку HTTP-сервіс або тісніша інтеграція в межах процесу?
- Яку операційну безпеку необхідно забезпечити навколо кінцевої точки?
- Хто відповідатиме за обслуговування, оновлення та відтворюваність?
- Чи виконуватиметься інференс на пристрої, на віддаленому приватному сервері чи в хмарі постачальника?
Порівняння продуктивності вимагає точного артефакту моделі — конвертованого файлу та метаданих, які запускаються, а не лише однакової назви родини моделей. Зіставте відрендерений шаблон і активний контекст, потім узгодьте бекенд, поведінку вивантаження на GPU та апаратне забезпечення. Використовуйте однакові версії програмного забезпечення, пакетну обробку та умови паралельності. Після фіксації цих критеріїв почніть із найпомітнішої різниці: щоденного робочого процесу.
Щоденний робочий процес: керований зручний режим проти явного контролю
Початкове налаштування показує цю відмінність:
- Ollama пропонує готові інсталятори для macOS, Windows і Linux, що переходять у сервісний робочий процес із меншою кількістю ранніх виборів
- Офіційний дистрибутив llama, менеджери пакетів і готові релізи надають доступні шляхи до llama.cpp
- Контейнери та збірки з вихідного коду додають контролю, коли готові варіанти не підходять
Це вже не «простий інсталятор проти компіляції всього», але llama.cpp все ще відкриває більше рішень щодо отримання, збірки та запуску.
Після встановлення робота з моделями робить цю різницю конкретною. Іменована бібліотека Ollama і поведінка «завантажити під час запуску» спрощують отримання моделей, тоді як кероване сховище, команди життєвого циклу та налаштування за замовчуванням полегшують повторювану рутину. llama.cpp починається з конкретного артефакту GGUF, хоча поточні інструменти можуть завантажувати й кешувати сумісні моделі з Hugging Face за допомогою -hf; його сервер/маршрутизатор також може виявляти моделі й керувати їх завантаженням. Перевага Ollama полягає не лише в наявності функцій управління моделями, а в тому, що вони поєднані в одну послідовну рутину.
Для налаштування Modelfile є декларативним рецептом Ollama. Він визначає базову модель і параметри, задає поведінку промпту або системних інструкцій та під’єднує адаптери. У llama.cpp відтворюваність починається з точного GGUF і конкретної збірки; бекенд і конфігурація запуску фіксують більше деталей базового механізму.
Ollama не обмежується своєю бібліотекою моделей. Її робочий процес імпорту приймає підтримувані файли GGUF та моделі або адаптери Safetensors з урахуванням обмежень архітектури й конвертації. GGUF залишається центральним переносним форматом llama.cpp, але офіційні інструменти також беруть на себе отримання й кешування.
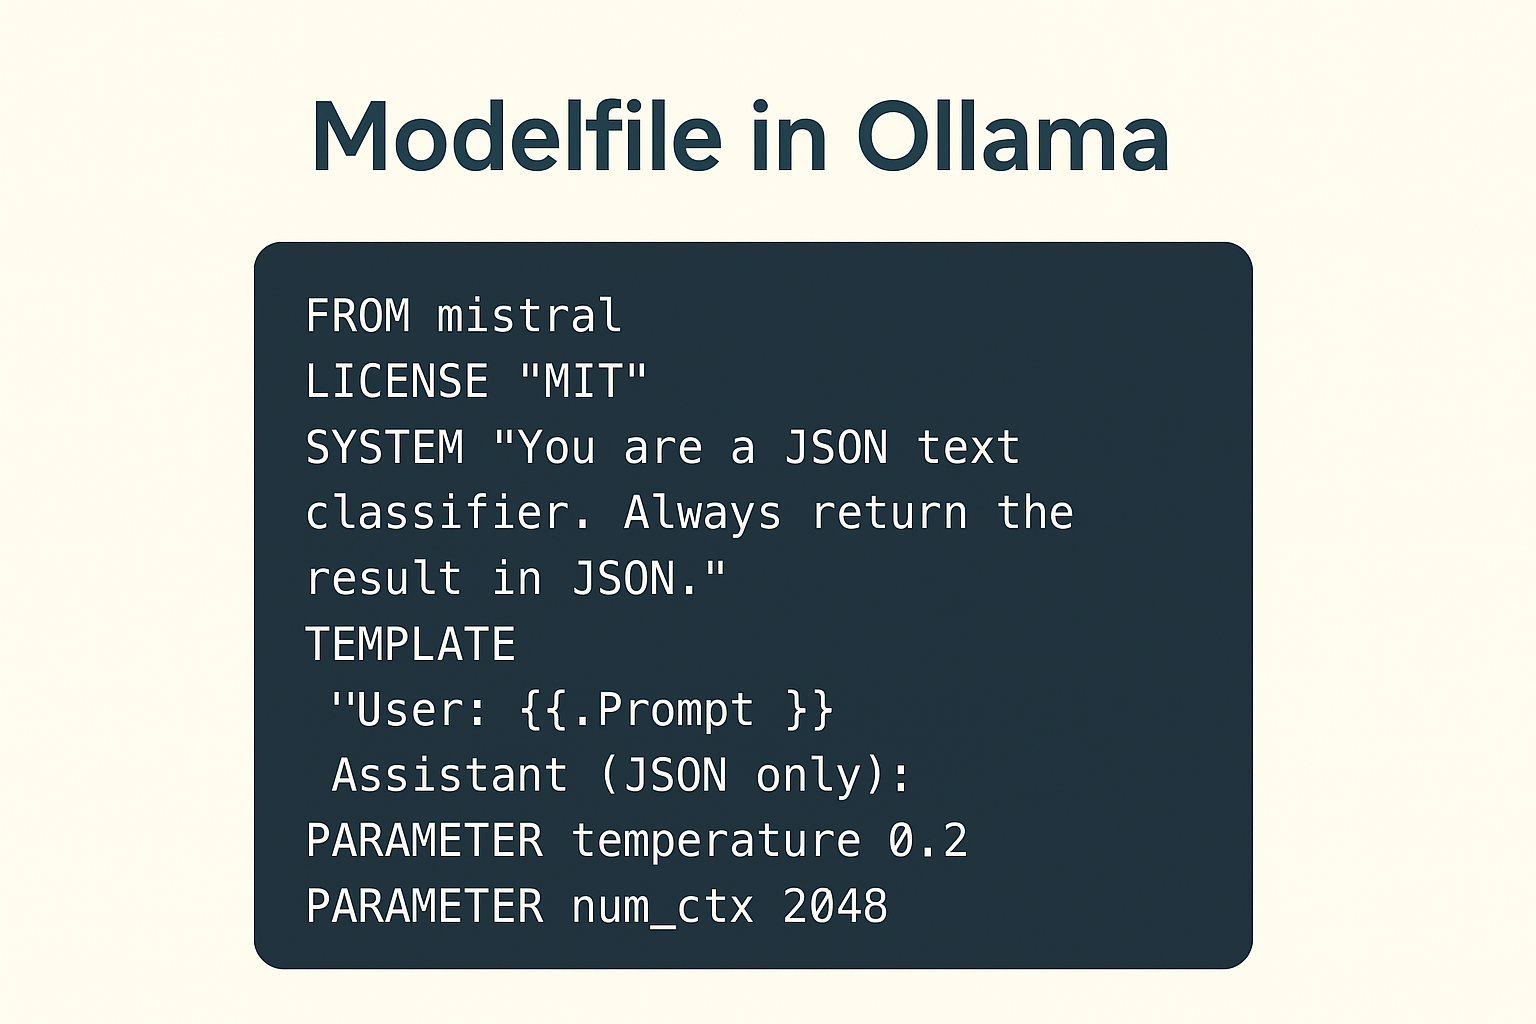
Оновлення та відтворюваність мають різні форми. Ollama може відтворити звичайне налаштування через іменовану модель, Modelfile і керовані значення за замовчуванням, хоча внутрішні ревізії можуть змінюватися разом із оновленням. llama.cpp дозволяє фіксувати збірку, артефакт і налаштування, але ці деталі доводиться підтримувати самостійно. Компроміс полягає між адміністративним навантаженням і прозорістю: значення за замовчуванням зменшують кількість повторюваних рішень, а явні налаштування полегшують перевірку спеціалізованої поведінки.
Производительность, память и оборудование: почему не существует универсального победителя
Среда выполнения может быстро загружаться, но медленно генерировать, или эффективно обрабатывать длинный промпт, но испытывать трудности с параллельной генерацией. Холодная загрузка, обработка промпта и генерация токенов — это отдельные фазы. Единая метка «быстрее» скрывает измеряемую фазу и то, соответствует ли она реальной нагрузке.
Даже промпт должен совпадать на уровне, скрытом от видимого текста. Два сервиса могут получить одно и то же сообщение, но отрисовать разные шаблоны чата, маркеры ролей или специальные токены. Это меняет входные токены и объём работы до генерации. Поведение сэмплирования и длина вывода добавляют дополнительные различия.
Размер файла GGUF не равен пиковым требованиям к памяти. Тензоры модели формируют базовый уровень, тогда как KV-кэш добавляет память для активного контекста и последовательностей. Вычислительные буферы, адаптеры и мультимодальные проекторы добавляют накладные расходы. Черновая модель или другие резидентные модели занимают дополнительную ёмкость, а операционной системе нужен запас. Более длинные контексты и большее число параллельных последовательностей могут существенно увеличить потребление памяти. Если модель не помещается, сначала решите задачу подбора размеров, а только потом сравнивайте среды выполнения.
llama.cpp напрямую предоставляет управление размещением потоков, размерами контекста и батчей, а также типами KV-кэша. Размещение на устройствах и слоях GPU, разделение между несколькими GPU и спекулятивные пути также остаются выбором оператора. Ollama автоматизирует больше, но всё же предоставляет управление активным контекстом, параллельными запросами, резидентностью моделей и планированием GPU. Flash Attention и настройки KV-кэша остаются доступными через конфигурацию, Modelfile или параметры API. Эти настройки полезны только тогда, когда есть причина их тонко настраивать.
Поддержку оборудования также трудно оценить простым баллом. Ollama включает основные пути для CPU и GPU, например Metal, CUDA, ROCm и Vulkan. Более широкая матрица сборок llama.cpp охватывает как основные, так и нестандартные целевые платформы. Задокументированный бэкенд может быть не готов к продакшену или не входить в каждый готовый бинарный файл. Производительность зависит от сборки, драйвера, устройства и того, насколько хорошо модель использует соответствующие ядра.
⚠️ Предупреждение: Совпадение названия модели или один скриншот с количеством токенов в секунду — не контролируемое сравнение. Разные артефакты или шаблоны меняют объём измеряемой работы; контекст, настройки по умолчанию и состояние прогрева меняют условия теста.
Для честной проверки производительности Ollama и llama.cpp:
- Используйте один и тот же артефакт модели или контрольную сумму, квантование, адаптер и мультимодальный проектор, где это применимо.
- Сопоставьте шаблон чата и итоговые токены промпта, запрошенную длину вывода и поведение сэмплирования.
- Сопоставьте контекст, представление KV-кэша, настройки батча и микробатча, параллельные слоты, а также условия очереди и конкурентности.
- Сопоставьте версию ПО и сборку, бэкенд, драйверы, выбор устройства и поведение выгрузки на GPU или разделения.
- Отчитывайте холодную загрузку, прогретую обработку промпта и генерацию токенов отдельно.
- Повторяйте тест при конкурентности и форме запросов, которые будет использовать реальное приложение.
Несколько GPU или более низкая битность квантования не гарантируют более быстрого инференса. Межсоединения и перемещение данных в памяти могут ограничивать конфигурации с несколькими GPU, а ядра и форма запросов могут менять результат. Выберите конфигурацию, которая помещается с запасом, затем измеряйте фазу и паттерн, которые будет использовать ваше приложение.
API та інтеграція: спочатку сервіс чи спочатку набір інструментів?
Ollama створена насамперед як довготривалий сервіс для моделей. Вона надає нативний API — власну поверхню запитів і відповідей — а також офіційні клієнти для Python і JavaScript. Це підходить для плагіна або внутрішнього інструмента, якому потрібна стабільна локальна HTTP-точка доступу. Ollama завантажує та запускає модель, а застосунок лише надсилає запити.
Ollama документує вибрані маршрути, сумісні з OpenAI та Anthropic. Поточний llama-server документує обидва стилі разом із нативними операційними ендпоїнтами. Ці шари дозволяють наявним клієнтам використовувати знайому форму API з іншим runtime.
Перевірена зміна base URL у стилі OpenAI може заощадити роботу з інтеграцією, але не гарантує підтримку всіх функцій. Структурований вивід і використання інструментів залежать від маршруту, моделі та шаблону промпту. Ембеддинги або мультимодальний вхід також можуть залежати від збірки та клієнта. Перевіряйте ці можливості як частину застосунку, а не як галочки в runtime.
📝 Примітка: «Сумісний» означає вибрані маршрути та поля. Спочатку перевірте точний ендпоїнт і поля запиту. Потім перевірте поведінку потокової передачі та формати викликів інструментів, а також обробку зображень, лічильники токенів, поля відповіді й помилки, які використовує ваш застосунок.
llama-server — серйозний варіант для обслуговування моделей, а не демонстраційна обгортка. Його Web UI надає браузерний інтерфейс, а паралельне декодування та безперервне батчування підтримують спільне обслуговування. Маршрутизація й завантаження моделей додають керування життєвим циклом на рівні сервера; маршрути сумісності та нативні операційні ендпоїнти доповнюють інтерфейс. Він може бути кращим HTTP-шаром, коли важливіший прямий контроль, ніж керований життєвий цикл Ollama.
Коли HTTP недостатньо, C-подібна бібліотека llama.cpp може вбудувати інференс безпосередньо у ваш процес. Застосунок контролює ініціалізацію та завершення роботи, а низькорівневі налаштування залишаються поруч із його кодом. Ollama зазвичай є окремим сервісом. Обирайте llama.cpp, коли інференс має поставлятися всередині застосунку; обирайте Ollama, коли бажаніший окремий ендпоїнт.
От ноутбука до постійно доступного приватного сервера
Існує три межі виконання.
- Інференс на пристрої виконується на ноутбуці або робочій станції, що надсилає запит.
- Віддалене приватне self-hosting виконується на сервері, контрольованому організацією; воно може зберігати операційний контроль, але запити проходять через мережу, а виконання не є локальним для пристрою.
- Хмарний інференс від постачальника виконується на інфраструктурі провайдера.
Ця різниця важлива, оскільки моделі Ollama з позначкою cloud працюють у її хмарі, навіть коли запит надсилає localhost-клієнт. «Використання Ollama» не доводить локальне виконання. Суворо локальні розгортання мають виключати або вимикати хмарну функціональність згідно з чинною документацією.
Обидва проєкти за замовчуванням обмежують мережеву доступність локальним середовищем. Ollama прив’язується до localhost, а її API не має вбудованої автентифікації. llama-server також за замовчуванням використовує loopback — доступний лише з того ж хоста — і пропонує опції API-ключа та TLS. Жодне з налаштувань за замовчуванням не є повною межею для публічного розгортання.
⚠️ Попередження: Локальний API Ollama не має вбудованої автентифікації, а заглушки ключів, які приймаються прикладами сумісності, його не захищають. Ніколи не відкривайте стандартну кінцеву точку безпосередньо для публічного інтернету.
Перш ніж робити будь-яку кінцеву точку віддалено доступною, використовуйте ці засоби контролю як мінімальний бар’єр:
- Свідомо обрана адреса прив’язки та приватна мережева межа або VPN.
- Автентифікація на сервері або через автентифікований шлюз.
- TLS для мережевого транспорту.
- Обмеження firewall, CORS, розміру запитів, паралельності та ресурсів.
- Керування процесами, контрольовані оновлення, перевірки стану та моніторинг.
- Облік конфіденційності при веденні логів, зберіганні та обробці даних, що запобігає витоку запитів, відповідей або облікових даних.
Визначте розмір моделі та квантування до розгляду орендованої GPU-потужності. Враховуйте активний контекст і паралельність, щоб оцінити VRAM і операційний запас. Якщо ноутбук не відповідає цільовим показникам продуктивності або безперервної роботи, орендована інфраструктура GPU, придатна для LLM, — з AlexHost як одним із прикладів — стає варіантом, але не обхідним шляхом без належного розрахунку розміру.
Заяви постачальників про конфіденційність не є незалежними аудитами. Документуйте, де виконується інференс і через які мережі проходять запити. Фіксуйте, хто адмініструє системи та що зберігають сховища або логи. Цей запис визначає межу конфіденційності чіткіше, ніж логотип runtime.
Какий варіант обрати? Рекомендації за сценаріями використання
Цей текст підказує, які рішення підходять для конкретних робочих навантажень, а не для рівня навичок. Зручність може бути інженерною вимогою, а прямий контроль — непотрібними накладними витратами. Вибір змінюється, коли конкретна вимога виходить за межі абстракції.
Перший локальний експеримент або інструмент розробника: Оберіть Ollama, якщо важлива швидка настройка і ви хочете працювати з моделями за назвою. Його готовий API надає інструменту стабільний інтерфейс без роботи з життєвим циклом, яка не допомагає оцінці чи інтеграції. Натомість оберіть llama.cpp, якщо вам потрібен непідтримуваний бекенд, точна збірка або недоступний ззовні низькорівневий параметр.
Відтворюваний індивідуальний інференс або вбудований застосунок: Оберіть llama.cpp, коли продукт повинен контролювати точний артефакт і збірку. Він також напряму керує ініціалізацією та параметрами виконання, що важливо, коли інференс працює всередині застосунку. Натомість оберіть Ollama, якщо окремий HTTP-сервіс і контроль на рівні Modelfile повністю задовольняють потреби продукту.
Обмежене або незвичайне апаратне забезпечення чи максимальне налаштування: Починайте з llama.cpp, якщо його ширша матриця бекендів або явне розміщення вирішує конкретну вимогу. Спочатку перевірте, що модель вміщується. Оберіть Ollama, коли він добре підтримує апаратне забезпечення, а пряме налаштування додало б обслуговування без корисного контролю чи виміряного покращення.
Приватний сервіс, доступний команді: Ollama зазвичай є легшим стартовим варіантом для життєвого циклу й обслуговування, за умови що оператор додає автентифіковану мережеву межу. Розгляньте llama-server, якщо важливіші вбудована автентифікація API-ключами, прямі засоби керування сервером або налаштування бекенда. Відхиліть обидва варіанти, якщо команда не може забезпечити вимоги щодо безперервної роботи, описані вище.
Використовуйте обидва: Тримайте Ollama і окремий llama.cpp як окремі точки входу та окремі домени життєвого циклу. Застосунки можуть обирати перевірену кінцеву точку для звичайного обслуговування або контрольованих експериментів, але не можуть припускати ідентичну поведінку API. Кожна среда виконання може зберігати власне сховище моделей, порт і процес; якщо обидві утримують моделі, вони можуть конкурувати за RAM або VRAM. Ollama не використовує ваш окремий сервіс llama.cpp.
Матриця нижче підсумовує ці вибори. Не рахуйте рядки як бали: одна жорстка вимога може переважити всі зручності в інших місцях.
| Сфера рішення | Ollama | llama.cpp |
|---|---|---|
| 🚀 Найшвидший старт | Інтегрований шлях встановлення, моделі та сервісу | Більше варіантів завантаження, збірки та запуску залишаються видимими |
| 🔄 Життєвий цикл моделі | Іменовані завантаження, кероване сховище, Modelfile, резидентність і планування | Прямий GGUF або кеш Hugging Face плюс керування маршрутизатором, пресетами та завантаженням; менш категоричний від початку до кінця |
| 🎛️ Детальне налаштування | Автоматизовані значення за замовчуванням з вибраною конфігурацією та керуванням через API | Ширший прямий контроль над збірками, пристроями, розміщенням, кешами та пакетами |
| 🧩 Вбудовування в процес | Зазвичай використовується як окремий сервіс | Бібліотека в стилі C є сильнішим прямим варіантом |
| 🌐 API-сервіс | Рідний API плюс обмежені шари сумісності | llama-server з обмеженою сумісністю та рідними маршрутами експлуатації |
| ⚙️ Гнучкість бекендів | Відібрана пакетна підтримка | Ширша матриця бекендів на етапі збірки, з застереженнями щодо збірки та зрілості |
| 🛠️ Операційна відповідальність | Інтегрований життєвий цикл моделі та сервісу; зовнішня автентифікація потрібна поза локальним використанням | Чіткіше право власності на сервер і нативні опції ключів та TLS; посилення захисту все одно потрібне |
| 🎯 Найвідповідніше навантаження | Повторюваний щоденний локальний або приватний сервіс моделей | Вбудований, експериментальний, апаратно-специфічний або глибоко налаштований інференс |
Итог
Ukrainian translation:
Підсумок
Два шляхи, описані на початку, здавалися суперечливими, оскільки вони по-різному визначають, хто відповідає за роботу системи. Обирайте Ollama, коли головною перевагою є інтегрований робочий процес. Обирайте llama.cpp, коли головною перевагою є безпосередній контроль над інференсом.
Якщо ви не впевнені, переконайтеся, що модель і квантування відповідають вашому апаратному забезпеченню. Перевірте обсяг пам’яті, необхідний для запланованого контексту, а потім почніть з Ollama. Переходьте на окремий llama.cpp або додавайте його лише для конкретної низькорівневої вимоги: певного бекенда чи збірки, вбудовування в процес або точнішого розміщення та налаштування.