Отворен билет
 +373 79 600002
 Чат на живо в Telegram
 Често задавани въпроси
 български
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 Polski
 Indonesia
 中文 (中国)









 от всички хостинг услуги


Ollama срещу llama.cpp през 2026: Кой локален LLM runtime да използвате?
Вие искате да изпълнявате LLM с отворени тегла на хардуер, който контролирате: лаптоп, работна станция, домашен сървър или частен отдалечен сървър. Едно ръководство сочи към Ollama и модел, който можете да изтеглите по име. Друго сочи към llama.cpp, файл с модел и много повече настройки.
След това твърденията се сблъскват. Ollama се описва като по-лесен, а llama.cpp като по-бърз; единият е представен като по-практичен, другият като по-способен. Тези твърдения често сравняват различни модели, настройки, хардуер или слоеве от софтуерния стек.
Полезният въпрос не е кое име печели, а колко от работния процес за изпълнение на модела инструментът трябва да управлява — и колко вашата работна натовареност се нуждае от той да разкрие.
Отговорът за 60 секунди
Изберете Ollama, когато искате интегриран модел за изпълнение и услуга. Инсталирането, изтеглянето на именувани модели и съхранението споделят един работен процес. Стандартните настройки и рецептите за персонализиране покриват рутинната конфигурация, а готовият локален API дава на приложенията стабилен интерфейс. Това обикновено е по-чистият избор по подразбиране за експерименти, инструменти за програмиране и вътрешни помощни програми, които не изискват административно управление на ниско ниво.
Изберете llama.cpp, когато имате нужда от директен контрол върху инференцията. Можете да избирате версията на сборката и хардуерния бекенд, да фиксирате точния файл на модела и да управлявате процеса, паметта и решенията за настройка. Също така подхожда на софтуер, който трябва да вгражда инференцията, вместо да я използва от отделна услуга.
Нито един от двата не е универсален победител: Ollama може да обслужва рутинна работа, а самостоятелният llama.cpp – контролирани експерименти. Преди сравняване на производителността потвърдете съвместимостта на модела, квантуването, контекста и хардуера. Останалата част от сравнението тества работния процес, хардуера, интеграцията и внедряването – не измислен бенчмарк.
Ollama и llama.cpp са на различни нива
Инференция означава изпълнение на вече обучен модел за получаване на резултат; инференционен енджин извършва това изчисление. llama.cpp е преносима C/C++ библиотека и инструментариум. Основната ѝ библиотека се намира до инструменти за командния ред и llama-server, който включва уеб интерфейс. Той предоставя също така помощни програми за конвертиране и квантизация и официалната llama дистрибуция, така че llama.cpp не е само CLI.
Ollama е изпълнител на модели и услуга, която поставя определен работен процес около инференцията. Той управлява придобиването и съхранението на модели, прилага шаблони или Modelfile файлове и планира инференцията. Достъпът до API и избрани бекенди принадлежат към същата услуга. Ollama следователно не е просто графичен обвивка; жизненият цикъл на моделите е в центъра на продукта.
Опростена карта на слоевете
| Път | Слоест концептуален модел |
|---|---|
| Ollama път | Приложение или CLI → Ollama API, жизнен цикъл на моделите, шаблони и планиране → вграден инференционен компонент (текущ GGUF път: фиксиран llama-server) → избран хардуерен бекенд |
| llama.cpp път | Приложение, CLI или уеб интерфейс → библиотека llama.cpp или llama-server → директно избран build/бекенд и контроли на изпълнението → хардуер |
Опростен концептуален модел—не е пълна архитектура. Достъпно описание: Ollama добавя управление на модели и оркестрация на услуги над вградените инференционни компоненти, докато llama.cpp излага своята библиотека и сървър по-близо до хардуерните контроли.
Към 5 септември 2026 г. освободеният GGUF път на Ollama стартира вграден, фиксиран upstream llama-server под своя услужебен слой. Като съкратено сравнение, llama.cpp предоставя двигателя и работилничните контроли, докато Ollama опакова тези механизми в готово за управление превозно средство с по-прост табло. Аналогията обяснява абстракцията, а не всеки компонент или път към модела.
📝 Забележка: Вграждането на фиксиран llama-server не прави Ollama идентичен с upstream llama.cpp. Ollama все още предоставя собствени настройки по подразбиране, шаблони, планиране и публичен API. Пътища, които не са GGUF или са експериментални, също могат да се различават.
Шест ключови термина, които улесняват сравнението
Не са ви необходими пълен речник по инферентно инженерство. Тези шест термина обхващат изборите за модел, памет и хардуер, които предстоят.
| Термин | Значение на разбираем език | Защо влияе на този избор |
|---|---|---|
| 📦 GGUF | Двоичен контейнер, ориентиран към инференция, за тензори на модела и метаданни, който е централен за екосистемата llama.cpp. GGUF сам по себе си не определя ниво на кватизация. | Това е основният преносим артефакт, използван директно от llama.cpp, и поддържан път за импорт в Ollama. |
| 🗜️ Квантизация | Представяне на тензорите на модела с по-ниска прецизност, което обикновено намалява нуждите от съхранение и памет. Ефектите върху качеството и скоростта варират според метода, модела, бекенда и натоварването. | Избраната квантизация може да промени дали моделът се побира и работи добре, независимо от средата за изпълнение. |
| 📏 Дължина на контекста | Активният бюджет от токени, наличен за модела за инструкции, вход, история и изход. | По-големите активни контексти консумират повече памет, така че обявеният максимум не е безплатен капацитет. |
| ⚙️ Бекенд | Специфичният за хардуера път за изчисления, например CUDA, Metal, HIP/ROCm или Vulkan. | Поддръжката от средата за изпълнение и компилацията за най-добрия бекенд на машината може да определи дали ускорението работи добре. |
| 🚀 Разтоварване към GPU | Прехвърляне на допустимите слоеве или изчисления на модела към GPU, вместо цялата работа да остава на CPU. | Количеството и разположението на разтоварването могат да променят използването на памет и скоростта повече от обвивката на услугата. |
| 🗃️ KV кеш | Съхранено състояние на вниманието, което позволява на модела да използва повторно предишния контекст по време на генериране. Размерът му нараства с активния контекст и броя последователности. | Дългите контексти и едновременните потребители могат да консумират значителна RAM или VRAM отвъд самия файл на модела. |
The Спецификацията GGUF описва артефакта; квантизацията променя начина, по който се представят неговите тензори. Контекстът и KV кешът определят неговия отпечатък в паметта, докато бекендът и разтоварването определят къде се извършват изчисленията.
Установете критериите преди сравнението
И двата проекта могат да изпълняват отворени модели с тегла (open-weight) на хардуер, контролиран от потребителя, и да предоставят инференция чрез API. Тези общи възможности не решават сравнението. Използвайте еднаквите осем въпроса през цялото време:
- Колко трудности при настройката можете да приемете преди първата полезна заявка?
- Трябва ли услугата да управлява жизнения цикъл на модела, или вие да контролирате точните файлове и опциите за стартиране?
- Колко контрол на ниско ниво наистина изисква натоварването?
- Коя опция има правилното съответствие на хардуера и бекенда за тази машина?
- Изисква ли приложението HTTP услуга или по-тясна интеграция в процеса?
- Каква оперативна сигурност трябва да обгражда крайната точка?
- Кой ще се грижи за поддръжката, актуализациите и повтаряемостта?
- Ще се извършва ли инференцията на устройството, на отдалечен частен сървър или във облака на доставчик?
Сравненията на производителността изискват точния артефакт на модела—конвертирания файл и метаданните, които се изпълняват, а не просто същото семейство по име. Съпоставете визуализирания шаблон и активния контекст, след което синхронизирайте бекенда, поведението на разтоварване (offload) и хардуера. Използвайте същата версия на софтуера, batching и условия за конкурентност. С фиксиран този критерий, нека започнем с най-видимата разлика: ежедневния работен процес.
Ежедневна работа: управляемо удобство срещу изричен контрол
Първоначалната настройка показва разликата:
- Ollama предлага готови инсталации за macOS, Windows и Linux, които водят до услуга с по-малко ранни избори
- Официалната дистрибуция llama, пакетните мениджъри и готовите издания осигуряват достъпни пътища за llama.cpp
- Контейнерите и сглобяването от изходен код добавят контрол, когато готовите опции не отговарят на нуждите
Това вече не е „приятелски инсталатор срещу компилиране на всичко“, но llama.cpp все още предоставя повече решения за получаване, изграждане и стартиране.
След инсталацията работата с модели прави разликата конкретна. Именуваната библиотека на Ollama и поведението „изтегляне при стартиране“ опростяват получаването, докато управляваното съхранение, командите за жизнен цикъл и настройките по подразбиране улесняват повтарящата се поддръжка. llama.cpp започва от конкретен GGUF артефакт, въпреки че текущите инструменти могат да изтеглят и кешират съвместими модели от Hugging Face с -hf; неговият сървър/рутер може също да открива модели и да управлява зареждането им. Предимството на Ollama не е просто в наличието на функции за управление на модели, а в тяхното обединяване в една рутина.
За персонализиране Modelfile е декларативната рецепта на Ollama. Той определя базовия модел и параметрите, задава поведението на системния или подканващия текст и прикрепя адаптери. При llama.cpp повтаряемостта започва с точен GGUF и конкретно сглобяване; бекендът и конфигурацията при стартиране фиксират повече от основния механизъм.
Ollama не се ограничава до своята библиотека с модели. Неговият работен процес за импорт приема поддържани GGUF файлове и модели или адаптери в Safetensors, при спазване на ограниченията за архитектура и конвертиране. GGUF остава централният преносим формат на llama.cpp, но официалните инструменти се грижат и за получаването и кеширането.
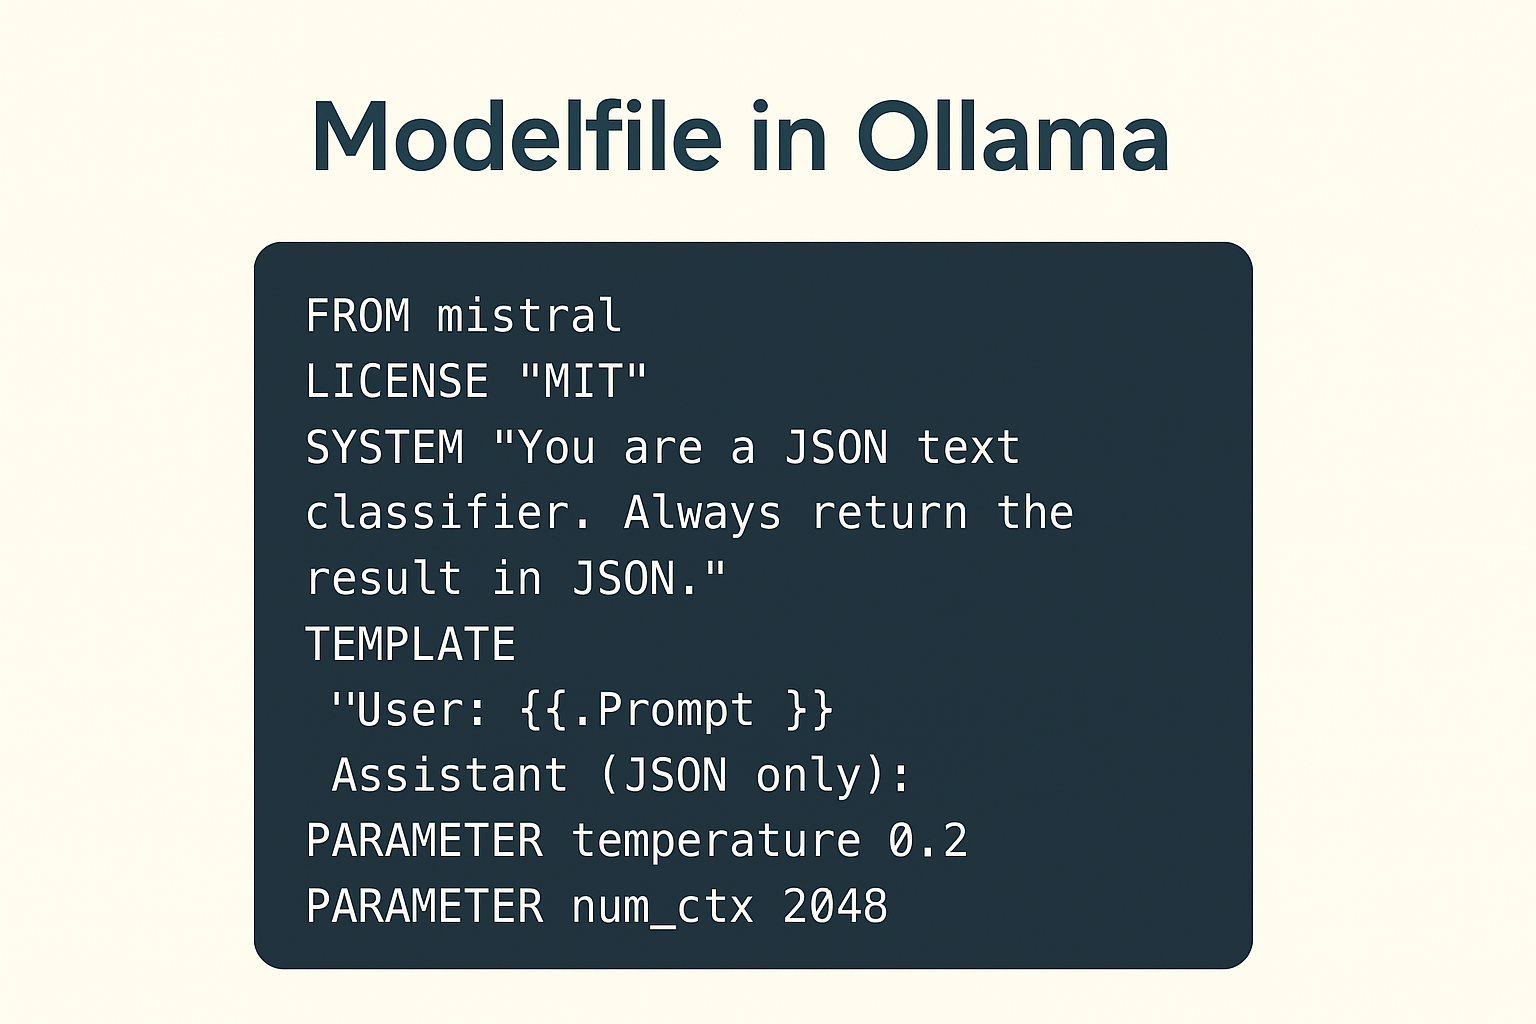
Актуализациите и повтаряемостта имат различни форми. Ollama може да възпроизведе ежедневна настройка чрез именуван модел, Modelfile и управляваните настройки по подразбиране, въпреки че вътрешните ревизии може да се променят при актуализация. llama.cpp позволява на операторите да фиксират сглобяването, артефакта и настройките, но те трябва сами да поддържат тези подробности. Компромисът е между административната тежест и видимостта: настройките по подразбиране намаляват повтарящите се решения, а изричните настройки правят специализираното поведение по-лесно за проверка.
Производителност, памет и хардуер: защо няма универсален победител
Една среда за изпълнение може да се зарежда бързо, но да генерира бавно, или да обработва ефективно дълъг промпт, но да се затруднява при едновременна генерация. Зареждането на модела при студен старт, обработката на промпта и генерирането на токени са отделни фази. Един етикет „по-бързо“ скрива измерената фаза и това дали тя съответства на реалното натоварване.
Дори промptът трябва да съвпада под видимия текст. Две услуги може да получат едно и също съобщение, но да прилагат различни шablonи за чат, маркери за роли или специални токени. Това променя входните токени и работата преди генерирането. Поведението при семплиране и дължината на изхода добавят допълнителни разлики.
Размерът на GGUF файла не е пиковото изискване за памет. Тензорите на модела формират базовото ниво, докато KV кешът добавя памет за активния контекст и последователностите. Буферите за изчисления, адаптерите и мултимодалните проектори добавят допълнителни разходи. Чернова (draft) модел или други постоянно заредени модели консумират още капацитет, а операционната система се нуждае от резерв. По-дългите контексти и повече едновременни последователности могат значително да увеличат използването на памет. Ако моделът не се побира, решете проблема с размера, преди да сравнявате среди за изпълнение.
llama.cpp директно предоставя разпределение на нишките, размери на контекст и партиди, както и типове KV кеш. Разположението на устройствата и GPU слоевете, разделянето между няколко GPU и спекулативните пътища също остават избор на оператора. Ollama автоматизира повече, но все пак предоставя активен контекст, паралелни заявки, постоянство на модела в паметта и планиране на GPU. Flash Attention и контролите на KV кеша остават достъпни чрез конфигурация, Modelfile или опции на API. Тези контроли са полезни само когато имате причина да ги настройвате.
Поддръжката на хардуера също не се поддава на просто оценяване. Ollama включва основни CPU и GPU пътища, като примери са Metal, CUDA, ROCm и Vulkan. По-широката матрица от сборки на llama.cpp обхваща основни и необичайни цели. Документиран бекенд може да не е зрял или да не е включен във всеки предварително компилиран двоичен файл. Производителността зависи от сборката, драйвера, устройството и от това колко добре моделът използва съответните ядра.
⚠️ Предупреждение: Общо име на модел или една снимка с токени в секунда не е контролирано сравнение. Различни артефакти или шаблони променят измерената работа; контекстът, настройките по подразбиране и състоянието на загряване променят условията на теста.
За честна проверка на производителността Ollama срещу llama.cpp:
- Използвайте точно същия артефакт или контролна сума на модела, same квантуване, адаптер и мултимодален проектор, където е приложимо.
- Съгласувайте шаблона за чат и изготвените токени на промпта, поисканата дължина на изхода и поведението при семплиране.
- Съгласувайте контекста, представянето на KV кеша, настройките на партидите и микропартидите, паралелните слотове и условията на опашката или едновременността.
- Съгласувайте версията и сборката на софтуера, бекенда, драйверите, избора на устройство и поведението при разтоварване към GPU или разделяне.
- Отчитайте отделно студеното зареждане, обработката на загрят промпт и генерирането на токени.
- Повторете теста при едновременността и формата на заявките, които реалното приложение ще използва.
Множеството GPU или по-ниското битово квантуване не гарантират по-бързо извеждане. Връзките между устройствата и движението на паметта могат да ограничат настройките с няколко GPU, а ядрата и формата на заявката могат да променят резултата. Изберете конфигурация, която се побира с резерв, след което измерете фазата и модела, които ще използва вашето приложение.
APIs и интеграция: първо услуга или първо инструментариум?
Ollama е проектиран преди всичко като дългосрочно работещ моделен сървис. Той предоставя собствен API — свой формат на заявките и отговорите — плюс официални клиенти за Python и JavaScript. Това подхожда на плъгин или вътрешен инструмент, който се нуждае от стабилна локална HTTP крайна точка. Ollama зарежда модела, а приложението изпраща заявките.
Ollama документира избрани съвместими с OpenAI и съвместими с Anthropic маршрути. Текущият llama-server документира и двата стила заедно с нативни оперативни крайни точки. Тези слоеве позволяват на съществуващите клиенти да използват познат формат на API с различна среда за изпълнение.
Успешната, тествана смяна на base URL в стил OpenAI може да спести работа по интеграцията, но не решава въпроса с поддръжката на функции. Структурираният изход и използването на инструменти зависят от маршрута, модела и шаблона на промпта. Вграждането (embeddings) или мултимодалният вход може да зависят и от версията и клиента. Тествайте тези възможности като част от приложението, а не като отметки за средата за изпълнение.
📝 Забележка: „Съвместимо“ означава избрани маршрути и полета. Първо тествайте точната крайна точка и полетата на заявката. След това проверете поведението при поточно предаване (streaming) и форматите на извикванията на инструменти, а после обработката на изображения, броя токени, полетата в отговорите и грешките, които използва вашето приложение.
llama-server е сериозна опция за обслужване, а не демонстрационна обвивка. Неговият уеб интерфейс предоставя браузърна среда, докато паралелното декодиране и непрекъснатото batching поддържат споделено обслужване. Маршрутизирането и зареждането на модели добавят контрол на жизнения цикъл на ниво сървър; маршрутите за съвместимост и нативните оперативни крайни точки допълват интерфейса. Може да е по-добър HTTP слой, когато директният контрол е по-важен от управляемия жизнен цикъл на Ollama.
Когато HTTP не е достатъчен, C-подобната библиотека на llama.cpp може да вгради инференцията directly във вашия процес. Приложението контролира инициализацията и изключването, докато низкоуровневите настройки остават близо до неговия код. Ollama обикновено е отделна услуга. Изберете llama.cpp, когато инференцията трябва да бъде част от самото приложение; изберете Ollama, когато е за предпочитане отделна крайна точка.
От лаптоп до винаги включен частен сървър
Съществуват три граници на изпълнение.
- Инференция на устройството се извършва на лаптопа или работната станция, които изпращат заявката.
- Отдалечено частно самостоятелно хостване се извършва на сървър, контролиран от организацията; то може да запази оперативния контрол, но заявките преминават през мрежа и изпълнението не е локално за устройството.
- Облачна инференция, хоствана от доставчик се извършва на инфраструктурата на доставчика.
Това разграничение е важно, защото моделите на Ollama с облачен етикет се изпълняват в неговия облак, дори когато клиент на localhost изпрати заявката. „Използването на Ollama“ не доказва локално изпълнение. Строго локалните внедрявания трябва да изключат или деактивират облачната функционалност според текущата документация.
И двата проекта по подразбиране ограничават мрежовата експозиция до локална. Ollama се свързва локално, а API-то му няма вградена автентикация. llama-server също по подразбиране използва loopback – достъпен само от същия хост – и предлага опции за API ключ и TLS. Нито едно от двете подразбиращи се състояния не представлява пълна граница за публично внедряване.
⚠️ Предупреждение: Локалното API на Ollama няма вградена автентикация, а фиктивните ключове, приемани от примерите за съвместимост, не го защитават. Никога не излагайте директно стандартната крайна точка на публичния интернет.
Преди да направите която и да е крайна точка достъпна отдалечено, използвайте следните контроли като минимална защита:
- Целенасочен bind адрес и граница на частна мрежа или VPN.
- Автентикация на сървъра или чрез автентифициран шлюз.
- TLS за мрежовия транспорт.
- Защитна стена, CORS, ограничения на размера на заявките, едновременните заявки и ресурсите.
- Наблюдение на процесите, контролирани актуализации, проверки на състоянието и мониторинг.
- Логване с грижа за поверителността, задържане и обработка на данните, които предотвратяват изтичане на подкани, отговори или идентификационни данни.
Определете размера на модела и квантуването, преди да обмисляте наети GPU ресурси. Отчетете активния контекст и едновременните заявки, за да оцените VRAM и оперативния резерв. Ако лаптопът не може да постигне целевата производителност или време на работа, наета инфраструктура с GPU, поддържащ LLM – с AlexHost като един пример – се превръща в опция, а не в пряк път заобикаляне на определянето на размера.
Декларациите за поверителност на доставчиците не са независими одити. Документирайте къде се извършва инференцията и през кои мрежи преминават заявките. Запишете кой администрира системите и какво съхраняват хранилищата или логовете. Този запис определя границата на поверителността по-ясно от логото на изпълнителната среда.
Какво да изберете? Препоръки според случая на използване
Тези препоръки описват съответствието на натоварването, а не нивото на уменията. Удобството може да бъде инженерно изискване; директният контрол може да е ненужно натоварване. Изборът се променя, когато конкретно изискване пресича границата на абстракцията.
Първи локален експеримент или инструмент за разработчици: Изберете Ollama, когато бързото настройване е важно и искате модели по име. Готовият му API предоставя на инструмента стабилен интерфейс без работа по управление на жизнения цикъл, която не помага за оценката или интеграцията. Изберете llama.cpp, ако се нуждаете от неподдържан бекенд, точна версия на сборката или незастъпен нискониво параметър.
Възпроизводимо персонализирано извеждане или вградено приложение: Изберете llama.cpp, когато продуктът трябва да притежава точния артефакт и сборка. Той също така контролира директно инициализацията и параметрите за изпълнение, което е важно, когато изводът се намира във вътрешността на приложението. Изберете Ollama, ако отделна HTTP услуга и контрол на ниво Modelfile напълно отговарят на нуждите на продукта.
Ограничен или необичаен хардуер, или максимална настройка: Започнете с llama.cpp, когато по-широката му матрица от бекенди или явното разпределяне решава конкретно изискване. Първо проверете дали моделът се побира. Изберете Ollama, когато той поддържа добре хардуера, а директната настройка би добавила поддръжка без полезен контрол или измеримо подобрение.
Достъпна за екипа частна услуга: Ollama е обикновено по-лесната отправна точка за жизнения цикъл и обслужването, при условие че операторът добави удостоверена мрежова граница. Обмислете llama-server, когато са по-важни собственото API ключово удостоверяване, директните контроли за обслужване или настройката на бекенда. Отхвърлете която и да е опция, ако екипът не може да отговори на изискванията за постоянна работа, посочени по-горе.
Използвайте и двете: Поддържайте Ollama и самостоятелния llama.cpp като отделни точки на вход и отделни домейни на жизнен цикъл. Приложенията могат да избират тествана крайна точка за рутинно обслужване или контролирани експерименти, но не могат да приемат идентично поведение на API. Всяко изпълнение може да поддържа собствено хранилище на модели, порт и процес; ако и двете държат модели, те могат да се конкурират за RAM или VRAM. Ollama не използва вашата отделна услуга llama.cpp.
Матрицата по-долу обобщава тези избори. Не броете редовете като точки: едно строго изискване може да надделее над всички удобства другаде.
| Област на решение | Ollama | llama.cpp |
|---|---|---|
| 🚀 Най-бърз старт | Интегриран път за инсталация, модел и услуга | Остават по-видими избори за изтегляне, компилиране и стартиране |
| 🔄 Жизнен цикъл на модела | Именувани изтегляния, управлявано съхранение, Modelfile, задържане в паметта и планиране | Директен GGUF или кеш на Hugging Face плюс контроли за рутер, пресети и зареждане; по-малко наложен от край до край |
| 🎛️ Детайлна настройка | Автоматизирани стойности по подразбиране с избрана конфигурация и контроли чрез API | По-широк директен контрол върху сборките, устройствата, разпределението, кешовете и партидите |
| 🧩 Вграждане в процес | Обикновено се консумира като отделна услуга | Библиотеката в стил C е по-силно директно съответствие |
| 🌐 API услуга | Собствен API плюс ограничени слоеве за съвместимост | llama-server с ограничена съвместимост и собствени оперативни маршрути |
| ⚙️ Гъвкавост на бекенда | Подбрана пакетирана поддръжка | По-широка матрица от бекенди по време на компилиране, с уговорки за сборка и зрялост |
| 🛠️ Оперативна отговорност | Интегриран жизнен цикъл на модел/услуга; външно удостоверяване е необходимо извън локалната употреба | По-ясно собствена отговорност за сървъра и собствени опции за ключове и TLS; усилването все още е необходимо |
| 🎯 Работно натоварване с най-добро съответствие | Повтаряема ежедневна локална или частна услуга за модели | Вградено, експериментално, специфично за хардуер или дълбоко настроено извеждане |
Bottom Line
Двата пътя от началото изглеждаха противоречиви, защото присвояват собствеността различно. Изберете Ollama, когато интегрираният работен процес е самата функция. Изберете llama.cpp, когато директният контрол върху инференцията е функцията.
Ако не сте сигурни, потвърдете, че моделът и квантизацията съответстват на хардуера. Проверете паметта, необходима за желания контекст, след което започнете с Ollama. Преминете към или добавете самостоятелен llama.cpp само при конкретно нискоравнищно изискване: специфичен бекенд или билд, вграждане в процеса или по-фина настройка и разпределение.