Billet ouvert
 +373 79 600002
 Chat en direct Telegram
 F.A.Q
 Français
 English
 Русский
 Română
 Deutsch
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 sur tous les services d'hébergement


Ollama vs llama.cpp en 2026 : quel runtime LLM local devez-vous utiliser ?
Vous souhaitez exécuter un LLM à poids ouverts sur du matériel que vous contrôlez : un ordinateur portable, une station de travail, un serveur domestique ou un serveur distant privé. Un guide vous oriente vers Ollama et un modèle que vous téléchargez par son nom. Un autre vous oriente vers llama.cpp, un fichier de modèle et de nombreuses options de contrôle supplémentaires.
Ensuite, les affirmations se contredisent. Ollama est présenté comme plus facile et llama.cpp comme plus rapide ; l’un est décrit comme plus pratique, l’autre comme plus performant. Ces affirmations comparent souvent des modèles, des réglages, du matériel ou des couches différentes de la pile logicielle.
La question utile n’est pas de savoir quel nom l’emporte, mais quelle part du flux de travail d’exécution du modèle l’outil doit gérer, et quelle part votre charge de travail a besoin d’exposer.
La réponse en 60 secondes
Choisissez Ollama lorsque vous voulez un exécuteur de modèles et un service intégrés. La configuration, l’acquisition des modèles nommés et le stockage partagent un même flux de travail. Les valeurs par défaut et les recettes de personnalisation couvrent la configuration courante, tandis qu’une API locale prête à l’emploi offre aux applications une interface stable. C’est généralement le choix par défaut le plus simple pour les expérimentations, les outils de codage et les utilitaires internes qui n’ont pas besoin d’une administration bas niveau du runtime.
Choisissez llama.cpp lorsque vous avez besoin d’un contrôle direct de l’inférence. Vous pouvez sélectionner la version de compilation et le backend matériel, figer l’artefact exact du modèle, et gérer les décisions relatives aux processus, à la mémoire et au réglage. Cette solution convient aussi aux logiciels qui doivent intégrer l’inférence plutôt que de la consommer depuis un service séparé.
Aucune des deux n’est universellement supérieure : Ollama peut assurer le service courant, tandis que llama.cpp autonome convient aux expérimentations contrôlées. Avant de comparer les performances, vérifiez l’adéquation du modèle, de la quantification, du contexte et du matériel. Le reste de cette comparaison évalue le flux de travail, le matériel, l’intégration et le déploiement, et non un benchmark inventé.
Ollama et llama.cpp se situent à des couches différentes
L’inférence désigne l’exécution d’un modèle déjà entraîné pour produire une sortie ; un moteur d’inférence effectue ce calcul. llama.cpp est une bibliothèque et une boîte à outils portables en C/C++. Sa bibliothèque principale accompagne des outils en ligne de commande et llama-server, qui inclut une interface Web. Il fournit également des utilitaires de conversion et de quantification, ainsi que la distribution officielle llama. llama.cpp n’est donc pas uniquement un outil en ligne de commande.
Ollama est un service et un outil d’exécution de modèles qui encadre l’inférence par un flux de travail défini. Il gère l’acquisition et le stockage des modèles, applique les modèles de prompt (templates) ou Modelfiles, et planifie l’inférence. L’accès à l’API et certains backends sélectionnés relèvent du même service. Ollama n’est donc pas simplement une interface graphique ; la gestion du cycle de vie des modèles est au cœur du produit.
Une carte simplifiée des couches
| Chemin | Modèle mental en couches |
|---|---|
| Voie Ollama | Application ou CLI → API Ollama, cycle de vie des modèles, templates et planification → composant d’inférence intégré (chemin GGUF actuel : llama-server épinglé) → backend matériel sélectionné |
| Voie llama.cpp | Application, CLI ou interface Web → bibliothèque llama.cpp ou llama-server → build/backend et paramètres d’exécution sélectionnés directement → matériel |
Modèle mental simplifié, non une architecture complète. Description accessible : Ollama ajoute la gestion des modèles et l’orchestration du service au-dessus des composants d’inférence intégrés, tandis que llama.cpp expose sa bibliothèque et son serveur plus près des contrôles matériels.
Selon la vérification effectuée le 5 septembre 2026, le chemin GGUF publié par Ollama lance un llama-server amont intégré et épinglé sous sa couche de service. En raccourci, llama.cpp fournit le moteur et les outils de réglage, tandis qu’Ollama les regroupe dans un véhicule prêt à l’emploi avec un tableau de bord plus simple. Cette analogie explique l’abstraction, mais pas chaque composant ni chaque chemin de modèle.
📝 Remarque : Intégrer un llama-server épinglé ne rend pas Ollama identique au llama.cpp amont. Ollama fournit toujours ses propres valeurs par défaut, templates, planification et API publique. Les chemins non GGUF ou expérimentaux peuvent aussi différer.
Six termes clés qui facilitent la comparaison
Vous n’avez pas besoin d’un glossaire complet sur l’ingénierie d’inférence. Ces six termes couvrent les choix de modèle, de mémoire et de matériel à venir.
| Terme | Signification en termes simples | Pourquoi cela influence ce choix |
|---|---|---|
| 📦 GGUF | Un conteneur binaire orienté inférence pour les tenseurs et métadonnées de modèles, au cœur de l’écosystème llama.cpp. GGUF ne précise pas en soi un niveau de quantification. | C’est l’artefact portable principal utilisé directement par llama.cpp et une voie d’importation prise en charge par Ollama. |
| 🗜️ Quantification | Représentation des tenseurs du modèle avec une précision réduite, ce qui diminue généralement les besoins en stockage et en mémoire. Les effets sur la qualité et la vitesse varient selon la méthode, le modèle, le backend et la charge de travail. | La quantification choisie peut déterminer si un modèle tient en mémoire et s’il performe bien, indépendamment du runtime. |
| 📏 Longueur de contexte | Le budget de tokens actif disponible pour le modèle, incluant les instructions, les entrées, l’historique et les sorties. | Des contextes actifs plus longs consomment davantage de mémoire ; le maximum annoncé n’est donc pas une capacité gratuite. |
| ⚙️ Backend | Le chemin de calcul spécifique au matériel, comme CUDA, Metal, HIP/ROCm ou Vulkan. | La prise en charge par le runtime et la compilation du meilleur backend pour la machine peut déterminer si l’accélération fonctionne bien. |
| 🚀 Déchargement GPU | Placement des couches ou calculs éligibles du modèle sur un GPU plutôt que de tout garder sur le CPU. | La quantité et le placement du déchargement peuvent modifier l’utilisation de la mémoire et la vitesse davantage que l’enveloppe du service. |
| 🗃️ Cache KV | État d’attention stocké qui permet au modèle de réutiliser le contexte précédent pendant la génération. Son empreinte augmente avec le contexte actif et le nombre de séquences. | Les contextes longs et les utilisateurs simultanés peuvent consommer beaucoup de RAM ou de VRAM au-delà du fichier du modèle lui-même. |
La spécification GGUF décrit l’artefact ; la quantification modifie la représentation de ses tenseurs. Le contexte et le cache KV déterminent son empreinte mémoire, tandis que le backend et le déchargement déterminent où s’effectue le calcul.
Définir les critères avant de comparer
Les deux projets peuvent exécuter des modèles à poids ouverts sur du matériel contrôlé par l’utilisateur et exposer l’inférence via une API. Ces capacités communes ne tranchent pas la comparaison. Utilisez les mêmes huit questions tout au long de l’analyse :
- Quelle part de friction de configuration pouvez-vous accepter avant la première requête utile ?
- Le service doit-il gérer le cycle de vie du modèle, ou devez-vous posséder les fichiers exacts et les choix de lancement ?
- Quel niveau de contrôle bas niveau la charge de travail nécessite-t-elle réellement ?
- Quelle option offre le meilleur ajustement matériel et backend pour cette machine ?
- L’application a-t-elle besoin d’un service HTTP ou d’une intégration en processus plus étroite ?
- Quelles mesures de sécurité opérationnelle doivent entourer le point de terminaison ?
- Qui prendra en charge la maintenance, les mises à jour et la reproductibilité ?
- L’inférence s’exécutera-t-elle sur l’appareil, sur un serveur privé distant ou dans un cloud de fournisseur ?
Les comparaisons de performances exigent le artefact de modèle exact — le fichier converti et les métadonnées exécutés — et non simplement le même nom de famille. Faites correspondre le modèle de rendu et le contexte actif, puis alignez le backend, le comportement de déchargement et le matériel. Utilisez la même version logicielle, le même traitement par lots et les mêmes conditions de concurrence. Ce cadre d’évaluation étant fixé, commencez par la différence la plus visible : le flux de travail quotidien.
Flux de travail au quotidien : commodité gérée contre contrôle explicite
La configuration initiale montre la distinction :
- Ollama fournit des installations packagées sur macOS, Windows et Linux, menant à un flux de travail orienté service avec moins de choix au départ
- La distribution officielle llama, les gestionnaires de paquets et les versions précompilées offrent des chemins accessibles pour llama.cpp
- Les conteneurs et les compilations depuis les sources ajoutent du contrôle lorsque les options packagées ne conviennent pas
Il ne s’agit plus d’opposer « installateur convivial » et « tout compiler », mais llama.cpp expose toujours davantage de décisions concernant l’acquisition, la compilation et le lancement.
Une fois installé, la gestion des modèles rend la différence concrète. La bibliothèque nommée d’Ollama et le comportement de téléchargement à l’exécution simplifient l’acquisition, tandis que le stockage géré, les commandes de cycle de vie et les valeurs par défaut prennent en charge les tâches de maintenance répétitives. llama.cpp part d’un artefact GGUF spécifique, même si les outils actuels peuvent récupérer et mettre en cache des modèles Hugging Face compatibles avec -hf ; son serveur/routeur peut également découvrir des modèles et gérer leur chargement. L’avantage d’Ollama ne tient pas seulement à la présence de fonctionnalités de gestion de modèles, mais à leur intégration dans une routine unique.
Pour la personnalisation, un Modelfile est la recette déclarative d’Ollama. Il identifie le modèle de base et ses paramètres, définit le comportement du prompt ou du système, et attache des adaptateurs. Avec llama.cpp, la reproductibilité commence par un GGUF exact et une compilation précise ; le backend et la configuration de lancement fixent davantage le mécanisme sous-jacent.
Ollama ne se limite pas à sa bibliothèque de modèles. Son flux d’importation accepte les fichiers GGUF pris en charge ainsi que les modèles ou adaptateurs Safetensors, sous réserve des limites d’architecture et de conversion. Le GGUF reste le format portable central de llama.cpp, mais les outils officiels gèrent aussi l’acquisition et la mise en cache.
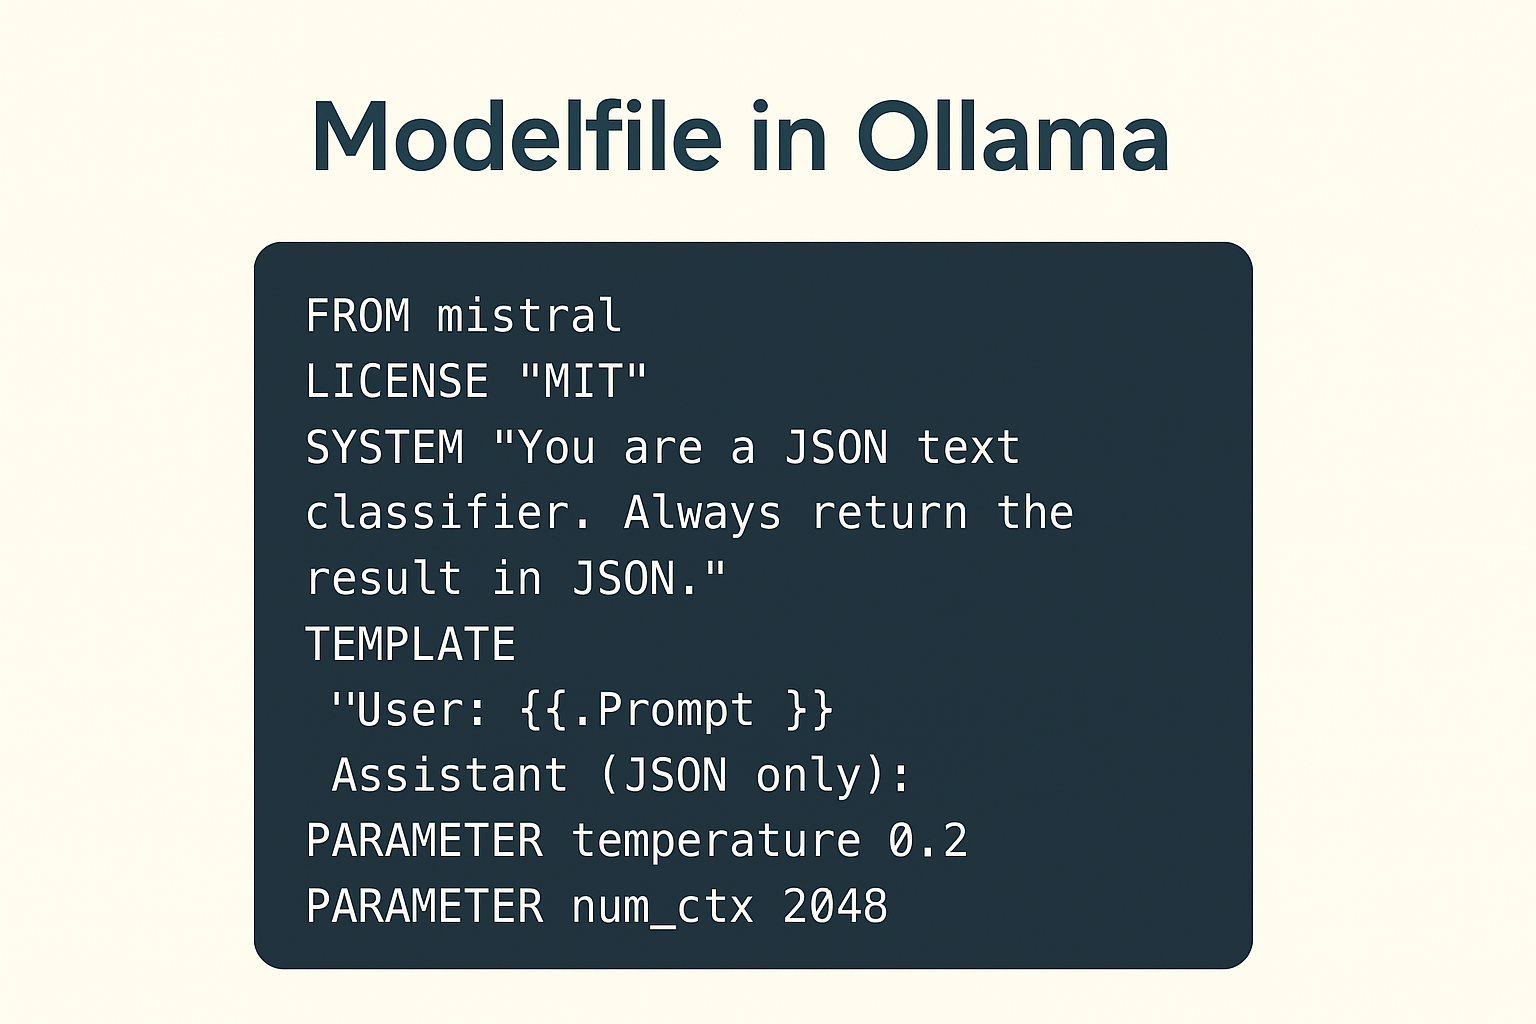
Les mises à jour et la reproductibilité prennent des formes différentes. Ollama peut reproduire une configuration courante grâce à un modèle nommé, un Modelfile et des valeurs par défaut gérées, même si les révisions internes peuvent changer avec une mise à jour. llama.cpp permet aux opérateurs de figer la compilation, l’artefact et les paramètres, mais ceux-ci doivent être maintenus par leurs soins. Le compromis porte sur la charge administrative contre la visibilité : les valeurs par défaut réduisent les décisions récurrentes, tandis que les paramètres explicites rendent les comportements spécialisés plus faciles à inspecter.
Performance, mémoire et matériel : pourquoi il n’existe pas de grand gagnant universel
Un runtime peut se charger rapidement tout en générant lentement, ou traiter efficacement un long prompt tout en peinant avec la génération simultanée. Le chargement à froid, le traitement du prompt et la génération de tokens sont des phases distinctes. Une étiquette « plus rapide » unique masque la phase mesurée et la question de savoir si celle-ci ressemble à la charge de travail réelle.
Même le prompt doit correspondre, au-delà du texte visible. Deux services peuvent recevoir le même message mais produire des modèles de chat, des marqueurs de rôle ou des tokens spéciaux différents. Cela modifie les tokens d’entrée et le travail effectué avant la génération. Le comportement d’échantillonnage et la longueur de sortie ajoutent d’autres différences.
La taille d’un fichier GGUF n’est pas son besoin de mémoire maximal. Les tenseurs du modèle constituent la base, tandis que le cache KV ajoute de la mémoire pour le contexte actif et les séquences. Les tampons de calcul, les adaptateurs et les projecteurs multimodaux ajoutent des frais généraux. Un modèle de brouillon ou d’autres modèles résidents consomment davantage de capacité, et le système d’exploitation a besoin de marge. Des contextes plus longs et davantage de séquences simultanées peuvent donc augmenter sensiblement l’utilisation de la mémoire. Si le modèle ne tient pas, résolvez d’abord le problème de dimensionnement avant de comparer les runtimes.
llama.cpp expose directement le placement des threads, les tailles de contexte et de lot, ainsi que les types de cache KV. Le placement sur les périphériques et les couches GPU, la répartition multi-GPU et les chemins de décodage spéculatif restent des choix de l’opérateur. Ollama automatise davantage, mais expose encore le contexte actif, les requêtes parallèles, la résidence des modèles et la planification GPU. Flash Attention et les contrôles du cache KV restent disponibles via la configuration, les Modelfiles ou les options de l’API. Ces contrôles ne sont utiles que si vous avez une raison de les ajuster.
La prise en charge matérielle résiste également à une notation simple. Ollama fournit les chemins CPU et GPU courants, avec Metal, CUDA, ROCm et Vulkan à titre d’exemples. La matrice de compilation plus large de llama.cpp couvre des cibles courantes et inhabituelles. Un backend documenté peut ne pas être mature ou inclus dans chaque binaire précompilé. Les performances dépendent de la compilation, du pilote, du périphérique et de la manière dont le modèle exploite les noyaux concernés.
⚠️ Avertissement : Un nom de modèle partagé ou une seule capture d’écran de tokens par seconde ne constitue pas une comparaison contrôlée. Des artefacts ou des modèles différents modifient le travail mesuré ; le contexte, les valeurs par défaut et l’état de préchauffage modifient les conditions du test.
Pour une vérification équitable des performances Ollama vs llama.cpp :
- Utilisez exactement le même artefact ou la même somme de contrôle de modèle, la même quantification, le même adaptateur et le même projecteur multimodal, le cas échéant.
- Faites correspondre le modèle de chat et les tokens du prompt rendu, la longueur de sortie demandée et le comportement d’échantillonnage.
- Faites correspondre le contexte, la représentation du cache KV, les paramètres de lot et de micro-lot, les emplacements parallèles, ainsi que les conditions de file d’attente ou de concurrence.
- Faites correspondre la version et la compilation du logiciel, le backend, les pilotes, la sélection des périphériques et le comportement de déport ou de répartition sur GPU.
- Indiquez séparément le chargement à froid, le traitement du prompt à chaud et la génération de tokens.
- Répétez le test dans les conditions de concurrence et la forme de requêtes que votre application réelle utilisera.
Plusieurs GPU ou une quantification à plus faible précision ne garantissent pas une inférence plus rapide. Les interconnexions et les déplacements de mémoire peuvent limiter les configurations multi-GPU, tandis que les noyaux et la forme des requêtes peuvent modifier le résultat. Choisissez une configuration qui tient avec de la marge, puis mesurez la phase et le schéma que votre application utilisera.
APIs et intégration : service d’abord ou boîte à outils d’abord ?
Ollama est conçu principalement comme un service de modèle fonctionnant en continu. Il fournit une API native—sa propre interface de requêtes et de réponses—ainsi que des clients officiels Python et JavaScript. Cela convient à un plugin ou à un outil interne qui a besoin d’un point de terminaison HTTP local stable. Ollama acquiert et charge le modèle, laissant à l’application le soin d’envoyer les requêtes.
Ollama documente certaines routes compatibles OpenAI et Anthropic. La version actuelle de llama-server documente les deux styles aux côtés de points de terminaison opérationnels natifs. Ces couches permettent aux clients existants d’utiliser une structure d’API familière avec un runtime différent.
Un changement d’URL de base de style OpenAI testé peut faire gagner du temps d’intégration ; il ne garantit pas pour autant la prise en charge des fonctionnalités. La sortie structurée et l’utilisation d’outils dépendent de la route, du modèle et du modèle de prompt. Les embeddings ou les entrées multimodales peuvent également dépendre de la version et du client. Testez ces capacités dans le cadre de l’application, et non comme de simples cases à cocher du runtime.
📝 Remarque : « Compatible » signifie certaines routes et certains champs. Testez d’abord le point de terminaison exact et les champs de requête. Vérifiez ensuite le comportement du streaming et les formats d’appels d’outils, puis la gestion des images, les nombres de jetons, les champs de réponse et les erreurs utilisés par votre application.
llama-server est une option de service sérieuse, et non un simple wrapper de démonstration. Son interface Web fournit une surface dans le navigateur, tandis que le décodage parallèle et le batching continu permettent un service partagé. Le routage et le chargement des modèles ajoutent un contrôle du cycle de vie au niveau du serveur ; les routes de compatibilité et les points de terminaison opérationnels natifs complètent l’interface. Il peut être la meilleure couche HTTP lorsque les contrôles directs comptent davantage que la gestion du cycle de vie automatisée d’Ollama.
Lorsque HTTP ne suffit pas, la bibliothèque de style C de llama.cpp permet d’intégrer l’inférence directement dans votre processus. L’application contrôle l’initialisation et l’arrêt, tandis que les paramètres bas niveau restent proches de son code. Ollama fonctionne normalement comme un service séparé. Choisissez llama.cpp lorsque l’inférence doit être livrée à l’intérieur de l’application ; choisissez Ollama lorsqu’un point de terminaison séparé est préférable.
D’un ordinateur portable à un serveur privé toujours actif
Il existe trois limites d’exécution.
- L’inférence sur l’appareil s’exécute sur l’ordinateur portable ou la station de travail qui émet la requête.
- L’auto-hébergement privé à distance s’exécute sur un serveur contrôlé par l’organisation ; il peut préserver le contrôle opérationnel, mais les requêtes traversent un réseau et l’exécution n’est pas locale à l’appareil.
- L’inférence cloud hébergée par un fournisseur s’exécute sur l’infrastructure du fournisseur.
Cette distinction est importante, car les modèles étiquetés cloud d’Ollama s’exécutent dans son cloud, même lorsqu’un client localhost envoie la requête. « Utiliser Ollama » ne prouve pas une exécution locale. Les déploiements strictement locaux doivent exclure ou désactiver les fonctionnalités cloud selon la documentation en vigueur.
Les deux projets sont configurés par défaut pour une exposition réseau locale uniquement. Ollama se lie à l’interface locale, et son API ne dispose d’aucune authentification intégrée. llama-server utilise également par défaut la boucle locale (loopback), accessible uniquement depuis le même hôte, et propose des options de clé API et de TLS. Aucune de ces valeurs par défaut ne constitue une limite de déploiement public complète.
⚠️ Avertissement : l’API locale d’Ollama ne dispose d’aucune authentification intégrée, et les clés factices acceptées par les exemples de compatibilité ne la sécurisent pas. N’exposez jamais directement le point d’accès par défaut sur l’internet public.
Avant de rendre l’un ou l’autre point d’accès accessible à distance, appliquez ces contrôles comme seuil minimal :
- Une adresse de liaison délibérée et une limite de réseau privé ou un VPN.
- Une authentification au niveau du serveur ou d’une passerelle authentifiée.
- TLS pour le transport réseau.
- Des limites de pare-feu, CORS, de taille de requête, de concurrence et de ressources.
- Une supervision des processus, des mises à jour contrôlées, des contrôles de santé et une surveillance.
- Une journalisation, une conservation et une gestion des données respectueuses de la vie privée, évitant la fuite des invites, des réponses ou des identifiants.
Dimensionnez le modèle et la quantification avant d’envisager une capacité GPU louée. Tenez compte du contexte actif et de la concurrence pour estimer la VRAM et la marge opérationnelle. Si un ordinateur portable ne peut pas atteindre l’objectif de performance ou de disponibilité, une infrastructure GPU louée compatible LLM—avec AlexHost comme exemple—devient une option, et non un raccourci contournant le dimensionnement.
Les déclarations de confidentialité des fournisseurs ne sont pas des audits indépendants. Documentez l’endroit où l’inférence s’exécute et les réseaux que traversent les requêtes. Consignez qui administre les systèmes et ce que le stockage ou les journaux conservent. Ce registre définit la limite de confidentialité bien plus clairement que le logo du moteur d’exécution.
Lequel devriez-vous choisir ? Recommandations par cas d’usage
Ces recommandations décrivent l’adéquation à la charge de travail, et non le niveau de compétence. La commodité peut être une exigence d’ingénierie ; le contrôle direct peut représenter une surcharge inutile. Le choix change lorsqu’une exigence spécifique franchit la frontière d’abstraction.
Première expérimentation locale ou outil de développement : Choisissez Ollama lorsque la rapidité de mise en place compte et que vous souhaitez utiliser les modèles par leur nom. Son API prête à l’emploi offre à l’outil une interface stable sans travail de gestion du cycle de vie qui n’apporte rien à l’évaluation ou à l’intégration. Choisissez plutôt llama.cpp si vous avez besoin d’un backend non pris en charge, d’une version de compilation exacte ou d’un paramètre bas niveau non exposé.
Inférence personnalisée reproductible ou application embarquée : Choisissez llama.cpp lorsque le produit doit maîtriser l’artefact et la compilation exacts. Il permet également de contrôler directement l’initialisation et les paramètres d’exécution, ce qui est important lorsque l’inférence fait partie de l’application. Choisissez plutôt Ollama si un service HTTP distinct et un contrôle au niveau du Modelfile répondent pleinement aux besoins du produit.
Matériel contraint ou inhabituel, ou réglage maximal : Commencez par llama.cpp lorsque sa matrice de backends plus large ou son placement explicite résout une exigence identifiée. Vérifiez d’abord que le modèle tient en mémoire. Choisissez Ollama lorsqu’il prend bien en charge le matériel et qu’un réglage direct ajouterait de la maintenance sans contrôle utile ni amélioration mesurée.
Service privé accessible à une équipe : Ollama est généralement le point de départ le moins contraignant pour le cycle de vie et le service, à condition que l’opérateur ajoute une frontière réseau authentifiée. Envisagez llama-server lorsque la gestion native des clés API, les contrôles de service directs ou le réglage des backends sont plus importants. Écartez les deux options si l’équipe ne peut pas satisfaire les exigences de disponibilité permanente décrites ci-dessus.
Utiliser les deux : Conservez Ollama et llama.cpp autonome comme points d’entrée et domaines de cycle de vie distincts. Les applications peuvent sélectionner un point de terminaison testé pour le service courant ou les expérimentations contrôlées, mais ne peuvent pas supposer un comportement d’API identique. Chaque runtime peut conserver son propre stockage de modèles, son port et son processus ; si les deux chargent des modèles, ils peuvent se disputer la RAM ou la VRAM. Ollama n’utilise pas votre service llama.cpp séparé.
La matrice ci-dessous récapitule ces choix. Ne comptez pas les lignes comme des points : une seule exigence impérative peut l’emporter sur tous les avantages de commodité ailleurs.
| Domaine de décision | Ollama | llama.cpp |
|---|---|---|
| 🚀 Démarrage le plus rapide | Parcours d’installation, de modèle et de service intégré | Davantage de choix d’acquisition, de compilation et de lancement restent visibles |
| 🔄 Cycle de vie du modèle | Téléchargements par nom, stockage géré, Modelfiles, résidence et ordonnancement | GGUF direct ou cache Hugging Face, plus contrôles de routeur, de préréglages et de chargement ; moins prescriptif de bout en bout |
| 🎛️ Réglage fin | Valeurs par défaut automatisées avec configuration sélectionnée et contrôles d’API | Contrôle direct plus large sur les compilations, les périphériques, le placement, les caches et les lots |
| 🧩 Intégration en processus | Généralement consommé comme service séparé | La bibliothèque de style C est l’adéquation directe la plus solide |
| 🌐 Service API | API native plus couches de compatibilité ciblées | llama-server avec compatibilité ciblée et routes opérationnelles natives |
| ⚙️ Souplesse des backends | Prise en charge packagée et sélectionnée | Matrice de backends à la compilation plus large, avec réserves de compilation et de maturité |
| 🛠️ Responsabilité opérationnelle | Cycle de vie modèle/service intégré ; authentification externe requise au-delà de l’usage local | Responsabilité explicite du serveur, options natives de clés et de TLS ; durcissement toujours nécessaire |
| 🎯 Charge de travail la mieux adaptée | Service de modèle local ou privé quotidien et reproductible | Inférence embarquée, expérimentale, spécifique au matériel ou finement réglée |
Bottom Line
Les deux pistes présentées au début semblaient contradictoires, car elles attribuent la responsabilité différemment. Choisissez Ollama lorsque le flux de travail intégré constitue la fonctionnalité principale. Choisissez llama.cpp lorsque le contrôle direct de l’inférence est la fonctionnalité recherchée.
En cas de doute, vérifiez que le modèle et la quantification correspondent au matériel. Contrôlez le coût mémoire du contexte prévu, puis commencez avec Ollama. Passez à llama.cpp autonome, ou ajoutez-le, uniquement pour une exigence bas niveau concrète : un backend ou une compilation spécifique, un embedding in-process, ou un placement et un réglage plus fins.