Açık Bilet
 +373 79 600002
 Telegram Canlı Sohbet
 S.S.S
 Türkçe
 English
 Русский
 Română
 Deutsch
 Français
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 tasarruf edin


Ollama vs llama.cpp 2026: Hangi Yerel LLM Çalışma Zamanını Kullanmalısınız?
Bir açık ağırlıklı LLM’i kontrol ettiğiniz donanımda çalıştırmak istiyorsunuz: bir dizüstü bilgisayar, iş istasyonu, ev sunucusu veya özel uzak sunucu. Bir rehber sizi Ollama’ya ve adıyla çekebileceğiniz bir modele yönlendiriyor. Başka bir rehber ise llama.cpp’ye, bir model dosyasına ve çok daha fazla kontrol seçeneğine işaret ediyor.
Ardından iddialar çelişmeye başlıyor. Ollama’ya daha kolay, llama.cpp’ye ise daha hızlı deniyor; biri daha pratik olarak, diğeri ise daha yetenekli olarak çerçeveleniyor. Bu iddialar çoğu zaman farklı modelleri, ayarları, donanımları ya da yazılım yığınının farklı katmanlarını karşılaştırıyor.
Buradaki faydalı soru, hangi adın kazandığı değil; aracın model çalıştırma iş akışının ne kadarını yönetmesi gerektiği ve iş yükünüzün ne kadarını açığa çıkarmasının gerektiği sorusudur.
60 Saniyelik Cevap
Ollama‘yı, entegre bir model çalıştırıcı ve servis istediğinizde seçin. Kurulum, adlandırılmış model edinimi ve depolama tek bir iş akışında birleşir. Varsayılanlar ve özelleştirme tarifleri rutin yapılandırmayı kapsar, hazır bir yerel API ise uygulamalara kararlı bir arayüz sağlar. Düşük seviyeli çalışma zamanı yönetimine ihtiyaç duymayan deneyler, kodlama araçları ve dahili yardımcı programlar için bu genellikle daha temiz bir varsayılan seçenektir.
llama.cpp‘yi doğrudan çıkarım kontrolüne ihtiyacınız olduğunda seçin. Derlemeyi ve donanım arka ucunu seçebilir, tam model yapıtını sabitleyebilir ve süreç, bellek ve ayar kararlarını yönetebilirsiniz. Ayrıca çıkarımı ayrı bir servisten tüketmek yerine gömmesi gereken yazılımlar için de uygundur.
Hiçbiri evrensel bir kazanan değildir: Ollama rutin servisi yönetebilirken, bağımsız llama.cpp kontrollü deneyleri yürütebilir. Performansı karşılaştırmadan önce model, nicemleme, bağlam ve donanım uyumunu doğrulayın. Bu karşılaştırmanın geri kalanı, uydurulmuş bir kıyaslama değil; iş akışını, donanımı, entegrasyonu ve dağıtımı test eder.
Ollama ve llama.cpp Farklı Katmanlarda Yer Alır
Çıkarım (inference), zaten eğitilmiş bir modeli çalıştırarak çıktı üretmek anlamına gelir; bir çıkarım motoru (inference engine) bu hesaplamayı gerçekleştirir. llama.cpp, taşınabilir bir C/C++ kütüphanesi ve araç setidir. Çekirdek kütüphanesi, Web UI içeren komut satırı araçları ve llama-server ile birlikte bulunur. Ayrıca dönüştürme ve nicemleme (quantization) yardımcı programlarını ve resmi llama dağıtımını sunar; dolayısıyla llama.cpp yalnızca CLI değildir.
Ollama, çıkarım etrafında görüşlü bir iş akışı sunan bir model çalıştırıcı ve servistir. Model edinimini ve depolamasını yönetir, şablonları veya Modelfile’ları uygular ve çıkarımı zamanlar. API erişimi ve seçili arka uçlar aynı servise aittir. Bu nedenle Ollama yalnızca grafiksel bir sarmalayıcı değildir; model yaşam döngüsü ürünün merkezindedir.
Basitleştirilmiş bir katman haritası
| Yol | Katmanlı zihinsel model |
|---|---|
| Ollama hattı | Uygulama veya CLI → Ollama API, model yaşam döngüsü, şablonlar ve zamanlama → paketlenmiş çıkarım bileşeni (mevcut GGUF yolu: sabitlenmiş llama-server) → seçilen donanım arka ucu |
| llama.cpp hattı | Uygulama, CLI veya Web UI → llama.cpp kütüphanesi veya llama-server → doğrudan seçilen derleme/arka uç ve çalışma zamanı kontrolleri → donanım |
Basitleştirilmiş zihinsel model; eksiksiz bir mimari değildir. Erişilebilir açıklama: Ollama, paketlenmiş çıkarım bileşenlerinin üzerine model yönetimi ve servis orkestrasyonu ekler; llama.cpp ise kütüphanesini ve sunucusunu donanım kontrollerine daha yakın biçimde sunar.
5 Eylül 2026 tarihinde doğrulandığı üzere, Ollama’nın yayımlanan GGUF yolu, servis katmanının altında paketlenmiş, sabitlenmiş bir upstream llama-server başlatır. Kısaca söylemek gerekirse, llama.cpp motoru ve atölye kontrollerini sağlarken, Ollama bu mekanikleri daha basit bir gösterge paneline sahip, kullanıma hazır bir araca dönüştürür. Bu benzetme soyutlamayı açıklar; her bileşeni veya model yolunu değil.
📝 Not: Sabitlenmiş bir llama-server paketlemek, Ollama’yı upstream llama.cpp ile özdeş yapmaz. Ollama yine kendi varsayılanlarını, şablonlarını, zamanlamasını ve genel API’sini sağlar. GGUF olmayan veya deneysel yollar da farklılık gösterebilir.
Altı Kilit Terim Karşılaştırmayı Kolaylaştırıyor
Tam kapsamlı bir çıkarım mühendisliği sözlüğüne ihtiyacınız yok. Bu altı terim, önümüzdeki model, bellek ve donanım seçimlerini kapsıyor.
| Terim | Sade dille anlamı | Bu seçimi neden etkiler |
|---|---|---|
| 📦 GGUF | Model tensörleri ve meta veriler için çıkarım odaklı ikili bir kapsayıcı formatı olup llama.cpp ekosisteminin merkezindedir. GGUF, kendi başına bir nicemleme (quantization) seviyesi belirtmez. | llama.cpp tarafından doğrudan kullanılan ana taşınabilir dosya formatıdır ve Ollama için desteklenen bir içe aktarma yoludur. |
| 🗜️ Nicemleme (Quantization) | Model tensörlerinin daha düşük hassasiyetle temsil edilmesi; genellikle depolama ve bellek ihtiyacını azaltır. Kalite ve hız üzerindeki etkiler yönteme, modele, backend’e ve iş yüküne göre değişir. | Seçilen nicemleme, çalışma zamanından bağımsız olarak bir modelin sığıp sığmayacağını ve iyi performans gösterip göstermeyeceğini değiştirebilir. |
| 📏 Bağlam uzunluğu (Context length) | Modelin talimatlar, girdi, geçmiş ve çıktı için kullanabildiği aktif token bütçesi. | Daha büyük aktif bağlamlar daha fazla bellek tüketir; bu yüzden reklam edilen maksimum değer ücretsiz kapasite anlamına gelmez. |
| ⚙️ Backend | CUDA, Metal, HIP/ROCm veya Vulkan gibi donanıma özgü hesaplama yolu. | Makine için en iyi backend’in çalışma zamanı ve derleme desteği, hızlandırmanın iyi çalışıp çalışmayacağını belirleyebilir. |
| 🚀 GPU offloading (GPU’ya aktarma) | Uygun model katmanlarını veya hesaplamayı, tüm işi CPU’da tutmak yerine bir GPU’ya yerleştirme. | Aktarılan miktar ve yerleşim, hizmet sarmalayıcısından daha fazla bellek kullanımını ve hızı değiştirebilir. |
| 🗃️ KV cache | Modelin üretim sırasında daha önceki bağlamı yeniden kullanmasını sağlayan, depolanmış dikkat (attention) durumu. Kapladığı alan aktif bağlam ve dizi sayısıyla birlikte büyür. | Uzun bağlamlar ve eşzamanlı kullanıcılar, model dosyasının kendisinin ötesinde önemli miktarda RAM veya VRAM tüketebilir. |
GGUF spesifikasyonu bu dosya formatını tanımlar; nicemleme ise tensörlerinin nasıl temsil edildiğini değiştirir. Bağlam ve KV cache bellek kullanımını şekillendirir, backend ve offloading ise hesaplamanın nerede çalışacağını belirler.
Установите критерии перед сравнением
Хотя это текст на английском, целевой язык — турецкий. Ниже перевод на турецкий.
Önce Karşılaştırma Kriterlerini Belirleyin
Her iki proje de açık ağırlıklı modelleri kullanıcı kontrolündeki donanımda çalıştırabilir ve çıkarımı bir API üzerinden sunabilir. Bu ortak yetenekler karşılaştırmayı belirlemez. Tüm süreçte aynı sekiz soruyu kullanın:
- İlk kullanışlı isteğe kadar kurulum zorluğunu ne kadar kabul edebilirsiniz?
- Hizmet model yaşam döngüsüne sahip olmalı mı, yoksa tam dosyalara ve başlatma seçeneklerine siz mi sahip olmalısınız?
- İş yükü gerçekten ne kadar düşük seviyeli kontrol gerektiriyor?
- Hangi seçenek bu makine için doğru donanım ve arka uç uyumuna sahip?
- Uygulama bir HTTP hizmetine mi yoksa daha sıkı süreç içi entegrasyona mı ihtiyaç duyuyor?
- Uç noktayı hangi operasyonel güvenlik önlemleri çevrelemeli?
- Bakımı, güncellemeleri ve tekrarlanabilirliği kim yönetecek?
- Çıkarım cihaz üzerinde, uzak özel bir sunucuda veya satıcının bulut ortamında mı çalışacak?
Performans karşılaştırmaları, yalnızca aynı model ailesi adı değil, çalıştırılan tam model yapısının—dönüştürülmüş dosya ve çalıştırılan meta veriler—kullanılmasını gerektirir. Oluşturulan şablonu ve etkin bağlamı eşleştirin, ardından arka ucu, boşaltma (offload) davranışını ve donanımı hizalayın. Aynı yazılım sürümünü, toplu işleme (batching) ve eşzamanlılık koşullarını kullanın. Bu ölçüt sabitlendikten sonra, en göze çarpan farkla başlayın: günlük iş akışı.
Günlük İş Akışı: Yönetilen Kolaylık ile Açık Kontrol Arasında
İlk kurulum bu ayrımı gösterir:
- Ollama, macOS, Windows ve Linux genelinde paketlenmiş kurulumlar sunar ve daha az erken seçimle bir servis iş akışına geçer
- Resmî llama dağıtımı, paket yöneticileri ve hazır sürümler llama.cpp için erişilebilir yollar sağlar
- Konteynerler ve kaynak kod derlemeleri, paketlenmiş seçenekler uygun olmadığında daha fazla kontrol ekler
Bu artık “dostane kurucu programa karşı her şeyi derlemek” meselesi değil, ancak llama.cpp yine de daha fazla edinme, derleme ve başlatma kararı sunar.
Kurulumdan sonra model yönetimi bu ayrımı somutlaştırır. Ollama’nın adlandırılmış kütüphanesi ve çalıştırırken otomatik çekme davranışı edinmeyi kolaylaştırır; yönetilen depolama, yaşam döngüsü komutları ve varsayılanlar ise tekrarlayan bakım işlerini yönetir. llama.cpp belirli bir GGUF dosyasıyla başlar, ancak güncel araçlar uyumlu Hugging Face modellerini -hf ile indirip önbelleğe alabilir; sunucusu/yönlendiricisi de modelleri keşfedip yüklemeyi yönetebilir. Ollama’nın avantajı yalnızca model yönetimi özelliklerine sahip olması değil, bunları tek bir rutinde birleştirmesidir.
Özelleştirme için Modelfile, Ollama’nın bildirimsel tarifidir. Temel modeli ve parametreleri belirtir, istem veya sistem davranışını tanımlar ve adaptörleri ekler. llama.cpp ile tekrarlanabilirlik tam bir GGUF dosyası ve derlemeyle başlar; arka uç ve başlatma yapılandırması altta yatan mekanizmanın daha fazlasını sabitler.
Ollama yalnızca model kütüphanesiyle sınırlı değildir. Ürünün içe aktarma iş akışı, mimari ve dönüştürme sınırlarına bağlı olarak desteklenen GGUF dosyalarını ve Safetensors modellerini veya adaptörlerini kabul eder. GGUF, llama.cpp’nin merkezi taşınabilir biçimi olmaya devam eder, ancak resmî araçlar edinme ve önbelleğe almayı da üstlenir.
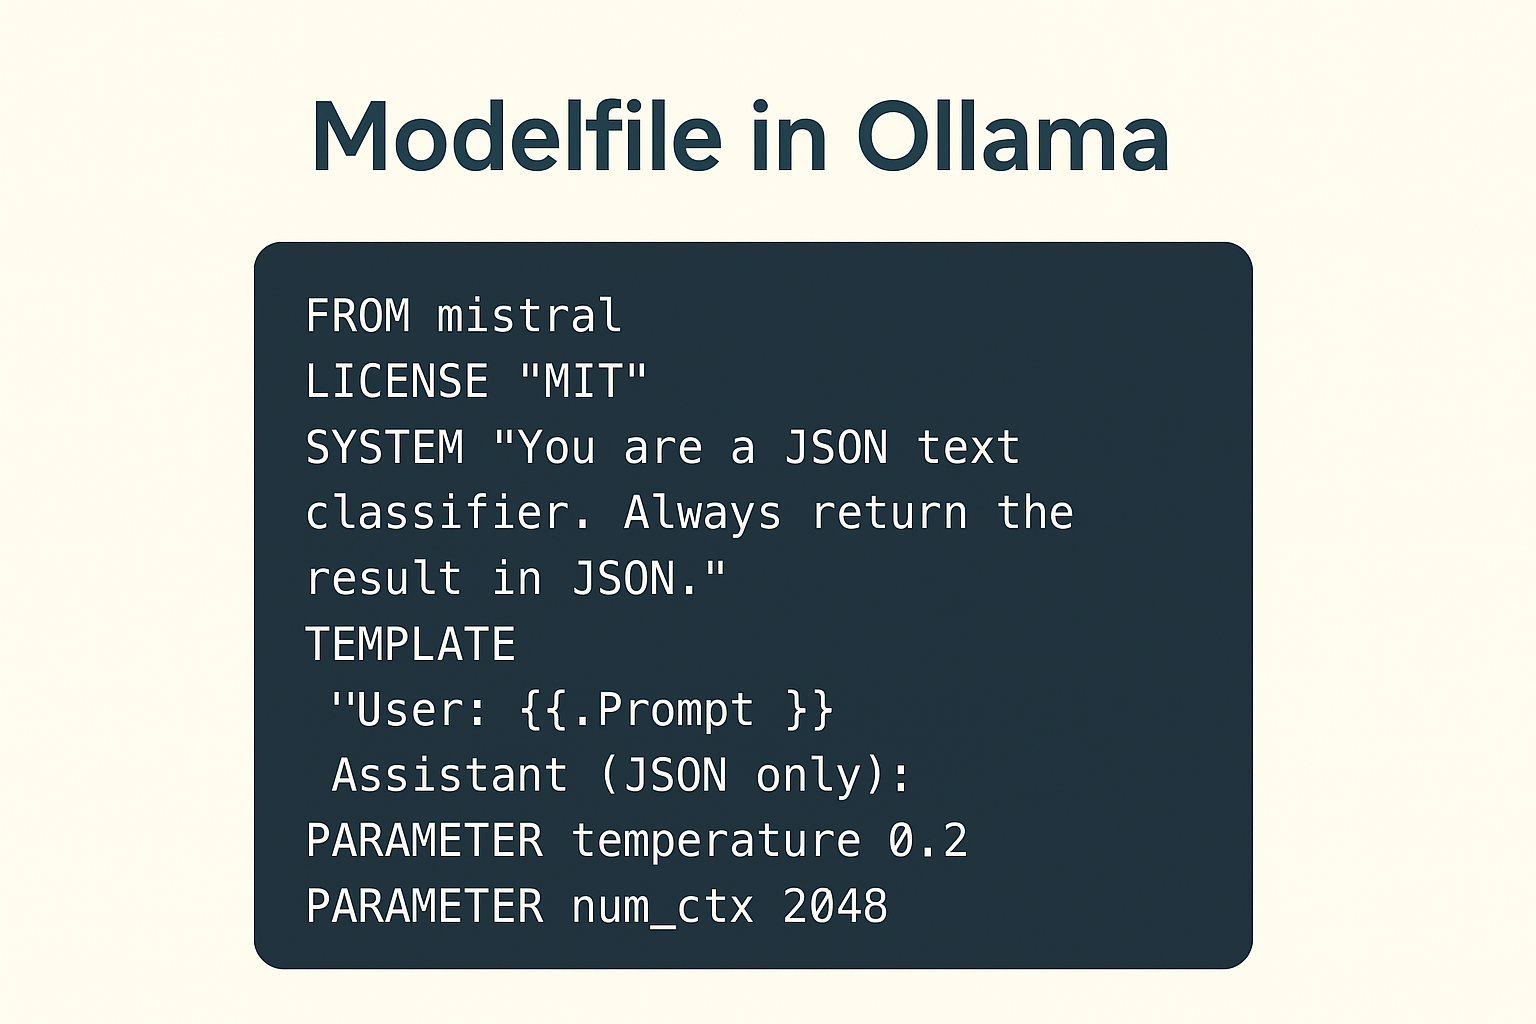
Güncellemeler ve tekrarlanabilirlik farklı biçimlerde ortaya çıkar. Ollama, adlandırılmış bir model, Modelfile ve yönetilen varsayılanlar aracılığıyla günlük bir kurulumu yeniden üretebilir; ancak dahili revizyonlar bir güncellemeyle değişebilir. llama.cpp ise operatörlerin derlemeyi, artifact’i ve ayarları sabitlemesine izin verir, fakat bu ayrıntıları kendilerinin sürdürmesi gerekir. Ödünleşim, yönetim yükü ile görünürlük arasındadır: varsayılanlar tekrarlayan kararları azaltır, açık ayarlar ise özelleşmiş davranışın incelenmesini kolaylaştırır.
Performans, Bellek ve Donanım: Neden Evrensel Bir Kazanan Yok
Bir çalışma zamanı modeli hızlı yükleyebilir ama yavaş üretebilir; uzun bir istemi verimli işleyebilir ama eşzamanlı üretimde zorlanabilir. Soğuk yükleme, istem işleme ve token üretimi ayrı aşamalardır. Tek bir “daha hızlı” etiketi, ölçülen aşamayı ve bunun gerçek iş yükünü temsil edip etmediğini gizler.
İstem, görünen metnin altında da eşleşmelidir. İki hizmet aynı mesajı alsa bile farklı sohbet şablonları, rol işaretçileri veya özel tokenlar uygulayabilir. Bu, üretimden önceki girdi tokenlarını ve iş yükünü değiştirir. Örnekleme davranışı ve çıktı uzunluğu da başka farklılıklar yaratır.
Bir GGUF dosyasının boyutu, zirve bellek gereksinimi değildir. Model tensörleri temel taban oluştururken, KV önbelleği aktif bağlam ve diziler için ek bellek kullanır. Hesaplama tamponları, adaptörler ve çok modlu projeksiyon katmanları ek yük getirir. Taslak model veya diğer kalıcı modeller daha fazla kapasite tüketir, işletim sistemi ise boş alana ihtiyaç duyar. Daha uzun bağlamlar ve daha fazla eşzamanlı dizi, bellek kullanımını önemli ölçüde artırabilir. Model sığmıyorsa, çalışma zamanlarını karşılaştırmadan önce boyutlandırma sorununu çözün.
llama.cpp; iş parçacığı yerleşimini, bağlam ve toplu iş boyutlarını ile KV önbellek türlerini doğrudan sunar. Cihaz ve GPU katman yerleşimi, çoklu GPU bölme ve spekülatif yollar da operatörün seçimi olarak kalır. Ollama daha fazla işi otomatikleştirir, ancak yine de aktif bağlamı, paralel istekleri, model kalıcılığını ve GPU zamanlamasını gösterir. Flash Attention ve KV önbellek denetimleri yapılandırma, Modelfile’lar veya API seçenekleri üzerinden kullanılabilir. Bu denetimler yalnızca ayar yapmak için bir nedeniniz olduğunda yararlıdır.
Donanım desteği de basit bir puanlamaya direnir. Ollama, Metal, CUDA, ROCm ve Vulkan gibi örneklerle yaygın CPU ve GPU yollarını paketler. llama.cpp’nin daha geniş derleme matrisi hem yaygın hem de alışılmadık hedeflere ulaşır. Belgelenmiş bir arka uç olgun olmayabilir veya her hazır ikili dosyada bulunmayabilir. Performans; derlemeye, sürücüye, cihaza ve modelin ilgili çekirdekleri ne kadar iyi kullandığına bağlıdır.
⚠️ Uyarı: Ortak bir model adı veya tek bir saniyedeki token sayısı ekran görüntüsü, kontrollü bir karşılaştırma değildir. Farklı yapılar veya şablonlar ölçülen işi değiştirir; bağlam, varsayılanlar ve ısınma durumu test koşullarını değiştirir.
Adil bir Ollama ile llama.cpp performans kontrolü için:
- Uygulanabilir olduğu yerlerde tamamen aynı model yapısını veya sağlama toplamını, nicemlemeyi, adaptörü ve çok modlu projeksiyon katmanını kullanın.
- Sohbet şablonunu ve işlenmiş istem tokenlarını, istenen çıktı uzunluğunu ve örnekleme davranışını eşleştirin.
- Bağlamı, KV önbellek temsilini, toplu ve mikro toplu ayarlarını, paralel yuvaları ve kuyruk veya eşzamanlılık koşullarını eşleştirin.
- Yazılım sürümünü ve derlemeyi, arka ucu, sürücüleri, cihaz seçimini ve GPU yükleme veya bölme davranışını eşleştirin.
- Soğuk yüklemeyi, ısıtılmış istem işlemeyi ve token üretimini ayrı ayrı raporlayın.
- Testi, gerçek uygulamanın kullanacağı eşzamanlılık ve istek biçimi altında tekrarlayın.
Birden fazla GPU veya daha düşük bitli nicemleme, daha hızlı çıkarım garantisi vermez. Bağlantılar ve bellek hareketi çoklu GPU kurulumlarını sınırlayabilir; çekirdekler ve istek biçimi ise sonucu değiştirebilir. Yeterli boşluk bırakarak sığan bir yapılandırma seçin, ardından uygulamanızın kullanacağı aşamayı ve örüntüyü ölçün.
API’ler ve Entegrasyon: Önce Servis mi, Önce Araç Seti mi?
Ollama, öncelikle uzun süre çalışan bir model servisi olarak tasarlanmıştır. Kendi istek ve yanıt yapısına sahip yerel bir API’yi ve resmi Python ile JavaScript istemcilerini sunar. Bu yapı, kararlı bir yerel HTTP uç noktasına ihtiyaç duyan bir eklenti veya dahili araç için uygundur. Ollama modeli edinir ve yükler; istekleri göndermek ise uygulamaya kalır.
Ollama, seçili OpenAI uyumlu ve Anthropic uyumlu rotaları belgelemektedir. Güncel llama-server, operasyonel yerel uç noktaların yanında her iki stili de belgelemektedir. Bu katmanlar, mevcut istemcilerin farklı bir çalışma zamanıyla da tanıdık bir API yapısını kullanmasına olanak tanır.
Test edilmiş bir OpenAI tarzı temel URL değişikliği entegrasyon çalışmasından tasarruf sağlayabilir; ancak özellik desteğini tek başına garanti etmez. Yapılandırılmış çıktı ve araç kullanımı; rotaya, modele ve prompt şablonuna bağlıdır. Gömmeler (embeddings) veya çok modlu girdi de derlemeye ve istemciye bağlı olabilir. Bu yetenekleri çalışma zamanı onay kutuları olarak değil, uygulamanın bir parçası olarak test edin.
📝 Not: “Uyumlu”, seçili rotaları ve alanları ifade eder. Önce tam uç noktayı ve istek alanlarını test edin. Ardından akış davranışını ve araç çağrısı biçimlerini doğrulayın; ardından uygulamanızın kullandığı görüntü işleme, token sayıları, yanıt alanları ve hataları kontrol edin.
llama-server, bir demo sarmalayıcı değil, ciddi bir sunum seçeneğidir. Web arayüzü tarayıcı tabanlı bir yüzey sağlarken, paralel kod çözme ve sürekli toplu işleme paylaşımlı sunumu destekler. Model yönlendirme ve yükleme, sunucu düzeyinde yaşam döngüsü kontrolü ekler; uyumluluk rotaları ve operasyonel yerel uç noktalar arayüzü tamamlar. Doğrudan kontroller, Ollama’nın yönetilen yaşam döngüsünden daha önemli olduğunda, daha iyi bir HTTP katmanı olabilir.
HTTP yeterli olmadığında, llama.cpp’nin C tarzı kütüphanesi çıkarımı (inference) uygulamanızın içine gömebilir. Uygulama başlatma ve kapatma işlemlerini kontrol eder, düşük seviyeli ayarlar ise kodunuza yakın kalır. Ollama normalde ayrı bir servistir. Çıkarımın uygulamanın içinde taşınması gerektiğinde llama.cpp’yi, ayrı bir uç nokta tercih edildiğinde ise Ollama’yı seçin.
Dizüstü Bilgisayardan Her Zaman Açık Özel Sunucuya
Üç yürütme sınırı vardır.
- Cihaz üzerinde çıkarım (on-device inference), isteği yapan dizüstü bilgisayarda veya iş istasyonunda çalışır.
- Uzak özel self-hosting, kuruluşun kontrolündeki bir sunucuda çalışır; operasyonel kontrolü koruyabilir, ancak istekler bir ağ üzerinden geçer ve yürütme cihaz üzerinde yerel değildir.
- Satıcı tarafından barındırılan bulut çıkarımı (vendor-hosted cloud inference), sağlayıcının altyapısında çalışır.
Bu ayrım önemlidir, çünkü Ollama’nın bulut etiketli modelleri, isteği localhost istemcisi gönderse bile bulutta çalışır. “Ollama kullanmak” yerel yürütmeyi kanıtlamaz. Katı yerel dağıtımlar, güncel dokümantasyona göre bulut işlevselliğini hariç tutmalı veya devre dışı bırakmalıdır.
Her iki proje de varsayılan olarak yalnızca yerel ağ erişimine izin verir. Ollama yerel olarak bağlanır ve API’si yerleşik kimlik doğrulamaya sahip değildir. llama-server da varsayılan olarak loopback’e bağlanır—yalnızca aynı ana bilgisayardan erişilebilir—ve API anahtarı ile TLS seçenekleri sunar. Hiçbir varsayılan ayar tam bir genel dağıtım sınırı değildir.
⚠️ Uyarı: Ollama’nın yerel API’sinde yerleşik kimlik doğrulama yoktur ve uyumluluk örneklerinin kabul ettiği yer tutucu anahtarlar onu güvence altına almaz. Ham varsayılan uç noktayı asla doğrudan internete açmayın.
Herhangi bir uç noktayı uzaktan erişilebilir hale getirmeden önce, minimum kontrol olarak şu önlemleri kullanın:
- Bilinçli bir bind adresi ve özel ağ sınırı veya VPN.
- Sunucuda veya kimlik doğrulamalı bir gateway’de kimlik doğrulama.
- Ağ iletimi için TLS.
- Firewall, CORS, istek boyutu, eşzamanlılık ve kaynak limitleri.
- Süreç denetimi, kontrollü güncellemeler, sağlık kontrolleri ve izleme.
- İstemlerin, yanıtların veya kimlik bilgilerinin sızmasını önleyen, gizlilik odaklı loglama, saklama ve veri işleme.
Kiralık GPU kapasitesini düşünmeden önce modeli ve quantization düzeyini boyutlandırın. Aktif bağlamı ve eşzamanlılığı hesaba katarak VRAM ve işletme payını tahmin edin. Dizüstü bilgisayar performans veya çalışma süresi hedefini karşılayamazsa, LLM destekli kiralık GPU altyapısı—örnek olarak AlexHost—bir seçenek olur, ancak boyutlandırmayı atlamanın bir kısayolu değildir.
Satıcıların gizlilik beyanları bağımsız denetim değildir. Çıkarımın nerede çalıştığını ve isteklerin hangi ağlardan geçtiğini belgeleyin. Sistemleri kimin yönettiğini ve hangi depolama alanlarının veya logların tutulduğunu kaydedin. Bu kayıt, gizlilik sınırını çalışma zamanı logosundan daha net tanımlar.
Hangisini Seçmelisiniz? Kullanım Senaryosuna Göre Öneriler
Bu öneriler beceri düzeyini değil, iş yükü uyumunu anlatır. Kolaylık bir mühendislik gereksinimi olabilir; doğrudan kontol ise gereksiz ek yük olabilir. Belirli bir gereksinim soyutlama sınırını aştığında seçim değişir.
İlk yerel deney veya geliştirici aracı: Hızlı kurulum önemliyse ve modelleri isimleriyle kullanmak istiyorsanız Ollama’yı seçin. Hazır API, değerlendirmeye veya entegrasyona yardımcı olmayan yaşam döngüsü işleri olmadan araca kararlı bir arayüz sağlar. Desteklenmeyen bir arka uç, tam derleme sürümü veya açığa çıkarılmamış düşük seviyeli bir ayara ihtiyacınız varsa bunun yerine llama.cpp’yi seçin.
Tekrarlanabilir özel çıkarım veya gömülü uygulama: Ürünün tam artefaktı ve derlemesine sahip olması gerektiğinde llama.cpp’yi seçin. Çıkarım uygulamanın içinde çalıştığında önemli olan başlatma ve çalışma zamanı ayarlarını da doğrudan kontrol eder. Ayrı bir HTTP servisi ve Modelfile düzeyinde kontrol ürünün ihtiyaçlarını tamamen karşılıyorsa bunun yerine Ollama’yı seçin.
Kısıtlı veya alışılmadık donanım ya da azami ayarlama: llama.cpp’nin daha geniş arka uç matrisi veya açık yerleştirme, adı belirtilmiş bir gereksinimi çözüyorsa llama.cpp ile başlayın. Önce modelin sığdığını doğrulayın. Ollama donanımı iyi desteklediğinde ve doğrudan ayarlama, faydalı bir kontrol veya ölçülmüş bir iyileşme olmadan bakım yükü ekleyeceğinde Ollama’yı seçin.
Ekip erişimli özel servis: Ollama, operatör kimlik doğrulamalı bir ağ sınırı eklediği sürece yaşam döngüsü ve sunum için genellikle daha düşük sürtünmeli başlangıç noktasıdır. Yerel API anahtarlaması, doğrudan sunum kontrolleri veya arka uç ayarlaması daha önemli olduğunda llama-server‘ı değerlendirin. Ekip yukarıdaki sürekli çalışma gereksinimlerini karşılayamıyorsa her iki seçeneği de reddedin.
İkisini birlikte kullanın: Ollama ile bağımsız llama.cpp’yi ayrı giriş noktaları ve yaşam döngüsü alanları olarak tutun. Uygulamalar rutin sunum veya kontrollü deneyler için test edilmiş bir uç nokta seçebilir, ancak aynı API davranışını varsayamaz. Her çalışma zamanı kendi model depolamasını, bağlantı noktasını ve sürecini tutabilir; ikisi de model barındırıyorsa RAM veya VRAM için yarışabilirler. Ollama, ayrı llama.cpp servisinizi kullanmaz.
Aşağıdaki tablo bu seçimleri özetler. Satırları puan olarak saymayın: tek bir zorunlu gereksinim, diğer yerlerdeki tüm kolaylıkları geride bırakabilir.
| Karar alanı | Ollama | llama.cpp |
|---|---|---|
| 🚀 En hızlı başlangıç | Entegre kurulum, model ve servis yolu | Edinme, derleme ve başlatma seçenekleri görünür kalır |
| 🔄 Model yaşam döngüsü | Adlandırılmış indirmeler, yönetilen depolama, Modelfile’lar, bellekte kalma ve zamanlama | Doğrudan GGUF veya Hugging Face önbelleği artı yönlendirici, ön ayar ve yükleme kontrolleri; uçtan uca daha az görüşlü |
| 🎛️ Ayrıntılı ayarlama | Seçilmiş yapılandırma ve API kontrolleriyle otomatik varsayılanlar | Derlemeler, cihazlar, yerleştirme, önbellekler ve gruplar üzerinde daha geniş doğrudan kontrol |
| 🧩 Süreç içi gömme | Normalde ayrı bir servis olarak kullanılır | C tarzı kütüphane daha güçlü doğrudan uyumdur |
| 🌐 API servisi | Yerel API ve kapsamlı uyumluluk katmanları | Kapsamlı uyumluluk ve yerel operasyonel rotalarla llama-server |
| ⚙️ Arka uç esnekliği | Seçilmiş paketlenmiş destek | Derleme zamanı arka uç matrisi daha geniş; derleme ve olgunluk uyarılarıyla |
| 🛠️ Operasyonel sorumluluk | Entegre model/servis yaşam döngüsü; yerel kullanımın ötesinde harici kimlik doğrulama gerekli | Daha açık sunucu sahipliği ve yerel anahtar/TLS seçenekleri; yine de sertleştirme gerekli |
| 🎯 En uygun iş yükü | Tekrarlanabilir günlük yerel veya özel model servisi | Gömülü, deneysel, donanıma özgü veya derinlemesine ayarlanmış çıkarım |
Bottom Line
Las dos rutas del inicio parecían contradictorias porque asignan la propiedad de forma diferente. Elija Ollama cuando el flujo de trabajo integrado sea en sí mismo la característica. Elija llama.cpp cuando el control directo sobre la inferencia sea la característica.
Si no está seguro, confirme que el modelo y la cuantización se ajustan al hardware. Verifique el costo de memoria del contexto previsto y luego comience con Ollama. Pase a llama.cpp independiente, o añádalo, solo para un requisito concreto de bajo nivel: un backend o compilación específicos, incrustación en el proceso o una ubicación y ajuste más finos.