Bilet deschis
 +373 79 600002
 Telegramă Chat live
 F.A.Q
 Română
 English
 Русский
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 la toate serviciile de găzduire


Ollama vs llama.cpp în 2026: Ce runtime pentru LLM local ar trebui să folosești?
Ви хочете запускати LLM з відкритими вагами на обладнанні, яким ви керуєте: ноутбуці, робочій станції, домашньому сервері або приватному віддаленому сервері. Один посібник рекомендує Ollama і модель, яку можна завантажити за назвою. Інший рекомендує llama.cpp, файл моделі та значно більше налаштувань.
Потім твердження починають суперечити одне одному. Ollama називають простішим, а llama.cpp — швидшим; один інструмент подають як практичніший, а інший — як потужніший. Ці твердження часто порівнюють різні моделі, налаштування, обладнання або рівні програмного стеку.
Корисне запитання полягає не в тому, яка назва перемагає, а в тому, скільки процесу запуску моделі має керувати інструмент, і наскільки вашому навантаженню потрібен доступ до цих налаштувань.
Răspunsul în 60 de secunde
Alegeți Ollama atunci când doriți un serviciu și un runner de modele integrat. Configurarea, obținerea modelelor denumite și stocarea au același flux de lucru. Valorile implicite și rețetele de personalizare acoperă configurarea de rutină, iar un API local gata de utilizare oferă aplicațiilor o interfață stabilă. Aceasta este de obicei alegerea implicită mai curată pentru experimente, instrumente de programare și utilitare interne care nu necesită administrarea runtime-ului la nivel jos.
Alegeți llama.cpp atunci când aveți nevoie de control direct asupra inferenței. Puteți selecta build-ul și backend-ul hardware, puteți fixa artefactul exact al modelului și puteți gestiona deciziile legate de proces, memorie și reglaj. De asemenea, se potrivește software-ului care trebuie să integreze inferența, în loc să o consume de la un serviciu separat.
Niciuna dintre opțiuni nu este câștigătoare universal: Ollama poate gestiona serving-ul de rutină, în timp ce llama.cpp independent poate gestiona experimentele controlate. Înainte de a compara performanța, confirmați potrivirea modelului, a cuantizării, a contextului și a hardware-ului. Restul comparației testează fluxul de lucru, hardware-ul, integrarea și implementarea, nu un benchmark inventat.
Ollama și llama.cpp se află pe straturi diferite
Inferența înseamnă rularea unui model deja antrenat pentru a produce un rezultat; un motor de inferență efectuează acest calcul. llama.cpp este o bibliotecă și un set de instrumente portabile în C/C++. Biblioteca sa de bază se află alături de instrumentele din linia de comandă și de llama-server, care include o interfață Web. De asemenea, oferă utilitare de conversie și cuantizare și distribuția oficială llama, deci llama.cpp nu este doar CLI.
Ollama este un serviciu și un utilitar de rulare a modelelor, care înveșmântează inferența într-un flux de lucru opinionat. Gestionează obținerea și stocarea modelelor, aplică șabloane sau Modelfile-uri și programează inferența. Accesul prin API și anumite backend-uri selectate aparțin aceluiași serviciu. Ollama nu este, așadar, doar un wrapper grafic; ciclul de viață al modelului este central pentru produs.
O hartă simplificată a straturilor
| Cale | Model mental pe straturi |
|---|---|
| Calea Ollama | Aplicație sau CLI → API-ul Ollama, ciclul de viață al modelului, șabloane și programare → componenta de inferență inclusă (calea GGUF actuală: llama-server fixat la o versiune) → backend-ul hardware selectat |
| Calea llama.cpp | Aplicație, CLI sau interfață Web → biblioteca llama.cpp sau llama-server → build/backend selectat direct și controale de rulare → hardware |
Model mental simplificat—nu o arhitectură completă. Descriere accesibilă: Ollama adaugă gestionarea modelelor și orchestrarea serviciului deasupra componentelor de inferență incluse, în timp ce llama.cpp expune biblioteca și serverul mai aproape de controalele hardware.
Conform verificării din 5 septembrie 2026, calea GGUF lansată de Ollama pornește un llama-server upstream inclus și fixat la o versiune, sub stratul său de serviciu. Ca o comparație simplificată, llama.cpp oferă motorul și controalele de atelier, în timp ce Ollama împachetează aceste mecanisme într-un vehicul gata de condus, cu un tablou de bord mai simplu. Analogia explică abstractizarea, nu fiecare componentă sau cale a modelului.
📝 Notă: Includerea unui llama-server fixat la o versiune nu face Ollama identic cu llama.cpp upstream. Ollama oferă în continuare propriile valori implicite, șabloane, programare și API public. Căile non-GGUF sau experimentale pot diferi și ele.
Șase termeni cheie care facilitează comparația
Nu aveți nevoie de un glosar complet de inginerie a inferenței. Acești șase termeni acoperă alegerile legate de model, memorie și hardware care urmează.
| Termen | Explicație simplă | De ce influențează această alegere |
|---|---|---|
| 📦 GGUF | Un container binar orientat spre inferență pentru tensorii modelului și metadate, central în ecosistemul llama.cpp. GGUF nu specifică în sine un nivel de cuantizare. | Este principalul artefact portabil utilizat direct de llama.cpp și o cale de import suportată pentru Ollama. |
| 🗜️ Cuantizare | Reprezentarea tensorilor modelului la o precizie mai mică, reducând în general necesarul de stocare și memorie. Efectele asupra calității și vitezei variază în funcție de metodă, model, backend și sarcină de lucru. | Cuantizarea aleasă poate schimba dacă un model încape și performează bine, indiferent de runtime. |
| 📏 Lungimea contextului | Bugetul activ de tokeni disponibil modelului pentru instrucțiuni, date de intrare, istoric și ieșire. | Contextele active mai mari consumă mai multă memorie, deci un maxim anunțat nu înseamnă capacitate gratuită. |
| ⚙️ Backend | Calea de calcul specifică hardware-ului, cum ar fi CUDA, Metal, HIP/ROCm sau Vulkan. | Suportul runtime-ului și al build-ului pentru cel mai bun backend al mașinii poate determina dacă accelerarea funcționează bine. |
| 🚀 Descărcarea pe GPU (GPU offloading) | Plasarea straturilor eligibile ale modelului sau a calculului pe un GPU, în loc să păstrați întreaga sarcină pe CPU. | Cantitatea și plasarea descărcării pot modifica utilizarea memoriei și viteza mai mult decât o face wrapper-ul serviciului. |
| 🗃️ KV cache | Starea de atenție stocată, care permite modelului să reutilizeze contextul anterior în timpul generării. Dimensiunea sa crește odată cu contextul activ și cu numărul de secvențe. | Contextele lungi și utilizatorii concurenți pot consuma RAM sau VRAM considerabil, dincolo de fișierul modelului în sine. |
Specificația GGUF descrie artefactul; cuantizarea modifică modul în care sunt reprezentați tensorii săi. Contextul și KV cache determină amprenta de memorie, în timp ce backend-ul și descărcarea pe GPU determină unde are loc calculul.
Установите критерии перед сравнением
Это текст на английском, а нужна румынская версия. Перевожу:
Stabilirea criteriilor înainte de comparație
Both projects can run open-weight models on user-controlled hardware and expose inference through an API. Those shared abilities do not decide the comparison. Use the same eight questions throughout:
Ах, ошибка в моём ответе выше. Вот корректный перевод всего фрагмента:
Stabilirea criteriilor înainte de comparație
Ambele proiecte pot rula modele open-weight pe hardware controlat de utilizator și pot expune inferența printr-un API. Aceste capacități comune nu decid comparația. Folosiți aceleași opt întrebări pe tot parcursul:
- Cât de mare efort de configurare puteți accepta înainte de prima cerere utilă?
- Ar trebui ca serviciul să gestioneze ciclul de viață al modelului, sau ar trebui să gestionați voi înșivă fișierele exacte și opțiunile de lansare?
- Câtă control la nivel scăzut necesită cu adevărat sarcina de lucru?
- Care opțiune are potrivirea corectă de hardware și backend pentru această mașină?
- Are aplicația nevoie de un serviciu HTTP sau de o integrare în proces mai strânsă?
- Ce siguranță operațională trebuie să înconjoare endpoint-ul?
- Cine se va ocupa de întreținere, actualizări și repetabilitate?
- Va rula inferența pe dispozitiv, pe un server privat la distanță sau într-un cloud al furnizorului?
Comparațiile de performanță necesită artefactul exact al modelului—fișierul convertit și metadatele care sunt rulate—nu doar același nume de familie. Potriviți șablonul randat și contextul activ, apoi aliniați backend-ul, comportamentul de offload și hardware-ul. Folosiți aceeași versiune de software, aceleași condiții de batching și concurență. Odată ce acest set de criterii este fixat, începeți cu cea mai vizibilă diferență: fluxul de lucru zilnic.
Flux de lucru zilnic: comoditatea gestionată versus control explicit
Configurarea inițială arată diferența:
- Ollama oferă instalări pregătite pentru macOS, Windows și Linux, care duc către un flux de lucru bazat pe serviciu, cu mai puține alegeri la început
- Distribuția oficială llama, managerii de pachete și versiunile precompilate oferă căi accesibile către llama.cpp
- Containerele și compilările din surse adaugă control atunci când opțiunile pregătite nu se potrivesc
Aceasta nu mai este diferența dintre „instalatorul prietenos și compilarea totală”, dar llama.cpp expune totuși mai multe decizii legate de obținere, compilare și lansare.
Odată instalat, modul de gestionare a modelelor face diferența mai concretă. Biblioteca cu nume a Ollama și comportamentul de tip pull-on-run simplifică obținerea, în timp ce stocarea gestionată, comenzile de ciclu de viață și valorile implicite se ocupă de întreținerea repetitivă. llama.cpp pornește de la un anumit artefact GGUF, deși instrumentele actuale pot descărca și memora în cache modele Hugging Face compatibile cu -hf; serverul/routerul său poate, de asemenea, descoperi modele și gestiona încărcarea. Avantajul Ollama nu constă doar în existența funcțiilor de gestionare a modelelor, ci în unirea lor într-o singură rutină.
Pentru personalizare, un Modelfile este rețeta declarativă a Ollama. Acesta identifică modelul de bază și parametrii, definește comportamentul promptului sau al sistemului și atașează adaptoare. Cu llama.cpp, repetabilitatea începe cu un GGUF exact și o compilare exactă; backendul și configurația de lansare fixează mai multe detalii ale mecanismului de bază.
Ollama nu se limitează la biblioteca sa de modele. Fluxul său de import acceptă fișiere GGUF suportate și modele sau adaptoare Safetensors, sub rezerva limitărilor de arhitectură și conversie. GGUF rămâne formatul portabil central al llama.cpp, dar instrumentele oficiale se ocupă și de obținere și de cache.
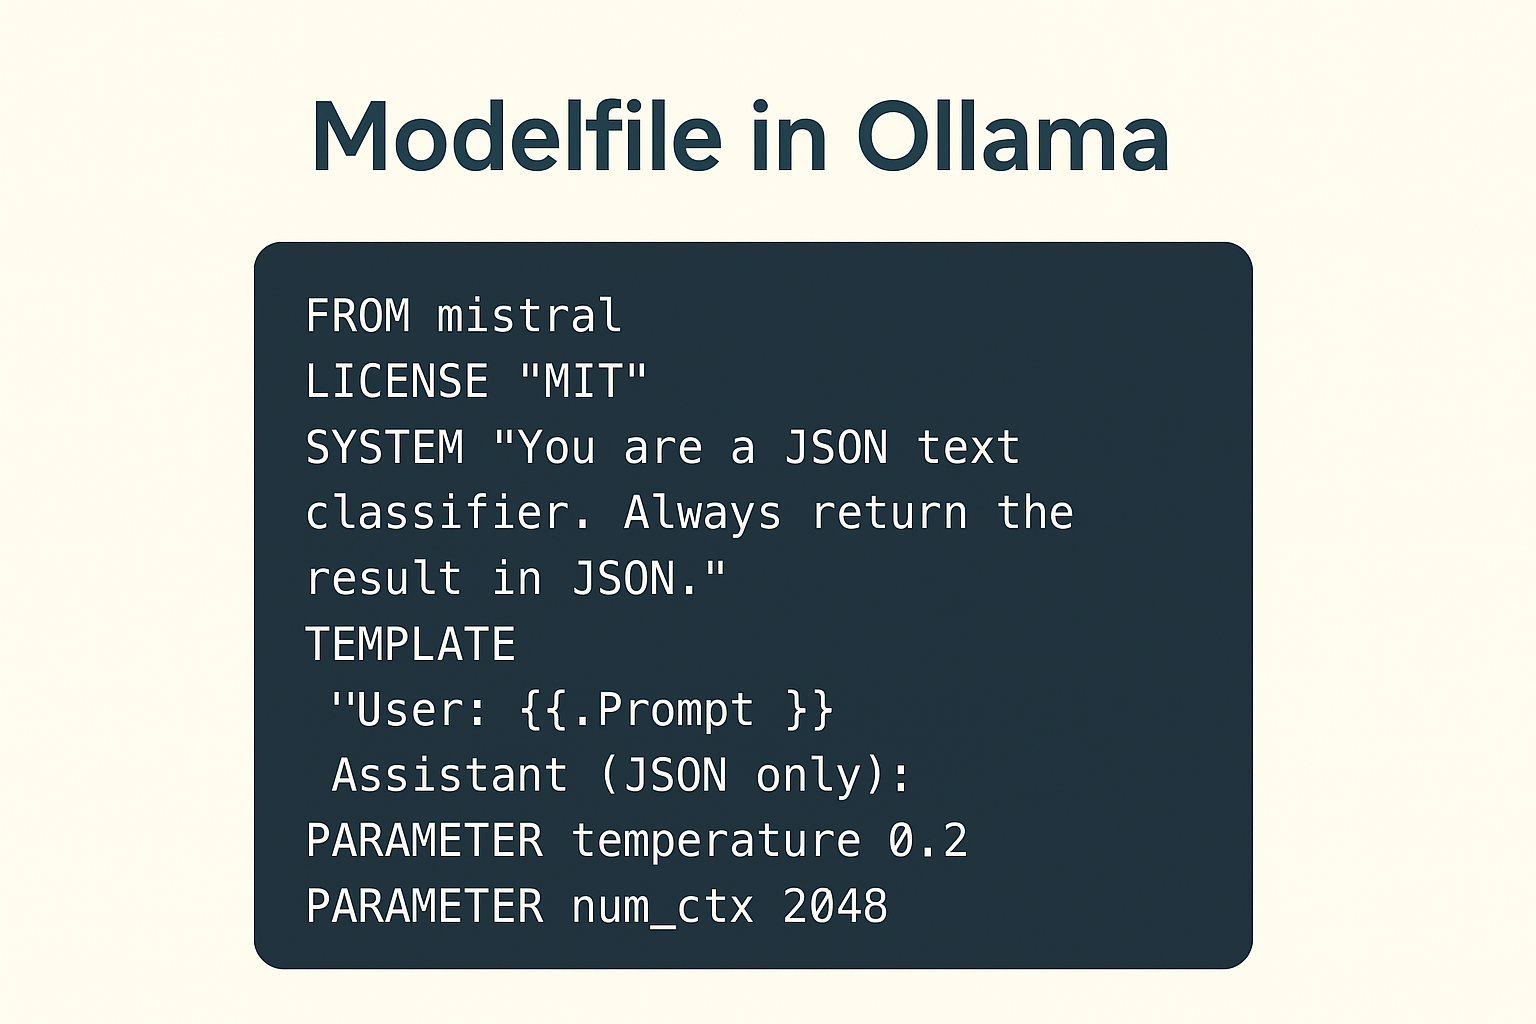
Actualizările și repetabilitatea iau forme diferite. Ollama poate reproduce o configurație obișnuită prin intermediul unui model cu nume, al unui Modelfile și al valorilor implicite gestionate, deși reviziile interne pot să se schimbe odată cu o actualizare. llama.cpp le permite operatorilor să fixeze compilarea, artefactul și setările, dar aceștia trebuie să întrețină aceste detalii. Compromisul constă în sarcina administrativă versus vizibilitate: valorile implicite reduc deciziile recurente, în timp ce setările explicite fac comportamentul specializat mai ușor de inspectat.
Производительность, память и оборудование: почему нет универсального победителя
Ah, wait — the target language is Romanian, so I need to correct the heading and all text accordingly.
Performance, Memory, and Hardware: Why There Is No Universal Winner
Ignore the line above; the correct translation follows.
Performanță, memorie și hardware: de ce nu există un câștigător universal
Un runtime poate încărca rapid, dar poate genera lent, sau poate procesa eficient un prompt lung, dar poate avea dificultăți cu generarea concurentă. Încărcarea la rece, procesarea promptului și generarea tokenilor sunt faze separate. O etichetă generică de tipul „mai rapid” ascunde faza măsurată și faptul dacă aceasta seamănă cu sarcina reală de lucru.
Chiar și promptul trebuie să se potrivească sub textul vizibil. Două servicii pot primi același mesaj, dar pot randa șabloane de chat, marcatori de rol sau tokeni speciali diferiți. Aceasta modifică tokenii de intrare și volumul de lucru dinaintea generării. Comportamentul de eșantionare și lungimea ieșirii adaugă și ele diferențe.
Dimensiunea unui fișier GGUF nu este cerința sa maximă de memorie. Tensorii modelului formează baza, în timp ce cache-ul KV adaugă memorie pentru contextul activ și secvențele active. Buffer-ele de calcul, adaptoarele și proiectorii multimodali adaugă costuri suplimentare. Un model draft sau alte modele rezidente consumă capacitate suplimentară, iar sistemul de operare necesită rezervă. Contextele mai lungi și mai multe secvențe concurente pot, așadar, crește considerabil utilizarea memoriei. Dacă modelul nu încape, rezolvați problema dimensionării înainte de a compara runtime-urile.
llama.cpp expune direct plasarea firelor de execuție, dimensiunile contextului și ale lotului, precum și tipurile cache-ului KV. Plasarea pe dispozitiv și pe straturi GPU, împărțirea pe mai multe GPU-uri și căile speculative rămân, de asemenea, alegeri ale operatorului. Ollama automatizează mai mult, dar expune totuși contextul activ, cererile paralele, reziden�a modelului și programarea GPU. Flash Attention și controalele cache-ului KV rămân disponibile prin configurare, Modelfile-uri sau opțiuni API. Aceste controale sunt utile doar când aveți un motiv să le ajustați.
Suportul hardware rezistă, de asemenea, unei evaluări simple. Ollama include căi CPU și GPU de uz general, cu Metal, CUDA, ROCm și Vulkan ca exemple. Matricea mai largă de build-uri a llama.cpp acoperă atât ținte uzuale, cât și neobișnuite. Un backend documentat poate să nu fie matur sau să nu fie inclus în fiecare binar precompilat. Performanța depinde de build, driver, dispozitiv și de modul în care modelul utilizează kernel-urile relevante.
⚠️ Avertisment: Un nume de model comun sau o singură captură de ecran cu tokeni pe secundă nu reprezintă o comparație controlată. Artefacte sau șabloane diferite modifică volumul de lucru măsurat; contextul, valorile implicite și starea de încălzire modifică condițiile testului.
Pentru o verificare corectă a performanței Ollama vs llama.cpp:
- Utilizați exact același artefact de model sau aceeași sumă de control, aceeași cuantizare, același adaptor și același proiector multimodal, acolo unde este cazul.
- Potriviți șablonul de chat și tokenii promptului randat, lungimea solicitată a ieșirii și comportamentul de eșantionare.
- Potriviți contextul, reprezentarea cache-ului KV, setările de lot și microlot, sloturile paralele și condițiile de coadă sau concurență.
- Potriviți versiunea și build-ul software, backend-ul, driverele, selecția dispozitivului și comportamentul de descărcare pe GPU sau de împărțire.
- Raportați separat încărcarea la rece, procesarea promptului la cald și generarea tokenilor.
- Repetați testul în condițiile de concurență și forma cererilor pe care le va utiliza aplicația reală.
Mai multe GPU-uri sau cuantizarea pe mai puțini biți nu garantează o inferență mai rapidă. Interconexiunile și mișcarea memoriei pot limita configurațiile cu mai multe GPU-uri, iar kernel-urile și forma cererilor pot schimba rezultatul. Alegeți o configurație care încape cu rezervă, apoi măsurați faza și modelul pe care le va utiliza aplicația dumneavoastră.
API-uri și integrare: Mai întâi serviciul sau mai întâi toolkit-ul?
Ollama este conceput în primul rând ca serviciu de model cu rulare de lungă durată. Oferă o API nativă—propria sa suprafață de cereri și răspunsuri—plus clienți oficiali pentru Python și JavaScript. Acest lucru se potrivește unui plugin sau unui instrument intern care are nevoie de un endpoint HTTP local stabil. Ollama achiziționează și încarcă modelul, lăsând aplicația să trimită cereri.
Ollama documentează rute selectate compatibile cu OpenAI și compatibile cu Anthropic. Versiunea actuală a llama-server documentează ambele stiluri alături de endpoint-uri operaționale native. Aceste straturi permit clienților existenți să utilizeze o structură de API familiară cu un runtime diferit.
O schimbare a URL-ului de bază în stil OpenAI, testată, poate economisi munca de integrare; nu stabilește însă suportul pentru funcționalități. Ieșirea structurată și utilizarea instrumentelor depind de rută, model și șablonul de prompt. Embedding-urile sau intrările multimodale pot depinde, de asemenea, de build și de client. Testați aceste capabilități ca parte a aplicației, nu ca simple bife de runtime.
📝 Notă: „Compatibil” înseamnă rute și câmpuri selectate. Testați mai întâi endpoint-ul exact și câmpurile cererii. Apoi verificați comportamentul de streaming și formatele apelurilor de instrumente, urmate de orice gestionare a imaginilor, numărul de token-uri, câmpurile de răspuns și erorile pe care le utilizează aplicația.
llama-server este o opțiune serioasă de servire, nu un wrapper demonstrativ. Interfața sa Web oferă o suprafață de browser, în timp ce decodarea paralelă și batching-ul continuu susțin servirea partajată. Rutarea și încărcarea modelelor adaugă control al ciclului de viață la nivel de server; rutele de compatibilitate și endpoint-urile operaționale native completează interfața. Poate fi stratul HTTP mai bun atunci când controalele directe contează mai mult decât ciclul de viață gestionat al Ollama.
Când HTTP nu este suficient, biblioteca în stil C a llama.cpp poate încorpora inferența în procesul dvs. Aplicația controlează inițializarea și oprirea, în timp ce setările de nivel scăzut rămân aproape de codul ei. Ollama este de obicei un serviciu separat. Alegeți llama.cpp când inferența trebuie livrată în interiorul aplicației; alegeți Ollama când un endpoint separat este preferabil.
De la un laptop la un server privat mereu pornit
Există trei limite de execuție.
- Inferența pe dispozitiv rulează pe laptopul sau stația de lucru care face cererea.
- Self-hosting privat la distanță rulează pe un server controlat de organizație; poate păstra controlul operațional, dar cererile traversează o rețea, iar execuția nu este locală pentru dispozitiv.
- Inferența în cloud, găzduită de furnizor rulează pe infrastructura furnizorului.
Această distincție contează, deoarece modelele cu etichetă cloud ale Ollama rulează în cloud-ul acestuia chiar și atunci când un client localhost trimite cererea. „Folosirea Ollama” nu dovedește execuția locală. Implementările strict locale trebuie să excludă sau să dezactiveze funcționalitatea cloud, conform documentației actuale.
Ambele proiecte au implicit expunere în rețea doar locală. Ollama se leagă local, iar API-ul său nu are autentificare integrată. llama-server folosește de asemenea implicit loopback — accesibil doar de pe aceeași gazdă — și oferă opțiuni pentru cheie API și TLS. Niciuna dintre valorile implicite nu reprezintă o limită completă pentru o implementare publică.
⚠️ Avertisment: API-ul local al Ollama nu are autentificare integrată, iar cheile de tip placeholder acceptate de exemplele de compatibilitate nu îl securizează. Nu expuneți niciodată direct endpoint-ul implicit către internetul public.
Înainte de a face oricare dintre endpoint-uri accesibil de la distanță, folosiți aceste controale ca minim obligatoriu:
- O adresă de bind intenționată și o limită de rețea privată sau VPN.
- Autentificare pe server sau printr-un gateway autentificat.
- TLS pentru transportul în rețea.
- Limite pentru firewall, CORS, dimensiunea cererilor, concurență și resurse.
- Supervizarea proceselor, actualizări controlate, verificări de stare și monitorizare.
- Jurnalizare, retenție și gestionare a datelor conștiente de confidențialitate, care previn scurgerea prompt-urilor, răspunsurilor sau credențialelor.
Dimensionați modelul și cuantizarea înainte de a lua în considerare capacitatea GPU închiriată. Luați în calcul contextul activ și concurența pentru a estima VRAM-ul și marja operațională. Dacă un laptop nu poate atinge ținta de performanță sau de uptime, infrastructura GPU închiriată, compatibilă cu LLM — cu AlexHost ca un exemplu — devine o opțiune, nu o scurtătură față de dimensionare.
Declarațiile de confidențialitate ale furnizorilor nu sunt audituri independente. Documentați unde rulează inferența și ce rețele traversează cererile. Consemnați cine administrează sistemele și ce stocare sau jurnale păstrează. Această evidență definește limita de confidențialitate mai clar decât logo-ul runtime-ului.
Которое из них выбрать? Рекомендации по сценариям использования
Текст выше должен переводиться на румынский язык, а не на русский. Исправляю:
Ce ar trebui să alegeți? Recomandări în funcție de cazul de utilizare
Aceste recomandări descriu potrivirea cu sarcina de lucru, nu nivelul de competență. Comoditatea poate fi o cerință de inginerie; controlul direct poate reprezenta un efort suplimentar inutil. Alegerea se schimbă atunci când o cerință specifică depășește limita abstracției.
Primul experiment local sau instrument pentru dezvoltatori: Alegeți Ollama atunci când contează configurarea rapidă și doriți modele după nume. API-ul său gata făcut oferă instrumentului o interfață stabilă, fără munca de gestionare a ciclului de viață care nu ajută evaluarea sau integrarea. Alegeți llama.cpp în schimb dacă aveți nevoie de un backend nesuportat, de o versiune exactă de compilare sau de un parametru de nivel jos neexpus.
Inferență personalizată reproductibilă sau aplicație încorporată: Alegeți llama.cpp atunci când produsul trebuie să controleze exact artefactul și compilarea. De asemenea, controlează direct inițializarea și setările de rulare, ceea ce contează atunci când inferența se află în interiorul aplicației. Alegeți Ollama în schimb dacă un serviciu HTTP separat și controlul la nivelul Modelfile satisfac pe deplin nevoile produsului.
Hardware restricționat sau neobișnuit, sau reglare maximă: Începeți cu llama.cpp atunci când gama sa mai largă de backend-uri sau plasarea explicită rezolvă o cerință concretă. Verificați mai întâi că modelul încape. Alegeți Ollama atunci când acceptă bine hardware-ul, iar reglarea directă ar adăuga întreținere fără control util sau îmbunătățire măsurată.
Serviciu privat accesibil echipei: Ollama este de obicei punctul de plecare cu cel mai redus efort pentru ciclul de viață și servire, cu condiția ca operatorul să adauge o limită de rețea autentificată. Luați în considerare llama-server atunci când contează mai mult gestionarea nativă a cheilor API, controalele directe de servire sau reglarea backend-ului. Respingeți oricare opțiune dacă echipa nu poate îndeplini cerințele de funcționare permanentă de mai sus.
Folosiți ambele: Păstrați Ollama și llama.cpp independent ca puncte de intrare separate și domenii distincte de ciclu de viață. Aplicațiile pot selecta un endpoint testat pentru servirea de rutină sau pentru experimente controlate, dar nu pot presupune un comportament identic al API-ului. Fiecare runtime poate păstra propriul spațiu de stocare a modelelor, portul și procesul; dacă ambele încarcă modele, pot concura pentru RAM sau VRAM. Ollama nu folosește serviciul dumneavoastră separat llama.cpp.
Matricea de mai jos recapitulează aceste alegeri. Nu numărați rândurile ca puncte: o singură cerință strictă poate cântări mai mult decât toate comoditățile din restul tabelului.
| Domeniu de decizie | Ollama | llama.cpp |
|---|---|---|
| 🚀 Pornire cea mai rapidă | Cale integrată de instalare, model și serviciu | Rămân vizibile mai multe opțiuni de obținere, compilare și lansare |
| 🔄 Ciclu de viață al modelului | Descărcări după nume, stocare gestionată, Modelfile-uri, rezidență și programare | GGUF direct sau cache Hugging Face plus controale de router, preset și încărcare; mai puțin opinionat end-to-end |
| 🎛️ Reglare granulară | Valori implicite automatizate cu configurare selectată și controale API | Control direct mai larg asupra compilărilor, dispozitivelor, plasării, cache-urilor și loturilor |
| 🧩 Încorporare în proces | De obicei consumat ca serviciu separat | Biblioteca în stil C este potrivirea directă mai puternică |
| 🌐 Serviciu API | API nativ plus straturi de compatibilitate limitate | llama-server cu compatibilitate limitată și rute operaționale native |
| ⚙️ Flexibilitate backend | Suport curatoriat, împachetat | Matrice de backend-uri mai largă la compilare, cu rezerve privind compilarea și maturitatea |
| 🛠️ Responsabilitate operațională | Ciclu de viață integrat model/serviciu; autentificare externă necesară dincolo de utilizarea locală | Proprietate mai explicită asupra serverului și opțiuni native pentru chei și TLS; întărirea securității rămâne necesară |
| 🎯 Sarcina de lucru cu cea mai bună potrivire | Serviciu de model local sau privat repetabil, de zi cu zi | Inferență încorporată, experimentală, specifică hardware-ului sau reglată în profunzime |
Bottom Line
Cele două căi din introducere păreau contradictorii, deoarece atribuie proprietatea în mod diferit. Alegeți Ollama atunci când fluxul de lucru integrat este chiar funcționalitatea principală. Alegeți llama.cpp atunci când controlul direct asupra inferenței este funcționalitatea principală.
Dacă nu sunteți sigur, confirmați că modelul și cuantizarea se potrivesc cu hardware-ul. Verificați costul de memorie al contextului dorit, apoi începeți cu Ollama. Treceți la llama.cpp independent—sau adăugați-l—doar pentru o cerință concretă de nivel scăzut: un backend sau build specific, embedding în proces sau plasare și reglaj mai fin.