Bilhete aberto
 +373 79 600002
 Chat ao vivo do Telegram
 F.A.Q
 Português
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 em todos os serviços de alojamento


Ollama vs llama.cpp em 2026: Qual Runtime de LLM Local Você Deve Usar?
Você quer executar um LLM de pesos abertos em hardware que você controla: um laptop, uma estação de trabalho, um servidor doméstico ou um servidor remoto privado. Um guia aponta para o Ollama e para um modelo que você pode baixar pelo nome. Outro aponta para o llama.cpp, um arquivo de modelo e muito mais controles.
Então as afirmações entram em conflito. O Ollama é descrito como mais fácil e o llama.cpp como mais rápido; um é apresentado como mais prático, o outro como mais capaz. Essas afirmações frequentemente comparam modelos, configurações, hardware ou camadas diferentes da pilha de software.
A pergunta útil não é qual nome vence, mas quanto do fluxo de execução do modelo a ferramenta deve gerenciar e quanto a sua carga de trabalho precisa expor.
A resposta em 60 segundos
Escolha Ollama quando quiser um executor e serviço de modelos integrado. Configuração, obtenção de modelos nomeados e armazenamento compartilham um único fluxo de trabalho. Os padrões e as receitas de personalização cobrem a configuração rotineira, enquanto uma API local pronta oferece às aplicações uma interface estável. Esta costuma ser a opção padrão mais limpa para experimentos, ferramentas de programação e utilitários internos que não exigem administração de runtime em baixo nível.
Escolha llama.cpp quando precisar de controle direto da inferência. Você pode selecionar a build e o backend de hardware, fixar o artefato exato do modelo e gerenciar decisões de processo, memória e ajuste de desempenho. Também se adapta a softwares que precisam incorporar a inferência em vez de consumi-la a partir de um serviço separado.
Nenhuma das duas é uma vencedora universal: o Ollama pode lidar com a publicação rotineira, enquanto o llama.cpp independente atende a experimentos controlados. Antes de comparar desempenho, confirme a compatibilidade do modelo, da quantização, do contexto e do hardware. O restante desta comparação avalia fluxo de trabalho, hardware, integração e implantação, e não um benchmark inventado.
Ollama e llama.cpp estão em camadas diferentes
Inferência significa executar um modelo já treinado para produzir uma saída; um mecanismo de inferência realiza esse cálculo. llama.cpp é uma biblioteca e um conjunto de ferramentas portáteis em C/C++. Sua biblioteca principal fica ao lado de ferramentas de linha de comando e do llama-server, que inclui uma interface Web. Ele também oferece utilitários de conversão e quantização e a distribuição oficial llama, portanto o llama.cpp não é apenas CLI.
Ollama é um executor de modelos e um serviço que coloca um fluxo de trabalho opinativo em torno da inferência. Ele gerencia a aquisição e o armazenamento de modelos, aplica templates ou Modelfiles e agenda a inferência. O acesso à API e os backends selecionados pertencem ao mesmo serviço. Portanto, o Ollama não é apenas um invólucro gráfico; o ciclo de vida do modelo é central para o produto.
Um mapa de camadas simplificado
| Caminho | Modelo mental em camadas |
|---|---|
| Faixa do Ollama | Aplicação ou CLI → API do Ollama, ciclo de vida do modelo, templates e agendamento → componente de inferência incluído (caminho GGUF atual: llama-server fixado) → backend de hardware selecionado |
| Faixa do llama.cpp | Aplicação, CLI ou interface Web → biblioteca do llama.cpp ou llama-server → build/backend selecionado diretamente e controles de execução → hardware |
Modelo mental simplificado, não uma arquitetura completa. Descrição acessível: o Ollama adiciona gerenciamento de modelos e orquestração de serviço acima dos componentes de inferência incluídos, enquanto o llama.cpp expõe sua biblioteca e seu servidor mais próximos dos controles de hardware.
Conforme verificado em 5 de setembro de 2026, o caminho GGUF lançado pelo Ollama inicia um llama-server upstream incluído e fixado abaixo de sua camada de serviço. Como forma resumida, o llama.cpp fornece o motor e os controles de oficina, enquanto o Ollama empacota esses mecanismos em um veículo pronto para dirigir, com um painel mais simples. A analogia explica a abstração, não todos os componentes ou caminhos de modelo.
📝 Nota: Incluir um llama-server fixado não torna o Ollama idêntico ao llama.cpp upstream. O Ollama ainda fornece seus próprios padrões, templates, agendamento e API pública. Caminhos não GGUF ou experimentais também podem diferir.
Seis termos-chave que facilitam a comparação
Você não precisa de um glossário completo de engenharia de inferência. Estes seis termos cobrem as escolhas de modelo, memória e hardware que vêm a seguir.
| Termo | Significado em linguagem simples | Por que afeta esta escolha |
|---|---|---|
| 📦 GGUF | Um contêiner binário orientado à inferência para tensores e metadados de modelos, central para o ecossistema llama.cpp. O GGUF não especifica por si só um nível de quantização. | É o principal artefato portátil usado diretamente pelo llama.cpp e um caminho de importação suportado pelo Ollama. |
| 🗜️ Quantização | Representação dos tensores do modelo em menor precisão, geralmente reduzindo as necessidades de armazenamento e memória. Os efeitos na qualidade e na velocidade variam conforme o método, o modelo, o backend e a carga de trabalho. | A quantização escolhida pode determinar se um modelo cabe na memória e se tem bom desempenho, independentemente do runtime. |
| 📏 Tamanho do contexto | O orçamento ativo de tokens disponível para o modelo com instruções, entrada, histórico e saída. | Contextos ativos maiores consomem mais memória, portanto um máximo anunciado não é capacidade livre. |
| ⚙️ Backend | O caminho de computação específico do hardware, como CUDA, Metal, HIP/ROCm ou Vulkan. | O suporte do runtime e da compilação ao melhor backend da máquina pode determinar se a aceleração funciona bem. |
| 🚀 Offloading para GPU | Colocar camadas elegíveis do modelo ou parte da computação em uma GPU, em vez de manter todo o trabalho na CPU. | A quantidade e a posição do offloading podem alterar o uso de memória e a velocidade mais do que o wrapper do serviço. |
| 🗃️ Cache KV | Estado de atenção armazenado que permite ao modelo reutilizar contextos anteriores durante a geração. Seu tamanho cresce com o contexto ativo e o número de sequências. | Contextos longos e usuários simultâneos podem consumir RAM ou VRAM substancial além do próprio arquivo do modelo. |
A especificação GGUF descreve o artefato; a quantização altera como seus tensores são representados. O contexto e o cache KV definem sua pegada de memória, enquanto o backend e o offloading determinam onde a computação é executada.
Defina os critérios antes de comparar
Ambos os projetos podem executar modelos de pesos abertos em hardware controlado pelo usuário e expor a inferência por meio de uma API. Essas capacidades compartilhadas não decidem a comparação. Use as mesmas oito perguntas ao longo de todo o processo:
- Quanta complexidade de configuração você pode aceitar até a primeira solicitação útil?
- O serviço deve gerenciar o ciclo de vida do modelo, ou você deve controlar os arquivos exatos e as opções de inicialização?
- Quanto controle de baixo nível a carga de trabalho realmente exige?
- Qual opção tem o melhor encaixe de hardware e backend para esta máquina?
- A aplicação precisa de um serviço HTTP ou de uma integração em processo mais estreita?
- Que segurança operacional deve envolver o endpoint?
- Quem cuidará da manutenção, das atualizações e da repetibilidade?
- A inferência será executada no dispositivo, em um servidor privado remoto ou em uma nuvem de fornecedor?
Comparações de desempenho exigem o artefato exato do modelo — o arquivo convertido e os metadados que estão sendo executados — e não apenas o mesmo nome de família. Corresponda o template renderizado e o contexto ativo e, em seguida, alinhe o backend, o comportamento de descarregamento (offload) e o hardware. Use a mesma versão de software, as mesmas condições de agrupamento (batching) e de concorrência. Com essa matriz de critérios definida, comece pela diferença mais visível: o fluxo de trabalho diário.
Flujo de trabajo diario: comodidad gestionada frente a control explícito
La configuración inicial muestra la diferencia:
- Ollama ofrece instalaciones empaquetadas para macOS, Windows y Linux, que llevan a un flujo de trabajo basado en servicio con menos decisiones iniciales
- La distribución oficial de llama, los gestores de paquetes y las versiones precompiladas ofrecen rutas accesibles para llama.cpp
- Los contenedores y las compilaciones desde el código fuente añaden control cuando las opciones empaquetadas no se ajustan a las necesidades
Ya no se trata de “instalador sencillo frente a compilar todo”, pero llama.cpp sigue exponiendo más decisiones de obtención, compilación y lanzamiento.
Una vez instalado, la gestión de modelos hace que la diferencia sea concreta. La biblioteca con nombre de Ollama y el comportamiento de descargar al ejecutar simplifican la obtención, mientras que el almacenamiento gestionado, los comandos de ciclo de vida y los valores predeterminados se encargan de las tareas de mantenimiento repetitivas. llama.cpp parte de un artefacto GGUF específico, aunque las herramientas actuales pueden descargar y almacenar en caché modelos compatibles de Hugging Face con -hf; su servidor/router también puede descubrir modelos y gestionar la carga. La ventaja de Ollama no es simplemente tener funciones de gestión de modelos, sino integrarlas en una sola rutina.
Para la personalización, un Modelfile es la receta declarativa de Ollama. Identifica el modelo base y los parámetros, define el comportamiento del prompt o del sistema y adjunta adaptadores. Con llama.cpp, la repetibilidad comienza con un GGUF exacto y una compilación concreta; el backend y la configuración de lanzamiento fijan más aspectos del mecanismo subyacente.
Ollama no se limita a su biblioteca de modelos. Su flujo de importación acepta archivos GGUF compatibles y modelos o adaptadores en Safetensors, sujetos a límites de arquitectura y conversión. GGUF sigue siendo el formato portable central de llama.cpp, pero las herramientas oficiales también gestionan la obtención y el almacenamiento en caché.
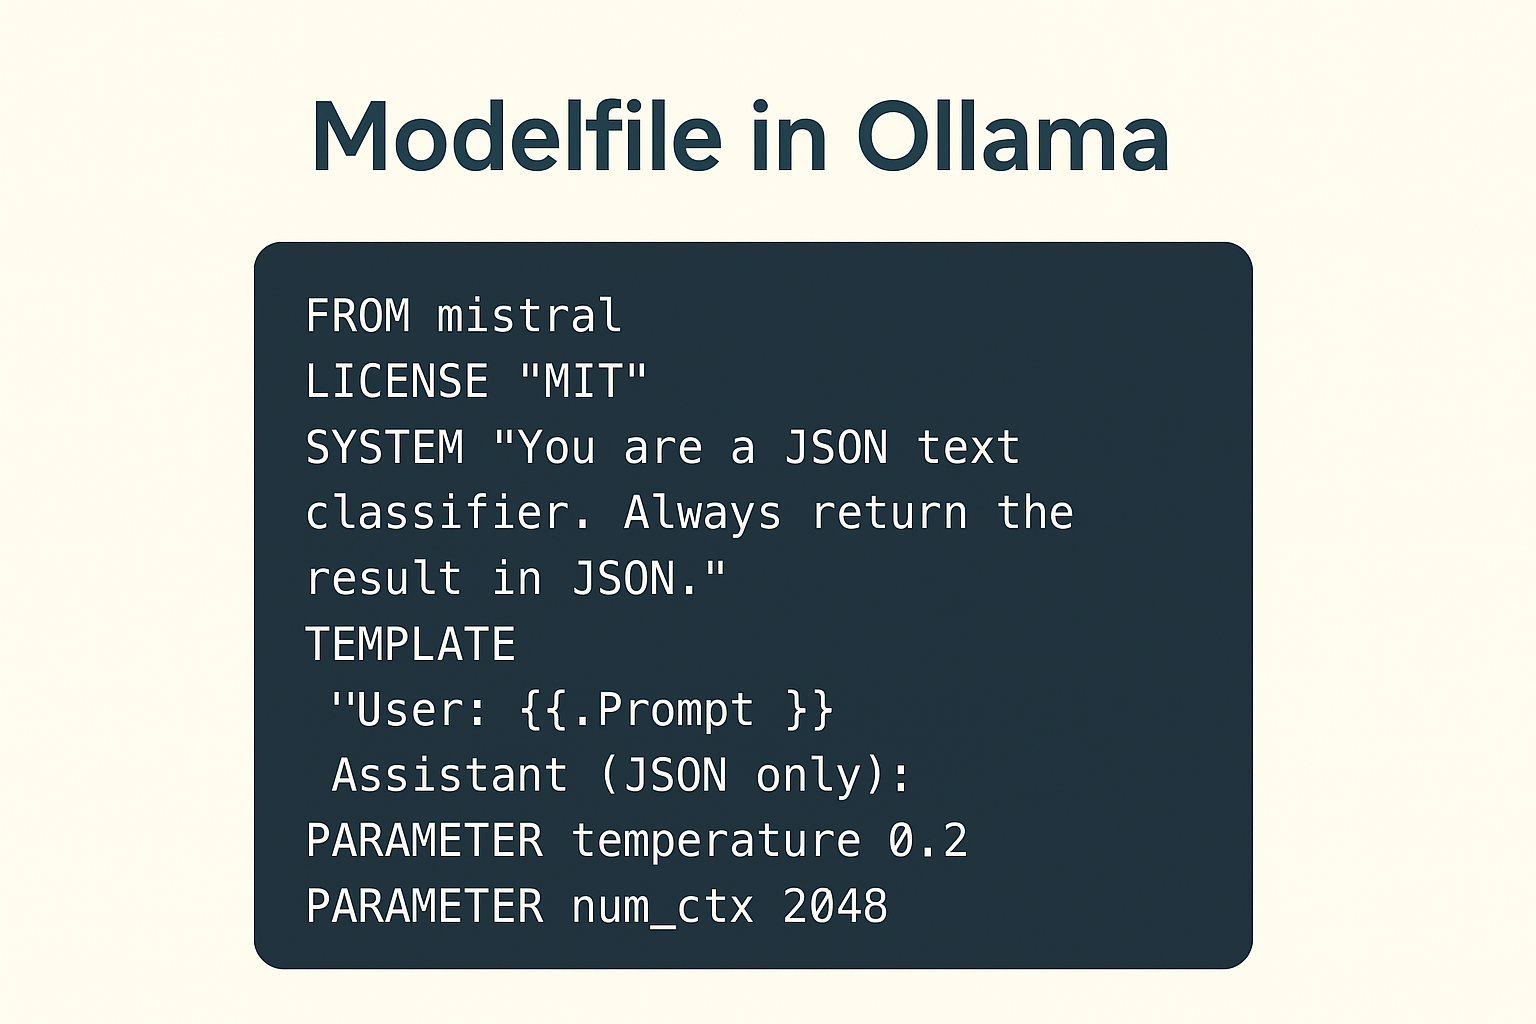
Las actualizaciones y la repetibilidad adoptan formas distintas. Ollama puede reproducir una configuración cotidiana mediante un modelo con nombre, un Modelfile y valores predeterminados gestionados, aunque las revisiones internas pueden cambiar con una actualización. llama.cpp permite a los operadores fijar la compilación, el artefacto y la configuración, pero deben mantener esos detalles por su cuenta. La compensación es entre la carga administrativa y la visibilidad: los valores predeterminados reducen las decisiones recurrentes, mientras que la configuración explícita facilita inspeccionar comportamientos especializados.
Desempenho, Memória e Hardware: Por Que Não Há Um Vencedor Universal
Um runtime pode carregar rapidamente e, ainda assim, gerar lentamente, ou processar um prompt longo de forma eficiente e ter dificuldades com geração concorrente. Carregamento a frio, processamento do prompt e geração de tokens são fases separadas. Um único rótulo de “mais rápido” oculta a fase medida e se ela se assemelha à carga de trabalho real.
Até o prompt precisa corresponder por trás do texto visível. Dois serviços podem receber a mesma mensagem, mas renderizar templates de chat, marcadores de função ou tokens especiais diferentes. Isso altera os tokens de entrada e o trabalho realizado antes da geração. O comportamento de amostragem e o tamanho da saída acrescentam mais diferenças.
O tamanho de um arquivo GGUF não é o seu requisito máximo de memória. Os tensores do modelo formam a base, enquanto o cache KV adiciona memória para o contexto e as sequências ativas. Buffers de computação, adaptadores e projetores multimodais adicionam sobrecarga. Um modelo de rascunho ou outros modelos residentes consomem mais capacidade, e o sistema operacional precisa de margem. Contextos maiores e mais sequências simultâneas podem, portanto, aumentar substancialmente o uso de memória. Se o modelo não couber, resolva o dimensionamento antes de comparar runtimes.
O llama.cpp expõe diretamente a alocação de threads, os tamanhos de contexto e de lote, e os tipos de cache KV. A colocação em dispositivos e camadas na GPU, a divisão entre múltiplas GPUs e os caminhos especulativos também permanecem como escolhas do operador. O Ollama automatiza mais, mas ainda expõe o contexto ativo, requisições paralelas, a residência dos modelos e o agendamento na GPU. Flash Attention e controles de cache KV continuam disponíveis por meio de configuração, Modelfiles ou opções da API. Esses controles são úteis somente quando você tem um motivo para ajustá-los.
O suporte de hardware também resiste a uma pontuação simples. O Ollama empacota os caminhos de CPU e GPU mais comuns, com Metal, CUDA, ROCm e Vulkan como exemplos. A matriz de build mais ampla do llama.cpp alcança alvos convencionais e incomuns. Um backend documentado pode não estar maduro ou não estar incluído em todos os binários pré-compilados. O desempenho depende do build, do driver, do dispositivo e de quão bem o modelo utiliza os kernels relevantes.
⚠️ Aviso: Um nome de modelo compartilhado ou uma única captura de tela de tokens por segundo não é uma comparação controlada. Artefatos ou templates diferentes alteram o trabalho medido; contexto, padrões e estado de aquecimento alteram as condições do teste.
Para uma verificação justa de desempenho entre Ollama e llama.cpp:
- Use exatamente o mesmo artefato ou checksum do modelo, a mesma quantização, adaptador e projetor multimodal, quando aplicável.
- Faça corresponder o template de chat e os tokens do prompt renderizado, o tamanho de saída solicitado e o comportamento de amostragem.
- Faça corresponder o contexto, a representação do cache KV, as configurações de lote e microlote, os slots paralelos e as condições de fila ou concorrência.
- Faça corresponder a versão e o build do software, o backend, os drivers, a seleção de dispositivo e o comportamento de offload ou divisão na GPU.
- Reporte separadamente o carregamento a frio, o processamento de prompt em estado aquecido e a geração de tokens.
- Repita o teste sob a concorrência e o formato de requisição que a aplicação real usará.
Múltiplas GPUs ou quantizações de menor bit não garantem inferência mais rápida. Interconexões e a movimentação de memória podem limitar configurações com múltiplas GPUs, enquanto os kernels e o formato das requisições podem alterar o resultado. Escolha uma configuração que caiba com margem e, em seguida, meça a fase e o padrão que sua aplicação utilizará.
APIs e integração: primeiro o serviço ou primeiro o kit de ferramentas?
O Ollama foi projetado principalmente como um serviço de modelo de execução contínua. Ele oferece uma API nativa — a sua própria superfície de requisição e resposta — além de clientes oficiais em Python e JavaScript. Isso atende a um plugin ou ferramenta interna que precisa de um endpoint HTTP local e estável. O Ollama obtém e carrega o modelo, deixando a aplicação enviar as requisições.
O Ollama documenta algumas rotas compatíveis com OpenAI e com Anthropic. O llama-server atual documenta ambos os estilos junto com endpoints operacionais nativos. Essas camadas permitem que clientes existentes usem um formato de API familiar com um runtime diferente.
Uma troca de URL base no estilo OpenAI, após testada, pode economizar trabalho de integração; isso não garante o suporte a todos os recursos. Saída estruturada e uso de ferramentas dependem da rota, do modelo e do template de prompt. Embeddings ou entrada multimodal também podem depender da build e do cliente. Teste essas capacidades como parte da aplicação, e não como itens marcados no runtime.
📝 Nota: “Compatível” significa rotas e campos selecionados. Teste primeiro o endpoint exato e os campos da requisição. Em seguida, verifique o comportamento do streaming e os formatos de chamada de ferramentas, seguidos de qualquer tratamento de imagens, contagens de tokens, campos de resposta e erros que sua aplicação utilize.
O llama-server é uma opção de servimento séria, e não um wrapper de demonstração. Sua Web UI oferece uma interface no navegador, enquanto a decodificação paralela e o batching contínuo dão suporte ao servimento compartilhado. O roteamento e o carregamento de modelos adicionam controle de ciclo de vida no nível do servidor; as rotas de compatibilidade e os endpoints operacionais nativos completam a interface. Ele pode ser a melhor camada HTTP quando controles diretos importam mais do que o ciclo de vida gerenciado do Ollama.
Quando HTTP não é suficiente, a biblioteca em estilo C do llama.cpp pode incorporar a inferência no seu processo. A aplicação controla a inicialização e o encerramento, enquanto as configurações de baixo nível permanecem próximas ao seu código. O Ollama normalmente é um serviço separado. Escolha o llama.cpp quando a inferência precisar ser distribuída dentro da aplicação; escolha o Ollama quando um endpoint separado for preferível.
De um Laptop a um Servidor Privado Sempre Ativo
Existem três limites de execução.
- Inferência no próprio dispositivo é executada no laptop ou estação de trabalho que faz a solicitação.
- Auto-hospedagem privada remota é executada em um servidor controlado pela organização; pode preservar o controle operacional, mas as solicitações atravessam uma rede e a execução não é local ao dispositivo.
- Inferência em nuvem hospedada pelo fornecedor é executada na infraestrutura do provedor.
Essa distinção é importante porque os modelos com tag de nuvem do Ollama são executados na nuvem dele, mesmo quando um cliente localhost envia a solicitação. “Usar o Ollama” não comprova execução local. Implantações estritamente locais devem excluir ou desativar funcionalidades de nuvem, de acordo com a documentação atual.
Ambos os projetos usam por padrão exposição de rede somente local. O Ollama faz bind localmente, e sua API não possui autenticação integrada. O llama-server também usa loopback por padrão—acessível apenas a partir do mesmo host—e oferece opções de chave de API e TLS. Nenhum dos padrões constitui um limite completo para implantação pública.
⚠️ Aviso: A API local do Ollama não possui autenticação integrada, e chaves de espaço reservado aceitas por exemplos de compatibilidade não a protegem. Nunca exponha diretamente o endpoint padrão à internet pública.
Antes de tornar qualquer um dos endpoints acessível remotamente, use estes controles como barreira mínima:
- Um endereço de bind definido deliberadamente e um limite de rede privada ou VPN.
- Autenticação no servidor ou em um gateway autenticado.
- TLS para o transporte de rede.
- Limites de firewall, CORS, tamanho de solicitação, concorrência e recursos.
- Supervisão de processos, atualizações controladas, verificações de integridade e monitoramento.
- Registro de logs, retenção e tratamento de dados com atenção à privacidade, evitando vazamento de prompts, respostas ou credenciais.
Dimensione o modelo e a quantização antes de considerar capacidade de GPU alugada. Considere o contexto ativo e a concorrência para estimar a VRAM e a margem operacional. Se um laptop não atender à meta de desempenho ou disponibilidade, infraestrutura de GPU alugada com capacidade para LLM—com a AlexHost como um exemplo—torna-se uma opção, não um atalho que dispensa o dimensionamento.
Declarações de privacidade de fornecedores não são auditorias independentes. Documente onde a inferência é executada e por quais redes as solicitações passam. Registre quem administra os sistemas e o que o armazenamento ou os logs retêm. Esse registro define o limite de privacidade com mais clareza do que a marca do runtime.
Quale dovresti scegliere? Raccomandazioni per caso d’uso
Queste raccomandazioni descrivono l’adeguatezza al carico di lavoro, non il livello di competenza. La comodità può essere un requisito ingegneristico; il controllo diretto può essere un sovraccarico non necessario. La scelta cambia quando un requisito specifico supera il confine dell’astrazione.
Primo esperimento locale o strumento per sviluppatori: Scegli Ollama quando la configurazione rapida è importante e vuoi i modelli per nome. La sua API pronta offre allo strumento un’interfaccia stabile senza lavoro di gestione del ciclo di vita che non aiuti la valutazione o l’integrazione. Scegli invece llama.cpp se hai bisogno di un backend non supportato, di una build esatta o di un’impostazione di basso livello non esposta.
Inferenza personalizzata riproducibile o applicazione embedded: Scegli llama.cpp quando il prodotto deve possedere l’artefatto e la build esatti. Controlla anche direttamente l’inizializzazione e le impostazioni di runtime, il che è importante quando l’inferenza risiede all’interno dell’applicazione. Scegli invece Ollama se un servizio HTTP separato e il controllo a livello di Modelfile soddisfano pienamente le esigenze del prodotto.
Hardware limitato o insolito, oppure ottimizzazione massima: Inizia con llama.cpp quando la sua matrice di backend più ampia o il posizionamento esplicito risolve un requisito specifico. Verifica prima che il modello stia nella memoria. Scegli Ollama quando supporta bene l’hardware e la messa a punto diretta aggiungerebbe manutenzione senza un controllo utile o un miglioramento misurato.
Servizio privato accessibile al team: Ollama è di solito il punto di partenza con minore attrito per ciclo di vita e servizio, purché l’operatore aggiunga un confine di rete autenticato. Considera llama-server quando contano di più la gestione nativa delle chiavi API, i controlli diretti del servizio o l’ottimizzazione del backend. Scarta entrambe le opzioni se il team non può soddisfare i requisiti di funzionamento continuo indicati sopra.
Usa entrambi: Mantieni Ollama e llama.cpp autonomo come punti di ingresso e domini di ciclo di vita separati. Le applicazioni possono selezionare un endpoint testato per il servizio di routine o per esperimenti controllati, ma non possono presumere un comportamento identico dell’API. Ciascun runtime può mantenere il proprio archivio dei modelli, la propria porta e il proprio processo; se entrambi caricano modelli, possono competere per RAM o VRAM. Ollama non utilizza il tuo servizio llama.cpp separato.
La matrice seguente riepiloga queste scelte. Non contare le righe come punti: un unico requisito vincolante può prevalere su tutte le comodità altrove.
| Area decisionale | Ollama | llama.cpp |
|---|---|---|
| 🚀 Avvio più rapido | Percorso integrato di installazione, modello e servizio | Restano visibili più scelte di acquisizione, build e avvio |
| 🔄 Ciclo di vita del modello | Pull per nome, archiviazione gestita, Modelfile, residenza e pianificazione | GGUF diretto o cache di Hugging Face più controlli di router, preset e caricamento; meno vincolato end-to-end |
| 🎛️ Ottimizzazione granulare | Valori predefiniti automatizzati con configurazione selezionata e controlli API | Controllo diretto più ampio su build, dispositivi, posizionamento, cache e batch |
| 🧩 Embedding in-process | Normalmente utilizzato come servizio separato | La libreria in stile C è l’adattamento diretto più solido |
| 🌐 Servizio API | API nativa più livelli di compatibilità limitati | llama-server con compatibilità limitata e route operative native |
| ⚙️ Flessibilità del backend | Supporto confezionato e curato | Matrice di backend in fase di build più ampia, con avvertenze su build e maturità |
| 🛠️ Responsabilità operativa | Ciclo di vita integrato di modello/servizio; autenticazione esterna richiesta oltre l’uso locale | Proprietà del server più esplicita e opzioni native di chiavi/TLS; è comunque richiesto un hardening |
| 🎯 Carico di lavoro più adatto | Servizio di modelli locale o privato quotidiano e ripetibile | Inferenza embedded, sperimentale, specifica per hardware o fortemente ottimizzata |
Bottom Line
Os dois caminhos apresentados no início pareciam contraditórios porque atribuem a propriedade de forma diferente. Escolha o Ollama quando o fluxo de trabalho integrado for o próprio recurso. Escolha o llama.cpp quando o controle direto sobre a inferência for o recurso.
Se tiver dúvidas, confirme que o modelo e a quantização são compatíveis com o hardware. Verifique o custo de memória do contexto pretendido e, em seguida, comece com o Ollama. Mude para — ou adicione — o llama.cpp independente apenas para um requisito concreto de baixo nível: um backend ou build específico, embedding em processo ou ajuste e posicionamento mais refinados.