Открыть тикет
 +373 79 600002
 Телеграм-чат в реальном времени
 Часто задаваемые вопросы
 Русский
 English
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)









 на всех хостинговых услугах


Ollama vs llama.cpp в 2026: какую среду выполнения локальных LLM выбрать?
Вам нужно запускать open-weight LLM на оборудовании, которым вы управляете: ноутбуке, рабочей станции, домашнем сервере или приватном удаленном сервере. Одно руководство указывает на Ollama и модель, которую можно загрузить по имени. Другое указывает на llama.cpp, файл модели и гораздо больше параметров управления.
Затем утверждения начинают противоречить друг другу. Ollama называют более простым, а llama.cpp — более быстрым; один инструмент описывают как более практичный, другой — как более мощный. Эти утверждения часто сравнивают разные модели, настройки, оборудование или уровни программного стека.
Полезный вопрос не в том, какое название побеждает, а в том, сколько рабочего процесса запуска модели должен брать на себя инструмент и сколько из него ваша задача требует раскрывать.
Ответ за 60 секунд
Выбирайте Ollama, когда нужен интегрированный сервис для запуска моделей. Установка, получение моделей по имени и хранение работают в едином процессе. Значения по умолчанию и готовые рецепты настройки покрывают типовые задачи, а готовый локальный API даёт приложениям стабильный интерфейс. Это обычно более удобный выбор по умолчанию для экспериментов, инструментов для программистов и внутренних утилит, которым не нужно низкоуровневое администрирование среды выполнения.
Выбирайте llama.cpp, когда нужен прямой контроль над инференсом. Вы можете выбрать сборку и аппаратный бэкенд, зафиксировать точный файл модели и управлять процессом, памятью и настройками производительности. Также это подходит для программ, которым нужно встроить инференс, а не обращаться к отдельному сервису.
Ни один из вариантов не является универсальным победителем: Ollama справляется с обычной обработкой запросов, а самостоятельный llama.cpp подходит для контролируемых экспериментов. Прежде чем сравнивать производительность, проверьте соответствие модели, квантования, размера контекста и аппаратного обеспечения. Остальная часть сравнения оценивает рабочий процесс, аппаратное обеспечение, интеграцию и развёртывание, а не выдуманный бенчмарк.
Ollama и llama.cpp работают на разных уровнях
Инференс означает запуск уже обученной модели для получения результата; движок инференса выполняет это вычисление. llama.cpp — это переносимая библиотека и набор инструментов на C/C++. Её основная библиотека работает вместе с инструментами командной строки и llama-server, который включает веб-интерфейс. Также предоставляются утилиты для конвертации и квантизации, а также официальный дистрибутив llama, поэтому llama.cpp не ограничивается только CLI.
Ollama — это средство запуска моделей и сервис, который организует инференс в определённый рабочий процесс. Он управляет получением и хранением моделей, применяет шаблоны или Modelfile и планирует выполнение инференса. Доступ к API и выбранным бэкендам относятся к одному и тому же сервису. Поэтому Ollama — не просто графическая оболочка; жизненный цикл модели является ключевой частью продукта.
Упрощённая схема уровней
| Путь | Упрощённая модель уровней |
|---|---|
| Путь Ollama | Приложение или CLI → API Ollama, жизненный цикл моделей, шаблоны и планирование → встроенный компонент инференса (текущий путь GGUF: закреплённый llama-server) → выбранный аппаратный бэкенд |
| Путь llama.cpp | Приложение, CLI или веб-интерфейс → библиотека llama.cpp или llama-server → непосредственно выбранная сборка/бэкенд и параметры работы → аппаратное обеспечение |
Упрощённая модель — не полная архитектура. Доступное описание: Ollama добавляет управление моделями и оркестрацию сервисов над встроенными компонентами инференса, тогда как llama.cpp предоставляет свою библиотеку и сервер ближе к аппаратным средствам.
По состоянию на 5 сентября 2026 года выпущенный путь GGUF в Ollama запускает встроенный, закреплённый вышестоящий llama-server под своим сервисным уровнем. Упрощённо можно сказать, что llama.cpp предоставляет движок и инструменты для тонкой настройки, а Ollama упаковывает эти механизмы в готовый к управлению автомобиль с более простой панелью. Аналогия объясняет абстракцию, но не каждый компонент или путь к моделям.
📝 Примечание: Встроенный закреплённый llama-server не делает Ollama идентичной оригинальной версии llama.cpp. Ollama по-прежнему предоставляет собственные значения по умолчанию, шаблоны, планирование и публичный API. Пути для не-GGUF моделей или экспериментальные пути также могут отличаться.
Шесть ключевых терминов, которые упрощают сравнение
Полный глоссарий по инженерии инференса вам не нужен. Эти шесть терминов охватывают выбор модели, памяти и оборудования, который предстоит сделать.
| Термин | Значение простыми словами | Почему это влияет на выбор |
|---|---|---|
| 📦 GGUF | Бинарный контейнер для тензоров модели и метаданных, ориентированный на инференс, являющийся центральным элементом экосистемы llama.cpp. Сам по себе GGUF не определяет уровень квантизации. | Это основной переносимый артефакт, который напрямую используется llama.cpp, а также поддерживаемый путь импорта для Ollama. |
| 🗜️ Квантизация | Представление тензоров модели с более низкой точностью, что, как правило, снижает требования к хранилищу и памяти. Влияние на качество и скорость зависит от метода, модели, бэкенда и нагрузки. | Выбранная квантизация может определить, поместится ли модель и будет ли она работать хорошо, независимо от среды выполнения. |
| 📏 Длина контекста | Активный бюджет токенов, доступный модели для инструкций, входных данных, истории и вывода. | Большие активные контексты потребляют больше памяти, поэтому заявленный максимум не означает бесплатную ёмкость. |
| ⚙️ Бэкенд | Аппаратно-зависимый путь вычислений, например CUDA, Metal, HIP/ROCm или Vulkan. | Поддержка бэкенда в среде выполнения и сборке для лучшего бэкенда машины может определить, насколько хорошо работает ускорение. |
| 🚀 Выгрузка на GPU | Размещение подходящих слоёв модели или вычислений на GPU вместо того, чтобы выполнять всю работу на CPU. | Объём и распределение выгрузки могут повлиять на использование памяти и скорость сильнее, чем служебная обёртка. |
| 🗃️ KV-кэш | Сохранённое состояние внимания, которое позволяет модели повторно использовать предыдущий контекст во время генерации. Его объём растёт с активным контекстом и количеством последовательностей. | Длинные контексты и параллельные пользователи могут потреблять значительный объём ОЗУ или VRAM помимо самого файла модели. |
В спецификации GGUF описан артефакт; квантизация меняет способ представления его тензоров. Контекст и KV-кэш определяют объём памяти, а бэкенд и выгрузка определяют, где выполняются вычисления.
Установите критерии до сравнения
Оба проекта могут запускать открытые весовые модели на оборудовании, которым управляет пользователь, и предоставлять инференс через API. Эти общие возможности не решают исход сравнения. Используйте одни и те же восемь вопросов на протяжении всего анализа:
- Какой порог сложности настройки вы готовы принять до первого полезного запроса?
- Должен ли сервис управлять жизненным циклом модели, или вы хотите сами контролировать точные файлы и параметры запуска?
- Какой уровень низкоуровневого контроля действительно требуется для вашей нагрузки?
- Какой вариант обеспечивает правильное соответствие оборудования и бэкенда для этой машины?
- Нужен ли приложению HTTP-сервис или более тесная интеграция в процесс?
- Какая операционная безопасность должна окружать конечную точку?
- Кто будет заниматься обслуживанием, обновлениями и воспроизводимостью?
- Будет ли инференс выполняться на устройстве, на удалённом приватном сервере или в облаке вендора?
Сравнение производительности требует точного артефакта модели — конвертированного файла и метаданных, которые запускаются, а не просто одинакового названия семейства. Сопоставьте отрисованный шаблон и активный контекст, затем приведите в соответствие бэкенд, поведение выгрузки и оборудование. Используйте одну и ту же версию программного обеспечения, пакетную обработку и условия параллелизма. Зафиксировав эту систему критериев, начнём с наиболее заметного различия: повседневного рабочего процесса.
Повседневный рабочий процесс: управляемое удобство против явного контроля
Первоначальная настройка показывает различие:
- Ollama предоставляет готовые установщики для macOS, Windows и Linux, переходя затем к сервисному рабочему процессу с меньшим количеством ранних решений
- Официальный дистрибутив llama, менеджеры пакетов и готовые релизы обеспечивают доступные пути к llama.cpp
- Контейнеры и сборка из исходного кода добавляют контроль, когда готовые варианты не подходят
Это уже не «дружелюбный установщик против сборки всего с нуля», но llama.cpp по-прежнему предоставляет больше решений на этапах получения, сборки и запуска.
После установки разница в работе с моделями становится конкретной. Именованная библиотека Ollama и поведение «загрузка при запуске» упрощают получение моделей, а управляемое хранилище, команды жизненного цикла и настройки по умолчанию берут на себя повторяющуюся рутину. llama.cpp начинает с конкретного артефакта GGUF, хотя современные инструменты могут загружать и кэшировать совместимые модели Hugging Face с помощью -hf; его сервер/маршрутизатор также может обнаруживать модели и управлять их загрузкой. Преимущество Ollama заключается не просто в наличии функций управления моделями, а в объединении их в единый процесс.
Для настройки Modelfile является декларативным рецептом Ollama. Он определяет базовую модель и параметры, задает поведение промпта или системных инструкций и подключает адаптеры. В llama.cpp воспроизводимость начинается с точного GGUF и сборки; бэкенд и конфигурация запуска закрепляют больше деталей базового механизма.
Ollama не ограничивается своей библиотекой моделей. Её процесс импорта принимает поддерживаемые файлы GGUF и модели или адаптеры Safetensors с учетом ограничений по архитектуре и конвертации. GGUF остается центральным переносимым форматом llama.cpp, но официальные инструменты также берут на себя получение и кэширование.
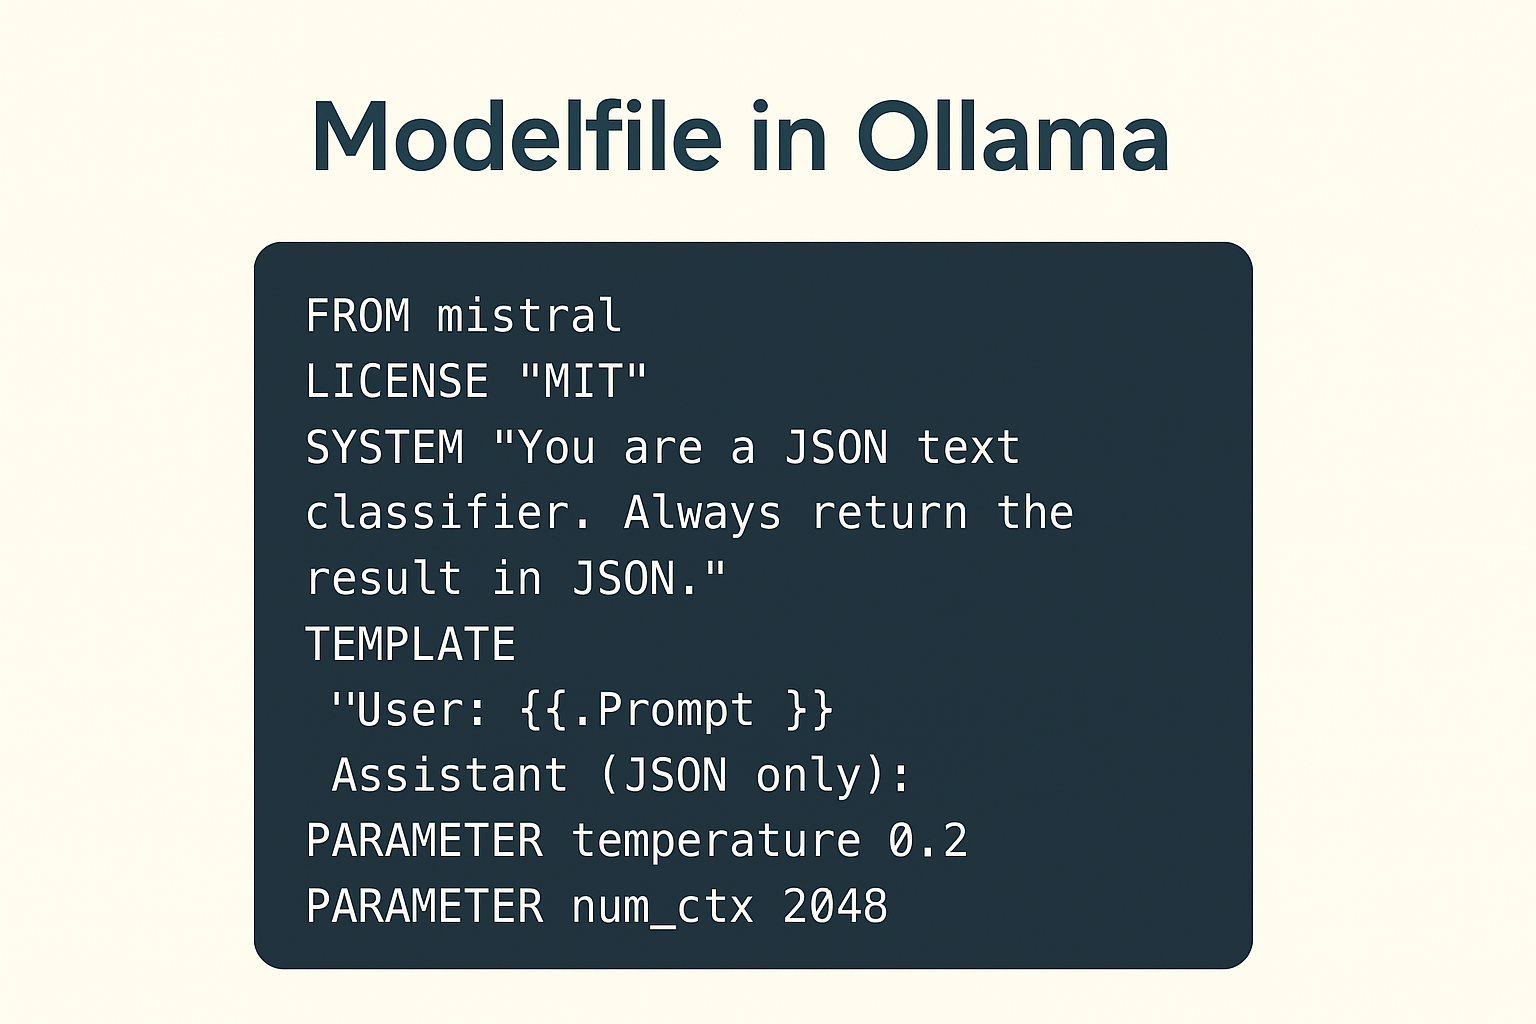
Обновления и воспроизводимость проявляются по-разному. Ollama может воспроизвести повседневную конфигурацию через именованную модель, Modelfile и управляемые настройки по умолчанию, хотя внутренние ревизии могут измениться при обновлении. llama.cpp позволяет фиксировать сборку, артефакт и параметры, но поддерживать эти детали должен оператор. Компромисс заключается в административной нагрузке против прозрачности: настройки по умолчанию снижают количество повторяющихся решений, а явные параметры упрощают проверку специализированного поведения.
Производительность, память и оборудование: почему нет универсального победителя
Среда выполнения может быстро загружаться, но медленно генерировать, или эффективно обрабатывать длинный промпт, но испытывать трудности с параллельной генерацией. Холодная загрузка, обработка промпта и генерация токенов — это отдельные фазы. Единая метка «быстрее» скрывает измеряемую фазу и то, соответствует ли она реальной нагрузке.
Даже промпт должен совпадать за пределами видимого текста. Два сервиса могут получить одно и то же сообщение, но применять разные шаблоны чата, маркеры ролей или специальные токены. Это меняет входные токены и объём работы до генерации. Поведение сэмплирования и длина вывода добавляют дополнительные различия.
Размер файла GGUF не равен его пиковым требованиям к памяти. Тензоры модели составляют базовый объём, а KV-кэш добавляет память для активного контекста и последовательностей. Буферы вычислений, адаптеры и мультимодальные проекторы добавляют накладные расходы. Черновая модель или другие постоянно загруженные модели занимают дополнительную ёмкость, а операционной системе нужен запас. Поэтому более длинные контексты и большее число параллельных последовательностей могут существенно увеличить использование памяти. Если модель не помещается, сначала решите задачу подбора ресурсов, и только потом сравнивайте среды выполнения.
llama.cpp напрямую предоставляет управление размещением потоков, размерами контекста и батча, а также типами KV-кэша. Размещение на устройствах и слоях GPU, разделение между несколькими GPU и спекулятивные пути также остаются решениями оператора. Ollama автоматизирует больше, но всё равно раскрывает активный контекст, параллельные запросы, постоянство модели в памяти и планирование GPU. Flash Attention и параметры KV-кэша остаются доступными через конфигурацию, Modelfile или опции API. Эти настройки полезны только тогда, когда есть причина их менять.
Поддержка оборудования также плохо поддаётся простой оценке. Ollama включает основные пути CPU и GPU, например Metal, CUDA, ROCm и Vulkan. Более широкая матрица сборок llama.cpp охватывает как основные, так и необычные платформы. Задокументированный бэкенд может быть не зрелым или не входить в каждый готовый бинарный файл. Производительность зависит от сборки, драйвера, устройства и того, насколько хорошо модель использует соответствующие ядра.
⚠️ Предупреждение: Совпадение названия модели или один скриншот с количеством токенов в секунду — это не контролируемое сравнение. Разные артефакты или шаблоны меняют объём измеряемой работы; контекст, настройки по умолчанию и состояние прогрева меняют условия теста.
Для честной проверки производительности Ollama и llama.cpp:
- Используйте один и тот же артефакт модели или контрольную сумму, квантование, адаптер и мультимодальный проектор, где это применимо.
- Сопоставьте шаблон чата и отрендеренные токены промпта, запрошенную длину вывода и поведение сэмплирования.
- Сопоставьте контекст, представление KV-кэша, настройки батча и микробатча, параллельные слоты, а также условия очереди или конкурентности.
- Сопоставьте версию ПО и сборку, бэкенд, драйверы, выбор устройства и поведение выгрузки на GPU или разделения.
- Отдельно сообщайте холодную загрузку, обработку прогретого промпта и генерацию токенов.
- Повторяйте тест при конкурентности и форме запросов, которые будет использовать реальное приложение.
Несколько GPU или более низкая битность квантования не гарантируют более быстрый инференс. Межсоединения и перемещение данных в памяти могут ограничивать конфигурации с несколькими GPU, а ядра и форма запросов могут изменить результат. Выбирайте конфигурацию, которая помещается с запасом, а затем измеряйте ту фазу и тот паттерн, которые будет использовать ваше приложение.
API и интеграция: сначала сервис или сначала инструментарий?
Ollama изначально задумана как долгоживущий сервис для моделей. Она предоставляет собственный API — свой набор запросов и ответов — а также официальные клиенты для Python и JavaScript. Это подходит для плагина или внутреннего инструмента, которому нужна стабильная локальная HTTP-конечная точка. Ollama загружает модель и управляет ею, а приложение просто отправляет запросы.
Ollama документирует отдельные маршруты, совместимые с OpenAI и Anthropic. Текущая версия llama-server документирует оба стиля наряду с собственными эндпоинтами для эксплуатации. Эти уровни позволяют существующим клиентам использовать знакомую структуру API с другой средой выполнения.
Успешно протестированная смена базового URL в стиле OpenAI может сэкономить время на интеграцию, но это не гарантирует поддержку всех функций. Структурированный вывод и использование инструментов зависят от маршрута, модели и шаблона промпта. Эмбеддинги или мультимодальный ввод также могут зависеть от сборки и клиента. Проверяйте эти возможности в рамках самого приложения, а не как отметки в списке возможностей среды выполнения.
📝 Примечание: «Совместимость» означает совместимость отдельных маршрутов и полей. Сначала проверьте точную конечную точку и поля запроса. Затем проверьте поведение потоковой передачи и форматы вызовов инструментов, а также обработку изображений, подсчёт токенов, поля ответа и ошибки, которые использует ваше приложение.
llama-server — серьёзный вариант для развёртывания, а не демонстрационная обёртка. Его веб-интерфейс предоставляет браузерную среду, а параллельное декодирование и непрерывная пакетная обработка поддерживают совместное обслуживание запросов. Маршрутизация и загрузка моделей добавляют управление жизненным циклом на уровне сервера; совместимые маршруты и собственные эксплуатационные эндпоинты дополняют интерфейс. Он может быть лучшим HTTP-уровнем, когда важнее прямой контроль, чем управляемый жизненный цикл Ollama.
Когда HTTP недостаточно, C-подобная библиотека llama.cpp позволяет встроить инференс непосредственно в процесс. Приложение управляет инициализацией и завершением работы, а низкоуровневые настройки остаются рядом с его кодом. Ollama обычно работает как отдельный сервис. Выбирайте llama.cpp, когда инференс должен поставляться внутри приложения; выбирайте Ollama, когда предпочтительнее отдельная конечная точка.
От ноутбука к постоянно работающему частному серверу
Существует три границы выполнения.
- Инференс на устройстве выполняется на ноутбуке или рабочей станции, которая делает запрос.
- Удалённое частное self-hosting выполняется на сервере, контролируемом организацией; это может сохранять операционный контроль, но запросы проходят через сеть, и выполнение не локально по отношению к устройству.
- Облачный инференс от вендора выполняется на инфраструктуре провайдера.
Это различие важно, поскольку модели Ollama с облачной меткой выполняются в её облаке, даже если запрос отправляет клиент на localhost. «Использование Ollama» не доказывает локальное выполнение. Развёртывания со строго локальным режимом должны исключать или отключать облачную функциональность согласно текущей документации.
Оба проекта по умолчанию открывают сеть только локально. Ollama привязывается к localhost, а её API не имеет встроенной аутентификации. llama-server также по умолчанию использует loopback — доступ только с того же хоста — и предлагает опции API-ключа и TLS. Ни одно из значений по умолчанию не является полной границей для публичного развёртывания.
⚠️ Предупреждение: Локальный API Ollama не имеет встроенной аутентификации, и заглушки ключей, принимаемые примерами совместимости, его не защищают. Никогда не открывайте конечную точку по умолчанию напрямую в публичный интернет.
Прежде чем сделать любую из конечных точек доступной удалённо, используйте следующие меры контроля как минимальный барьер:
- Намеренно выбранный адрес привязки и граница частной сети или VPN.
- Аутентификация на сервере или через аутентифицированный шлюз.
- TLS для сетевой передачи.
- Ограничения файрвола, CORS, размера запросов, параллельности и ресурсов.
- Контроль процессов, управляемые обновления, проверки работоспособности и мониторинг.
- Логирование с учётом конфиденциальности, хранение и обработка данных, которые предотвращают утечку запросов, ответов или учётных данных.
Определите размер модели и квантование до рассмотрения аренды GPU-мощностей. Учитывайте активный контекст и параллельность, чтобы оценить VRAM и запас для работы. Если ноутбук не может обеспечить нужную производительность или время безотказной работы, арендованная GPU-инфраструктура, пригодная для LLM — с AlexHost в качестве одного из примеров — становится вариантом, но не обходным путём в обход расчёта требований.
Заявления вендоров о конфиденциальности не являются независимыми аудитами. Документируйте, где выполняется инференс и через какие сети проходят запросы. Фиксируйте, кто администрирует системы и что сохраняют хранилища или логи. Эта запись определяет границу конфиденциальности точнее, чем логотип среды выполнения.
Какой вариант выбрать? Рекомендации по сценариям использования
Эти рекомендации описывают соответствие рабочей нагрузке, а не уровень навыков. Удобство может быть инженерным требованием; прямой контроль может создавать ненужные накладные расходы. Выбор меняется, когда конкретное требование выходит за рамки абстракции.
Первый локальный эксперимент или инструмент разработчика: выбирайте Ollama, когда важна быстрая настройка и вы хотите работать с моделями по имени. Готовый API даёт инструменту стабильный интерфейс без затрат на управление жизненным циклом, которые не помогают оценке или интеграции. Выбирайте llama.cpp, если вам нужен неподдерживаемый бэкенд, точная сборка или низкоуровневая настройка, которая не предоставлена в Ollama.
Воспроизводимый пользовательский инференс или встраиваемое приложение: выбирайте llama.cpp, когда продукт должен владеть точным артефактом и сборкой. Он также напрямую управляет инициализацией и параметрами выполнения, что важно, когда инференс работает внутри приложения. Выбирайте Ollama, если отдельный HTTP-сервис и контроль на уровне Modelfile полностью удовлетворяют потребности продукта.
Ограниченное или нестандартное оборудование, либо максимальная тонкая настройка: начинайте с llama.cpp, если его более широкая матрица бэкендов или явное размещение решает конкретно заданное требование. Сначала убедитесь, что модель помещается в память. Выбирайте Ollama, когда он хорошо поддерживает ваше оборудование, а прямая настройка добавила бы сложность в обслуживании без полезного контроля или измеримого улучшения.
Приватный сервис, доступный команде: Ollama обычно является более простой отправной точкой для управления жизненным циклом и обслуживания при условии, что оператор добавит аутентифицированную сетевую границу. Рассмотрите llama-server, если важнее нативная защита API ключами, прямые средства управления сервисом или настройка бэкенда. Отвергайте оба варианта, если команда не может выполнить требования к постоянной работе, указанные выше.
Используйте оба: держите Ollama и самостоятельный llama.cpp как отдельные точки входа и отдельные домены жизненного цикла. Приложения могут выбирать проверенную конечную точку для регулярного обслуживания или контролируемых экспериментов, но не могут предполагать идентичное поведение API. Каждая среда выполнения может хранить собственное хранилище моделей, порт и процесс; если обе загружают модели, они могут конкурировать за ОЗУ или VRAM. Ollama не использует ваш отдельный сервис llama.cpp.
Таблица ниже подытоживает эти варианты. Не считайте строки баллами: одно жёсткое требование может перевесить все удобства в остальных строках.
| Область решения | Ollama | llama.cpp |
|---|---|---|
| 🚀 Самый быстрый старт | Интегрированный путь установки, модели и сервиса | Больше видимых вариантов получения, сборки и запуска |
| 🔄 Жизненный цикл модели | Загрузка по имени, управляемое хранилище, Modelfile, residency и планирование | Прямой доступ к GGUF или кэшу Hugging Face плюс управление роутером, пресетами и загрузкой; менее ориентирован на сквозное управление |
| 🎛️ Тонкая настройка | Автоматические значения по умолчанию с выбранными параметрами конфигурации и API | Более широкий прямой контроль над сборками, устройствами, размещением, кэшами и батчами |
| 🧩 Встраивание в процесс | Обычно используется как отдельный сервис | Библиотека в стиле C — более сильное прямое решение |
| 🌐 API-сервис | Нативный API плюс ограниченные слои совместимости | llama-server с ограниченной совместимостью и нативными операционными маршрутами |
| ⚙️ Гибкость бэкендов | Ограниченная поддержка в готовых пакетах | Более широкая матрица бэкендов на этапе сборки, с оговорками по сборке и зрелости |
| 🛠️ Операционная ответственность | Интегрированный жизненный цикл модели и сервиса; для использования за пределами локальной машины требуется внешняя аутентификация | Более явное владение сервером и нативные опции ключей и TLS; усиление защиты всё равно необходимо |
| 🎯 Наиболее подходящая нагрузка | Повторяемый повседневный локальный или приватный сервис моделей | Встраиваемый, экспериментальный, специфичный для оборудования или глубоко настраиваемый инференс |
Итог
Два пути из введения выглядели противоречивыми, потому что они по-разному распределяют ответственность. Выбирайте Ollama, когда сама интегрированная рабочая среда является ключевой функцией. Выбирайте llama.cpp, когда ключевая функция — прямой контроль над инференсом.
Если вы не уверены, убедитесь, что модель и квантование соответствуют вашему оборудованию. Проверьте расход памяти для предполагаемого контекста, затем начните с Ollama. Переходите на отдельный llama.cpp или добавляйте его только при конкретном низкоуровневом требовании: определённый бэкенд или сборка, встраивание в процесс или более тонкое размещение и настройка.