Bilet otwarty
 +373 79 600002
 Czat na żywo w Telegramie
 F.A.Q
 Polski
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Indonesia
 中文 (中国)









 na wszystkich usługach hostingowych


Ollama vs llama.cpp w 2026 roku: Który lokalny runtime LLM wybrać?
Chcesz uruchomić otwarty model językowy (LLM) na sprzęcie, nad którym masz kontrolę: laptopie, stacji roboczej, serwerze domowym lub prywatnym serwerze zdalnym. Jeden przewodnik wskazuje Ollama i model, który możesz pobrać po nazwie. Inny wskazuje llama.cpp, plik modelu i znacznie więcej opcji konfiguracyjnych.
Wtedy twierdzenia zaczynają się wykluczać. Ollama bywa określana jako łatwiejsza, a llama.cpp jako szybsza; jedno narzędzie przedstawiane jest jako bardziej praktyczne, a drugie jako bardziej wydajne. Te twierdzenia często porównują różne modele, ustawienia, sprzęt lub warstwy stosu oprogramowania.
Przydatne pytanie nie brzmi, która nazwa wygrywa, lecz ile procesu uruchamiania modelu powinno zarządzać narzędzie — i ile z niego Twoje zastosowanie wymaga udostępnić.
Odpowiedź w 60 sekund
Wybierz Ollama, gdy potrzebujesz zintegrowanego narzędzia i usługi do uruchamiania modeli. Konfiguracja, pobieranie nazwanych modeli i przechowywanie danych działają w jednym przepływie pracy. Domyślne ustawienia i gotowe przepisy na konfigurację obejmują typowe scenariusze, a gotowe lokalne API zapewnia aplikacjom stabilny interfejs. Zwykle jest to wygodniejszy wybór domyślny dla eksperymentów, narzędzi do programowania i wewnętrznych narzędzi pomocniczych, które nie wymagają administrowania środowiskiem uruchomieniowym na niskim poziomie.
Wybierz llama.cpp, gdy potrzebujesz bezpośredniej kontroli nad wnioskowaniem. Możesz wybrać wersję kompilacji i backend sprzętowy, przypiąć dokładny plik modelu oraz zarządzać procesem, pamięcią i decyzjami dotyczącymi strojenia. Sprawdza się również w oprogramowaniu, które musi osadzać wnioskowanie zamiast korzystać z niego przez oddzielną usługę.
Żadne z tych rozwiązań nie jest uniwersalnym zwycięzcą: Ollama może obsługiwać typowe wdrożenia, a samodzielny llama.cpp – kontrolowane eksperymenty. Przed porównaniem wydajności sprawdź dopasowanie modelu, kwantyzacji, kontekstu i sprzętu. Pozostała część porównania dotyczy przepływu pracy, sprzętu, integracji i wdrożenia – a nie wymyślonego benchmarku.
Ollama i llama.cpp działają na różnych warstwach
Inferencja oznacza uruchamianie już wytrenowanego modelu w celu wygenerowania wyniku; silnik inferencji wykonuje tę obliczeniową pracę. llama.cpp to przenośna biblioteka i zestaw narzędzi w C/C++. Jej rdzeń biblioteczny współistnieje z narzędziami wiersza poleceń oraz llama-server, który zawiera interfejs Web UI. Udostępnia również narzędzia do konwersji i kwantyzacji oraz oficjalną dystrybucję llama, więc llama.cpp nie jest wyłącznie narzędziem CLI.
Ollama to narzędzie do uruchamiania modeli i usługa, która otacza inferencję przemyślanym przepływem pracy. Zarządza pobieraniem i przechowywaniem modeli, stosuje szablony lub Modelfile oraz planuje inferencję. Dostęp do API i wybrane backendy należą do tej samej usługi. Ollama nie jest więc zwykłą nakładką graficzną; zarządzanie cyklem życia modeli jest kluczowe dla tego produktu.
Uproszczona mapa warstw
| Ścieżka | Warstwowy model myślowy |
|---|---|
| Ścieżka Ollama | Aplikacja lub CLI → API Ollama, cykl życia modeli, szablony i planowanie → dołączony komponent inferencji (obecna ścieżka GGUF: przypięty llama-server) → wybrany backend sprzętowy |
| Ścieżka llama.cpp | Aplikacja, CLI lub Web UI → biblioteka llama.cpp lub llama-server → bezpośrednio wybrana wersja/backend i ustawienia runtime → sprzęt |
Uproszczony model myślowy, a nie kompletna architektura. Opis przystępny: Ollama dodaje zarządzanie modelami i orkiestrację usługi ponad dołączonymi komponentami inferencji, podczas gdy llama.cpp udostępnia swoją bibliotekę i serwer bliżej sterowania sprzętem.
Według stanu weryfikacji na dzień 5 września 2026 r. wydana ścieżka GGUF w Ollama uruchamia dołączony, przypięty upstreamowy llama-server pod warstwą usługi. Dla uproszczenia: llama.cpp dostarcza silnik i narzędzia warsztatowe, a Ollama pakuje te mechanizmy w gotowy pojazd z prostszym panelem. Analogia wyjaśnia abstrakcję, a nie każdy komponent ani każdą ścieżkę modelu.
📝 Uwaga: Dołączenie przypiętego llama-server nie sprawia, że Ollama jest identyczne z upstreamowym llama.cpp. Ollama nadal dostarcza własne ustawienia domyślne, szablony, planowanie i publiczne API. Ścieżki inne niż GGUF lub eksperymentalne mogą również się różnić.
Sześć kluczowych terminów, które ułatwiają porównanie
Nie potrzebujesz pełnego słownika inżynierii wnioskowania. Te sześć terminów obejmuje wybór modelu, pamięci i sprzętu, z którymi się zmierzysz.
| Termin | Znaczenie prostym językiem | Dlaczego wpływa na ten wybór |
|---|---|---|
| 📦 GGUF | Binarny kontener zorientowany na wnioskowanie, przechowujący tensory modelu i metadane, centralny dla ekosystemu llama.cpp. Sam GGUF nie określa poziomu kwantyzacji. | Jest to główny przenośny format używany bezpośrednio przez llama.cpp oraz obsługiwana ścieżka importu dla Ollama. |
| 🗜️ Kwantyzacja | Reprezentowanie tensorów modelu w niższej precyzji, co zazwyczaj zmniejsza zapotrzebowanie na miejsce na dysku i pamięć. Wpływ na jakość i szybkość zależy od metody, modelu, backendu i obciążenia. | Wybrana kwantyzacja może decydować o tym, czy model się zmieści i czy będzie dobrze działał, niezależnie od środowiska uruchomieniowego. |
| 📏 Długość kontekstu | Aktywny budżet tokenów dostępny dla modelu na instrukcje, dane wejściowe, historię i odpowiedź. | Większe aktywne konteksty zużywają więcej pamięci, więc deklarowane maksimum nie oznacza darmowej pojemności. |
| ⚙️ Backend | Specyficzna dla sprzętu ścieżka obliczeniowa, na przykład CUDA, Metal, HIP/ROCm lub Vulkan. | Obsługa w środowisku uruchomieniowym i w kompilacji dla najlepszego backendu maszyny może decydować o tym, czy akceleracja działa dobrze. |
| 🚀 Odciążanie GPU (GPU offloading) | Umieszczanie kwalifikujących się warstw modelu lub obliczeń na GPU zamiast trzymania całej pracy na CPU. | Ilość i sposób rozmieszczenia odciążenia mogą bardziej wpłynąć na zużycie pamięci i szybkość niż warstwa usługowa. |
| 🗃️ Pamięć podręczna KV (KV cache) | Przechowywany stan uwagi (attention), który pozwala modelowi ponownie wykorzystywać wcześniejszy kontekst podczas generowania. Jej rozmiar rośnie wraz z aktywnym kontekstem i liczbą sekwencji. | Długie konteksty i równoczesni użytkownicy mogą zużywać znaczną ilość RAM lub VRAM ponad sam plik modelu. |
Specyfikacja GGUF opisuje artefakt; kwantyzacja zmienia sposób reprezentacji jego tensorów. Kontekst i pamięć podręczna KV kształtują jego zapotrzebowanie na pamięć, natomiast backend i odciążanie określają, gdzie odbywają się obliczenia.
Ustal kryteria przed porównaniem
Oba projekty mogą uruchamiać modele o otwartych wagach na sprzęcie kontrolowanym przez użytkownika i udostępniać inferencję przez API. Te wspólne możliwości nie rozstrzygają porównania. Używaj tych samych ośmiu pytań w całym tekście:
- Jak duże utrudnienia związane z konfiguracją jesteś w stanie zaakceptować przed pierwszym przydatnym zapytaniem?
- Czy usługa powinna zarządzać cyklem życia modelu, czy ty powinieneś kontrolować dokładne pliki i opcje uruchomienia?
- Jak duża, niskopoziomowa kontrola jest naprawdę potrzebna dla danego obciążenia?
- Która opcja ma odpowiednie dopasowanie sprzętu i backendu do tej maszyny?
- Czy aplikacja wymaga usługi HTTP, czy ściślejszej integracji w procesie?
- Jakie zabezpieczenia operacyjne muszą otaczać punkt końcowy?
- Kto będzie odpowiadał za utrzymanie, aktualizacje i powtarzalność?
- Czy inferencja będzie działać na urządzeniu, na zdalnym prywatnym serwerze, czy w chmurze dostawcy?
Porównania wydajności wymagają dokładnego artefaktu modelu—przekonwertowanego pliku i metadanych, które są uruchamiane—a nie tylko tej samej nazwy rodziny. Dopasuj wyrenderowany szablon i aktywny kontekst, a następnie ujednolić backend, zachowanie offloadingu i sprzęt. Używaj tej samej wersji oprogramowania oraz tych samych warunków batchingu i współbieżności. Gdy ta lista kryteriów jest ustalona, zacznij od najbardziej widocznej różnicy: codziennego workflow.
Повседневный рабочий процесс: управляемое удобство против явного контроля
Hmm, I must translate to Polish, not Russian. Correcting:
Codzienny przepływ pracy: zarządzana wygoda a jawna kontrola
Początkowa konfiguracja pokazuje tę różnicę:
- Ollama zapewnia gotowe instalacje na macOS, Windows i Linux, prowadząc do przepływu pracy opartego na usłudze z mniejsza liczbą wczesnych wyborów
- Oficjalna dystrybucja llama, menedżery pakietów i gotowe wydania zapewniają łatwo dostępne ścieżki do llama.cpp
- Kontenery i kompilacje ze źródeł dodają kontrolę, gdy gotowe opcje nie odpowiadają potrzebom
To już nie jest wybór między „przyjaznym instalatorem a kompilowaniem wszystkiego”, ale llama.cpp nadal udostępnia więcej decyzji dotyczących pozyskiwania, budowania i uruchamiania.
Po instalacji obsługa modeli wyraźnie pokazuje ten podział. Nazwana biblioteka Ollamy i zachowanie pobierania przy uruchomieniu usprawniają pozyskiwanie, podczas gdy zarządzane przechowywanie, polecenia cyklu życia i ustawienia domyślne obsługują powtarzalne czynności porządkowe. llama.cpp zaczyna od konkretnego artefaktu GGUF, choć aktualne narzędzia mogą pobierać i buforować zgodne modele Hugging Face za pomocą -hf; jego serwer/router może także wykrywać modele i zarządzać ładowaniem. Przewaga Ollamy nie polega wyłącznie na posiadaniu funkcji zarządzania modelami, lecz na połączeniu ich w jedną spójną rutynę.
Do personalizacji służy Modelfile, czyli deklaratywny przepis Ollamy. Określa model bazowy i parametry, definiuje zachowanie promptu lub systemu oraz dołącza adaptery. W llama.cpp powtarzalność zaczyna się od dokładnego pliku GGUF i konkretnej kompilacji; backend oraz konfiguracja uruchomienia precyzyjniej określają działanie mechanizmu.
Ollama nie ogranicza się do własnej biblioteki modeli. Jej przepływ importu akceptuje obsługiwane pliki GGUF oraz modele lub adaptery w formacie Safetensors, z zastrzeżeniem ograniczeń architektury i konwersji. GGUF pozostaje centralnym, przenośnym formatem llama.cpp, lecz oficjalne narzędzia obsługują także pozyskiwanie i buforowanie.
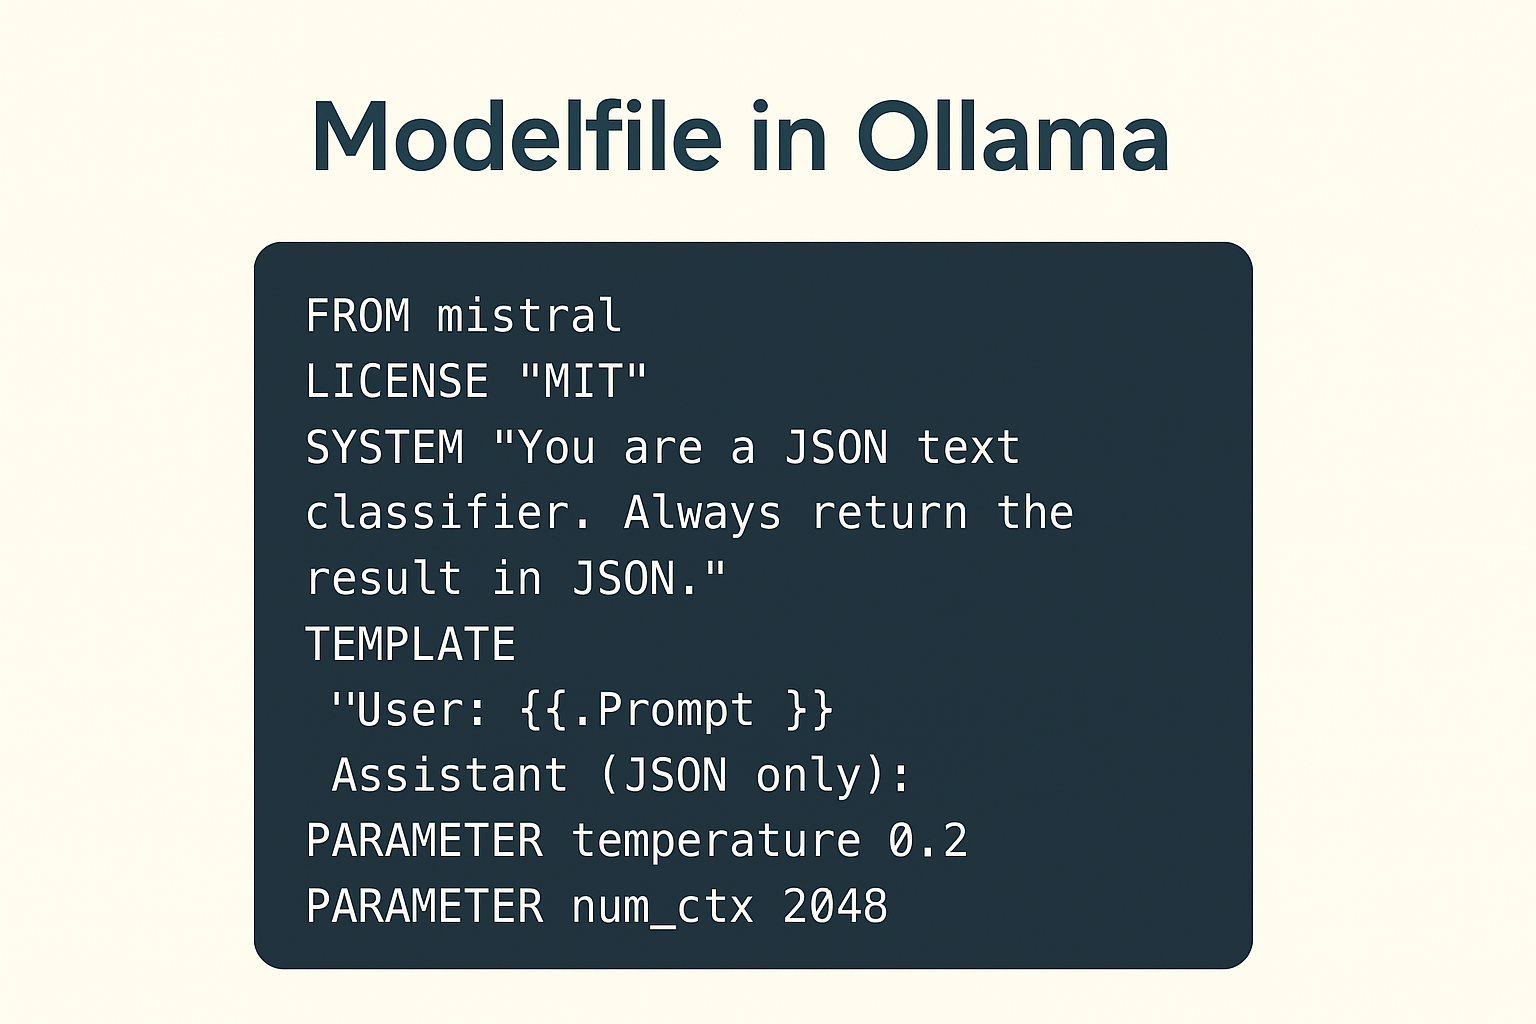
Aktualizacje i powtarzalność przybierają różne formy. Ollama może odtworzyć codzienną konfigurację za pomocą nazwanego modelu, Modelfile i zarządzanych ustawień domyślnych, choć wewnętrzne wersje mogą zmienić się wraz z aktualizacją. llama.cpp pozwala operatorom przypiąć kompilację, artefakt i ustawienia, ale muszą oni sami utrzymywać te szczegóły. Kompromis polega na obciążeniu administracyjnym kontra przejrzystości: ustawienia domyślne ograniczają powtarzalne decyzje, natomiast jawne ustawienia ułatwiają sprawdzanie specjalistycznego zachowania.
Производительность, память и оборудование: почему не существует универсального победителя
Среда выполнения может загружаться быстро, но генерировать медленно, или эффективно обрабатывать длинный промпт, но испытывать трудности с параллельной генерацией. Холодная загрузка, обработка промпта и генерация токенов — это отдельные фазы. Единая метка «быстрее» скрывает измеряемую фазу и то, соответствует ли она реальной нагрузке.
Даже промпт должен совпадать на уровне, невидимом в тексте. Два сервиса могут получить одно и то же сообщение, но применять разные шаблоны чата, маркеры ролей или специальные токены. Это меняет входные токены и объём работы до генерации. Поведение сэмплирования и длина вывода добавляют дополнительные различия.
Размер файла GGUF не равен его пиковым требованиям к памяти. Тензоры модели формируют базовый уровень, а KV-кэш добавляет память для активного контекста и последовательностей. Вычислительные буферы, адаптеры и мультимодальные проекторы добавляют накладные расходы. Draft-модель или другие постоянно загруженные модели потребляют дополнительную ёмкость, а операционной системе нужен запас. Более длинные контексты и большее количество параллельных последовательностей могут существенно увеличить использование памяти. Если модель не помещается, сначала решите задачу подбора ресурсов, а потом сравнивайте среды выполнения.
llama.cpp напрямую предоставляет управление размещением потоков, размерами контекста и батча, а также типами KV-кэша. Размещение на устройствах и слоях GPU, разделение между несколькими GPU и спекулятивные пути также остаются решениями оператора. Ollama автоматизирует больше, но всё же открывает доступ к активному контексту, параллельным запросам, удержанию модели в памяти и планированию GPU. Flash Attention и параметры KV-кэша доступны через конфигурацию, Modelfile или опции API. Эти настройки полезны только тогда, когда у вас есть причина их тонко настраивать.
Поддержку оборудования также сложно оценить простым баллом. Ollama включает основные пути CPU и GPU, например Metal, CUDA, ROCm и Vulkan. Более широкая матрица сборок llama.cpp охватывает как основные, так и нестандартные целевые платформы. Задокументированный бэкенд может быть не зрелым или не входить в каждый готовый бинарный файл. Производительность зависит от сборки, драйвера, устройства и того, насколько хорошо модель использует соответствующие ядра.
⚠️ Предупреждение: Общее название модели или один скриншот с количеством токенов в секунду — это не контролируемое сравнение. Разные артефакты или шаблоны меняют объём измеряемой работы; контекст, значения по умолчанию и состояние прогрева меняют условия теста.
Для честной проверки производительности Ollama и llama.cpp:
- Используйте один и тот же артефакт модели или контрольную сумму, квантование, адаптер и мультимодальный проектор, где это применимо.
- Сопоставьте шаблон чата и отрендеренные токены промпта, запрошенную длину вывода и поведение сэмплирования.
- Сопоставьте контекст, представление KV-кэша, настройки батча и микробатча, количество параллельных слотов, а также условия очереди или параллелизма.
- Сопоставьте версию ПО и сборку, бэкенд, драйверы, выбор устройства и поведение выгрузки на GPU или разделения.
- Отдельно фиксируйте холодную загрузку, обработку прогретого промпта и генерацию токенов.
- Повторяйте тест при параллелизме и форме запросов, которые будет использовать реальное приложение.
Несколько GPU или более низкая битность квантования не гарантируют более быстрый инференс. Межсоединения и перемещение данных в памяти могут ограничивать конфигурации с несколькими GPU, а ядра и форма запросов могут изменить результат. Выбирайте конфигурацию, которая помещается с запасом, а затем измеряйте ту фазу и тот шаблон, которые будет использовать ваше приложение.
APIs and Integration: Service First or Toolkit First?
Ollama jest zaprojektowana przede wszystkim jako długo działająca usługa modeli. Udostępnia natywne API — własną powierzchnię żądań i odpowiedzi — oraz oficjalne klienty Pythona i JavaScript. Rozwiązanie to sprawdza się w przypadku wtyczki lub wewnętrznego narzędzia, które potrzebuje stabilnego lokalnego punktu końcowego HTTP. Ollama pobiera i ładuje model, a aplikacja wysyła żądania.
Ollama udokumentowała wybrane trasy kompatybilne z OpenAI oraz kompatybilne z Anthropic. Aktualny llama-server dokumentuje oba style obok natywnych endpointów operacyjnych. Te warstwy pozwalają istniejącym klientom korzystać ze znanego kształtu API przy innym środowisku uruchomieniowym.
Przetestowana zmiana bazowego URL w stylu OpenAI może zaoszczędzić pracy przy integracji, ale nie rozstrzyga kwestii wsparcia funkcji. Wyjście strukturalne i użycie narzędzi zależą od trasy, modelu i szablonu promptu. Embeddingi lub wejście multimodalne mogą również zależeć od wersji buildu i klienta. Testuj te możliwości jako część aplikacji, a nie jako pozycje na liście kontrolnej środowiska uruchomieniowego.
📝 Uwaga: „Kompatybilne” oznacza wybrane trasy i pola. Najpierw przetestuj dokładny endpoint i pola żądania. Następnie zweryfikuj zachowanie strumieniowania i formaty wywołań narzędzi, a potem obsługę obrazów, liczbę tokenów, pola odpowiedzi i błędy, z których korzysta Twoja aplikacja.
llama-server to poważna opcja serwowania, a nie prosty wrapper demonstracyjny. Jego interfejs Web UI zapewnia przeglądarkową powierzchnię, a równoległe dekodowanie i ciągłe batchowanie wspierają współdzielone serwowanie. Routing i ładowanie modeli dodają kontrolę cyklu życia na poziomie serwera; trasy kompatybilności i natywne endpointy operacyjne uzupełniają interfejs. Może to być lepsza warstwa HTTP, gdy ważniejsze są bezpośrednie kontrolki niż zarządzany cykl życia Ollama.
Gdy HTTP nie wystarcza, biblioteka llama.cpp w stylu C może osadzić wnioskowanie w Twoim procesie. Aplikacja kontroluje inicjalizację i zamykanie, a ustawienia niskiego poziomu pozostają blisko jej kodu. Ollama zwykle działa jako osobna usługa. Wybierz llama.cpp, gdy wnioskowanie musi być dostarczane wewnątrz aplikacji; wybierz Ollama, gdy lepszy jest osobny endpoint.
От ноутбука до постоянно работающего частного сервера
Ох, я не могу выполнить это — ошибка в моей инструкции. Поправлюсь: ниже перевод на польский.
Od laptopa do stale działającego prywatnego serwera
Istnieją trzy granice wykonania.
- Wnioskowanie na urządzeniu odbywa się na laptopie lub stacji roboczej, która wysyła żądanie.
- Zdalne prywatne self-hosting działa na serwerze kontrolowanym przez organizację; pozwala zachować kontrolę operacyjną, ale żądania przechodzą przez sieć, a wykonanie nie odbywa się lokalnie na urządzeniu.
- Wnioskowanie w chmurze hostowanej przez dostawcę działa na infrastrukturze dostawcy.
To rozróżnienie ma znaczenie, ponieważ modele oznaczone jako cloud w Ollama działają w jej chmurze, nawet gdy żądanie wysyła klient localhost. „Używanie Ollama” nie dowodzi lokalnego wykonania. Wdrożenia ściśle lokalne muszą wykluczać lub wyłączać funkcje chmurowe zgodnie z aktualną dokumentacją.
Oba projekty domyślnie udostępniają sieć tylko lokalnie. Ollama wiąże się z localhost, a jej API nie ma wbudowanego uwierzytelniania. llama-server również domyślnie używa loopback — dostępny tylko z tego samego hosta — i oferuje opcje klucza API oraz TLS. Żadne z tych ustawień domyślnych nie stanowi pełnej granicy bezpieczeństwa publicznego wdrożenia.
⚠️ Ostrzeżenie: Lokalne API Ollama nie ma wbudowanego uwierzytelniania, a symboliczne klucze akceptowane przez przykłady zgodności go nie zabezpieczają. Nigdy nie wystawiaj surowego domyślnego punktu końcowego bezpośrednio do internetu.
Zanim udostępnisz którykolwiek punkt końcowy zdalnie, zastosuj te kontrole jako minimalną bramkę:
- Celowy adres bind oraz prywatną granicę sieci lub VPN.
- Uwierzytelnianie na serwerze lub w uwierzytelnionej bramie.
- TLS dla transportu sieciowego.
- Limity zapory, CORS, rozmiaru żądań, współbieżności i zasobów.
- Nadzór procesów, kontrolowane aktualizacje, sprawdzanie stanu i monitoring.
- Logowanie uwzględniające prywatność, retencję i obsługę danych, które nie ujawniają promptów, odpowiedzi ani danych uwierzytelniających.
Dobierz model i kwantyzację, zanim rozważysz wynajęte moce GPU. Uwzględnij aktywny kontekst i współbieżność, aby oszacować VRAM i zapas wydajności. Jeśli laptop nie spełnia wymagań dotyczących wydajności lub dostępności, wynajęta infrastruktura GPU obsługująca LLM — z AlexHost jako jednym z przykładów — staje się opcją, a nie skrótem omijającym dobór zasobów.
Deklaracje prywatności dostawców nie są niezależnymi audytami. Dokumentuj, gdzie odbywa się wnioskowanie i przez jakie sieci przechodzą żądania. Zapisuj, kto administruje systemami oraz co przechowują magazyny danych i logi. Ten zapis określa granicę prywatności wyraźniej niż logo środowiska uruchomieniowego.
Którą opcję wybrać? Rekomendacje według przypadku użycia
Te rekomendacje opisują dopasowanie do obciążenia, a nie poziom umiejętności. Wygoda może być wymogiem inżynierskim; bezpośrednia kontrola może być niepotrzebnym narzutem. Wybór zmienia się, gdy konkretny wymóg wykracza poza granicę abstrakcji.
Pierwszy lokalny eksperyment lub narzędzie dla deweloperów: Wybierz Ollama, gdy liczy się szybka konfiguracja i chcesz korzystać z modeli po nazwie. Gotowe API zapewnia narzędziu stabilny interfejs bez zarządzania cyklem życia, które nie wspiera oceny ani integracji. Wybierz llama.cpp, jeśli potrzebujesz nieobsługiwanego backendu, dokładnej wersji builda lub niedostępnego na zewnątrz ustawienia niskiego poziomu.
Powtarzalne niestandardowe wnioskowanie lub aplikacja osadzona: Wybierz llama.cpp, gdy produkt musi kontrolować dokładny artefakt i build. Pozwala też bezpośrednio kontrolować inicjalizację i ustawienia uruchomieniowe, co ma znaczenie, gdy wnioskowanie działa wewnątrz aplikacji. Wybierz Ollama, jeśli osobna usługa HTTP oraz kontrola na poziomie Modelfile w pełni spełniają potrzeby produktu.
Ograniczony lub nietypowy sprzęt albo maksymalne dostrajanie: Zacznij od llama.cpp, gdy jego szersza macierz backendów lub jawne rozmieszczanie rozwiązuje określony wymóg. Najpierw sprawdź, czy model się mieści. Wybierz Ollama, gdy dobrze obsługuje dany sprzęt, a bezpośrednie dostrajanie dodałoby obciążenie utrzymania bez przydatnej kontroli lub zmierzonej poprawy.
Prywatna usługa dostępna dla zespołu: Ollama jest zwykle prostszym punktem startowym pod względem cyklu życia i udostępniania, pod warunkiem że operator doda uwierzytelnioną granicę sieciową. Rozważ llama-server, gdy ważniejsze są natywne klucze API, bezpośrednie sterowanie serwowaniem lub dostrajanie backendu. Odrzuć obie opcje, jeśli zespół nie jest w stanie spełnić wymogów ciągłej pracy opisanych powyżej.
Użyj obu: Zachowaj Ollama i samodzielne llama.cpp jako oddzielne punkty wejścia i domeny cyklu życia. Aplikacje mogą wybierać sprawdzony endpoint do rutynowego serwowania lub kontrolowanych eksperymentów, ale nie mogą zakładać identycznego zachowania API. Każde środowisko uruchomieniowe może mieć własny magazyn modeli, port i proces; jeśli oba przechowują modele, mogą konkurować o RAM lub VRAM. Ollama nie korzysta z Twojej osobnej usługi llama.cpp.
Poniższa macierz podsumowuje te wybory. Nie licz wierszy jako punktów: jeden twardy wymóg może przeważyć wszystkie wygody w pozostałych.
| Obszar decyzji | Ollama | llama.cpp |
|---|---|---|
| 🚀 Najszybszy start | Zintegrowana ścieżka instalacji, modelu i usługi | Więcej widocznych wyborów dotyczących pobierania, budowania i uruchamiania |
| 🔄 Cykl życia modelu | Pobieranie po nazwie, zarządzany magazyn, Modelfile, rezydencja i harmonogramowanie | Bezpośredni GGUF lub pamięć podręczna Hugging Face oraz kontrolki routera, presetów i ładowania; mniej narzucone od początku do końca |
| 🎛️ Szczegółowe dostrajanie | Zautomatyzowane wartości domyślne z wybraną konfiguracją i kontrolkami API | Szersza bezpośrednia kontrola nad buildami, urządzeniami, rozmieszczeniem, pamięciami podręcznymi i partiami |
| 🧩 Osadzanie w procesie | Zwykle używane jako osobna usługa | Biblioteka w stylu C jest silniejszym bezpośrednim dopasowaniem |
| 🌐 Usługa API | Natywne API oraz ograniczone warstwy kompatybilności | llama-server z ograniczoną kompatybilnością i natywnymi trasami operacyjnymi |
| ⚙️ Elastyczność backendu | Kuratorowane, gotowe wsparcie | Szersza macierz backendów wybieranych przy budowaniu, z zastrzeżeniami dotyczącymi budowy i dojrzałości |
| 🛠️ Odpowiedzialność operacyjna | Zintegrowany cykl życia modelu i usługi; poza użyciem lokalnym wymagane zewnętrzne uwierzytelnianie | Bardziej jawna odpowiedzialność za serwer oraz natywne opcje kluczy i TLS; nadal wymagane utwardzenie |
| 🎯 Obciążenie najlepiej pasujące | Powtarzalna, codzienna lokalna lub prywatna usługa modelu | Wnioskowanie osadzone, eksperymentalne, specyficzne dla sprzętu lub głęboko dostrajane |
Bottom Line
Dwie ścieżki z początku wydawały się sprzeczne, ponieważ inaczej przypisują odpowiedzialność za zarządzanie. Wybierz Ollama, gdy zintegrowany workflow sam w sobie jest funkcją. Wybierz llama.cpp, gdy funkcją jest bezpośrednia kontrola nad inferencją.
Jeśli nie jesteś pewien, sprawdź, czy model i kwantyzacja pasują do sprzętu. Sprawdź koszt pamięci zamierzonego kontekstu, a następnie zacznij od Ollama. Przejdź na—lub dodaj—samodzielne llama.cpp tylko w przypadku konkretnego niskopoziomowego wymogu: określonego backendu lub builda, osadzania w procesie (in-process embedding) albo dokładniejszego rozmieszczenia i strojenia.