Buka Tiket
 +373 79 600002
 Obrolan Langsung Telegram
 F.A.Q
 Indonesia
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 中文 (中国)


 untuk semua layanan hosting


Kasus Penggunaan Server RTX 4070 Ti SUPER Terbaik di 2026
Ваши документы для онбординга могут превращаться в ответы со ссылками на источники. Владеющее вами фото продукта может стать концептами фона для кампании. Существующая 3D-сцена может превратиться в готовые визуалы продукта, и всё это без того, чтобы ноутбук был занят. Это три практических сценария использования сервера с RTX 4070 Ti SUPER: сфокусированные задачи с понятными результатами.
Восемь вариантов ниже являются альтернативами, а не приложениями для одновременной загрузки. Здесь «лучший» означает полезные результаты с реалистичным программным путём, а не рейтинг по бенчмаркам. Компактные модели для работы с изображениями и текстом и рабочие процессы редактирования расширяют набор возможностей в 2026 году; кодирование и рендеринг по-прежнему остаются полезными. Выберите один сфокусированный сервис или очередного воркера, который может работать независимо от вашего ноутбука.
Batas yang berguna: 16 GB ruang kerja cepat
RTX 4070 Ti SUPER memiliki VRAM 16 GB—memori kerja GPU. Itu adalah meja kerja untuk model dan scene, sehingga proyek di bawah ini menggunakan model yang lebih kecil dan tugas yang terbatas. Perangkat lunak NVIDIA yang kompatibel menangani AI dan rendering; perangkat keras encoding video khusus mendukung pekerjaan media. Ini adalah titik awal yang didukung dokumentasi, bukan tolok ukur deployment. Masing-masing mengasumsikan satu kartu yang dikonfigurasi dengan tepat.
1. Задайте вопросы своим документам, а не всему интернету
Ну, нет — переводим на индонезийский, не на русский. Вот правильный перевод:
1. Ajukan pertanyaan kepada dokumen Anda sendiri, bukan seluruh internet
Rekan tim baru bertanya daftar periksa orientasi mana yang berlaku untuk perannya. Alih-alih mencari di folder, mereka menerima draf jawaban yang ditautkan ke berkas orientasi atau runbook yang disetujui. Dengan model yang di-self-host secara remote dan akses tim yang dikontrol, hal ini dapat menjadi layanan pengetahuan pribadi.
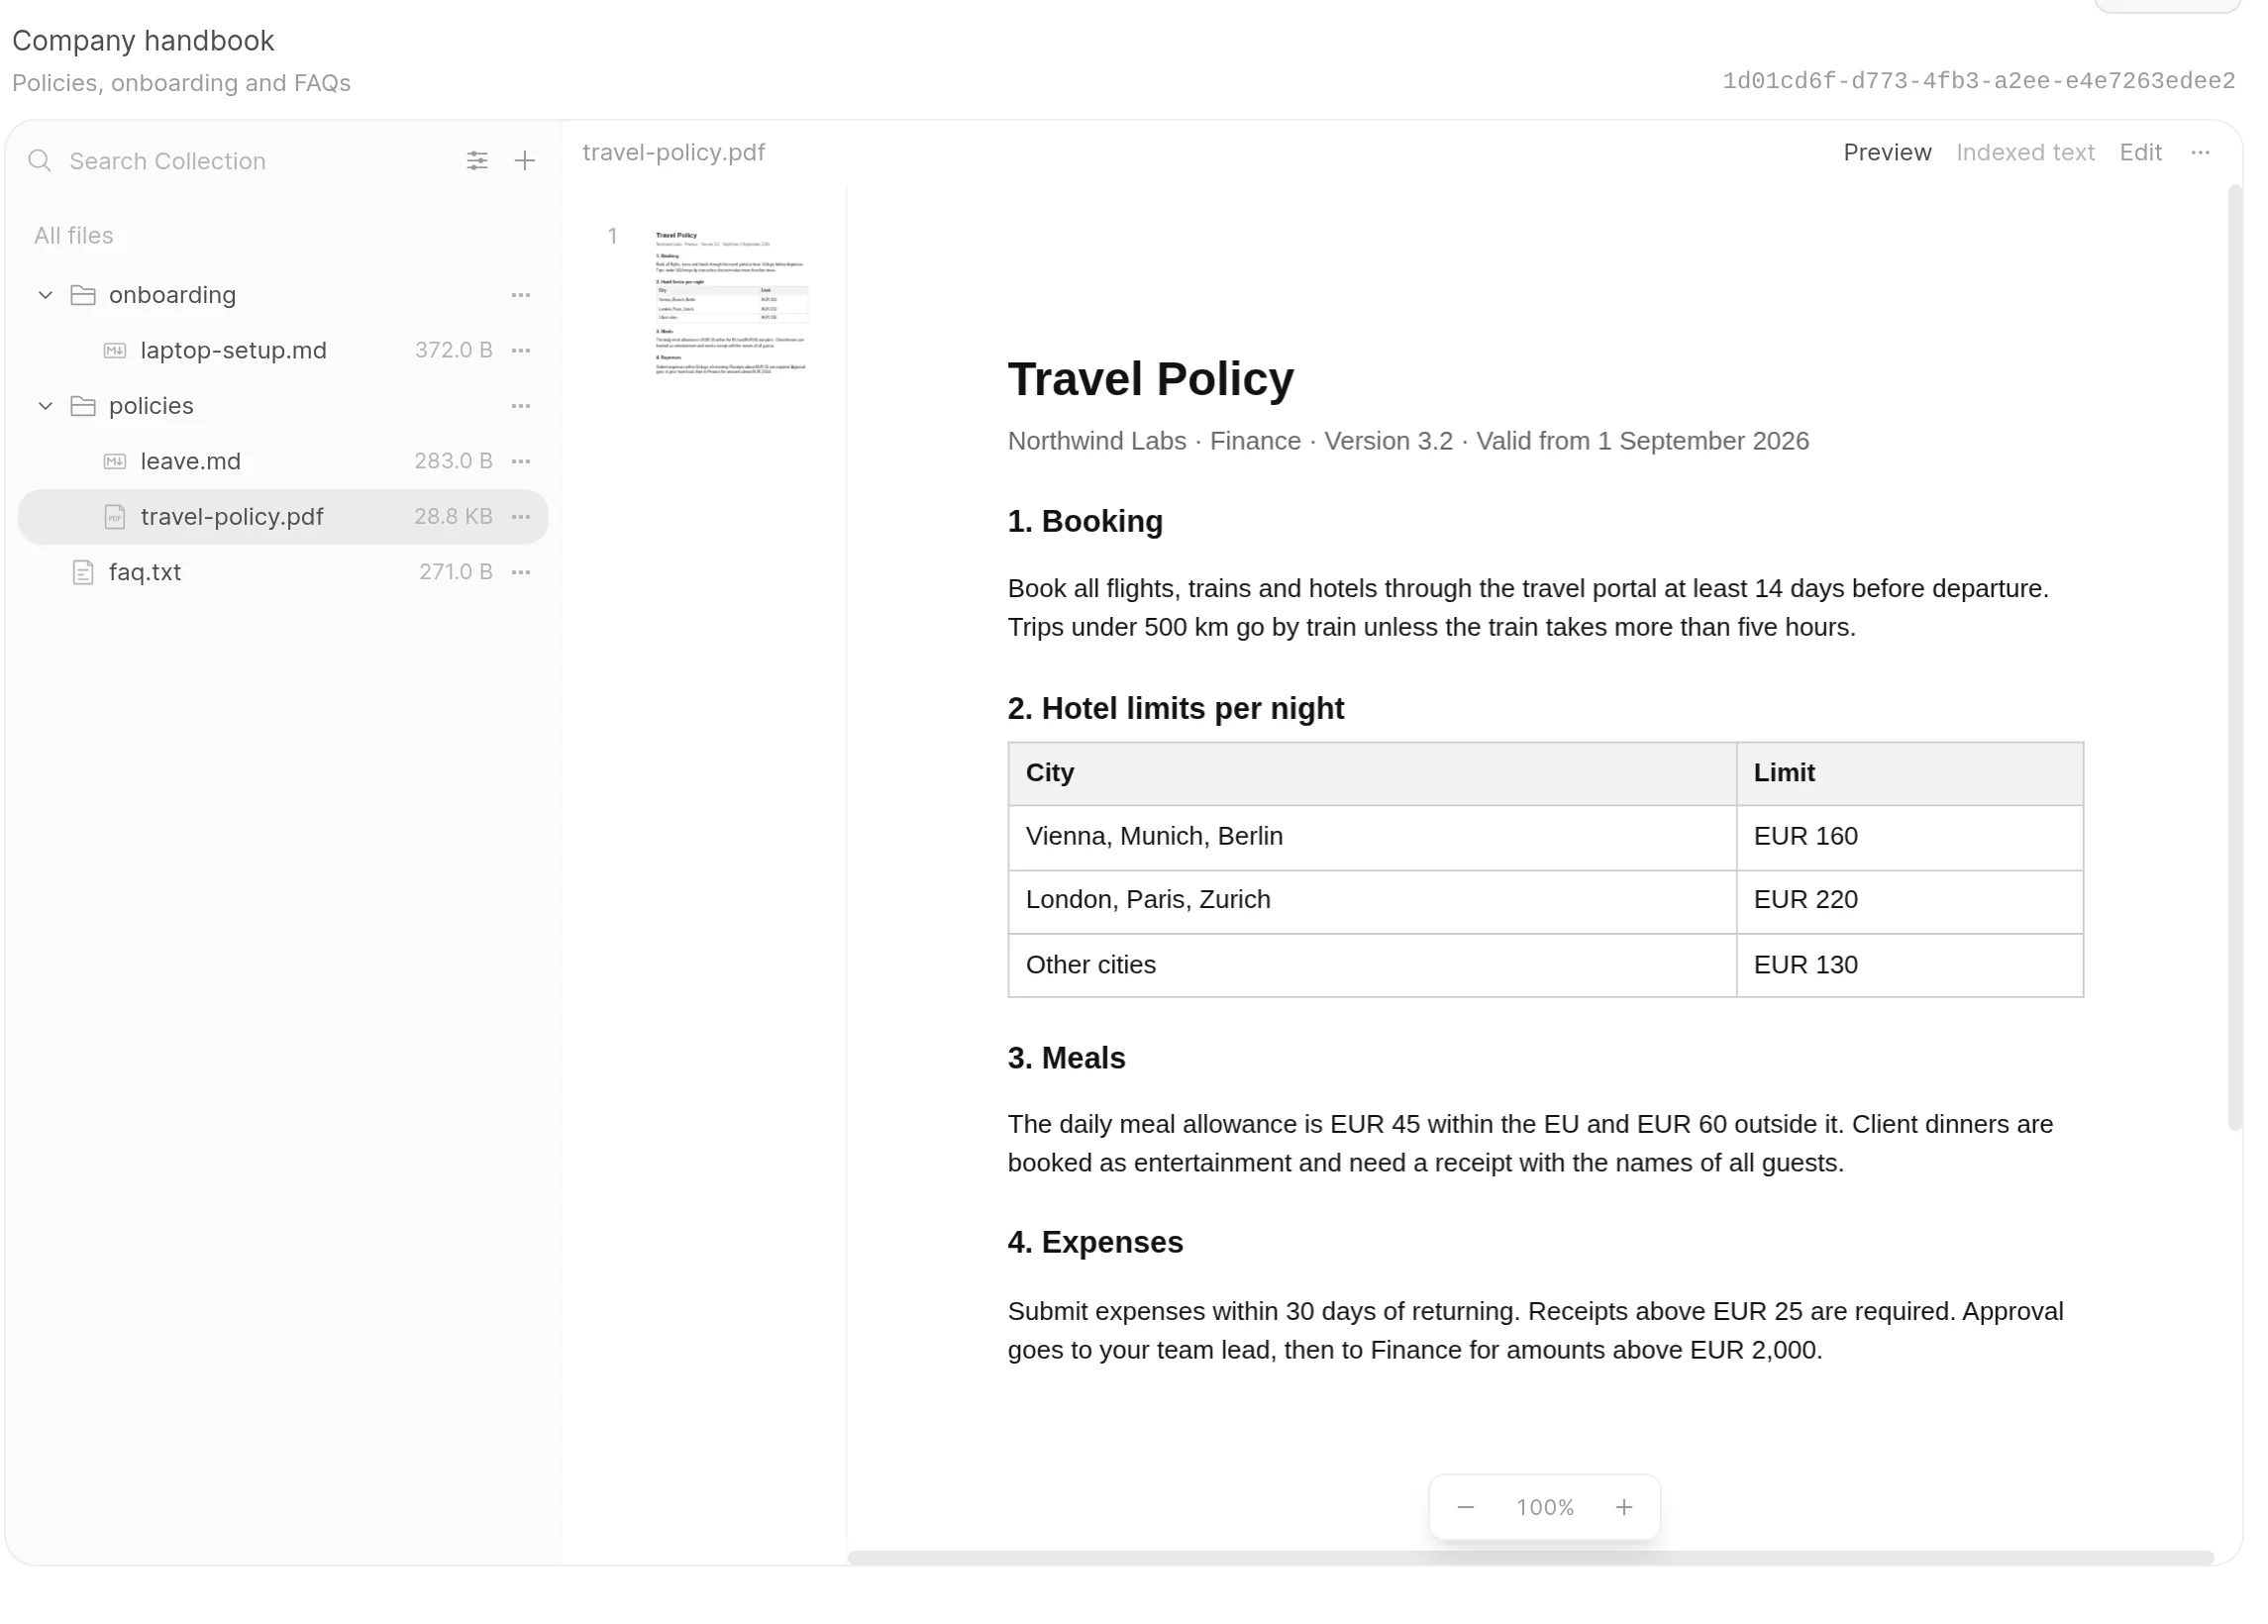
Retrieval-augmented generation, atau RAG, bekerja seperti asisten buku terbuka: perangkat lunak menemukan bagian yang relevan dan memberikannya kepada model sebelum model menjawab. Embedding membuat bagian-bagian tersebut dapat dicari berdasarkan makna, bukan hanya kata-kata yang persis sama. Mengunggah dokumen tidak melatih ulang model; jawabannya bergantung pada materi yang diambil untuk pertanyaan tersebut.
📝 Catatan: Inferensi privat berarti model berjalan di server remote, bukan berarti setiap komponen bersifat privat. Periksa di mana embedding dan penguraian dokumen dijalankan. Log dan fallback eksternal juga perlu ditinjau. Hosting remote tetap merupakan hubungan kepercayaan dengan penyedia.
GPU terutama mempercepat inferensi: menggunakan model yang sudah dilatih untuk menghasilkan jawaban. Model terkuantisasi menyimpan angkanya dengan bit yang lebih sedikit, menghemat memori dengan kemungkinan trade-off kualitas. Pertanyaan dan bagian yang diambil membentuk bagian dari konteks-nya, yaitu informasi yang dipertahankan dalam permintaan. Pencocokan bagian dapat menggunakan komponen self-hosted yang kecil; penyimpanan dan pencarian file tidak selalu memerlukan layanan GPU besar lainnya.
- Proyek awal: Satu kumpulan orientasi dan pertanyaan dengan jawaban yang sudah diketahui. Periksa jawaban terhadap bagian yang dikutip; sertakan pertanyaan yang tidak terjawab untuk melihat apakah asisten mengakui informasi yang hilang.
- Contoh stack: Open WebUI untuk dokumen dan pengambilan; embedding self-hosted untuk pencocokan bagian; Ollama yang menjalankan Qwen3.5-4B terkuantisasi untuk jawaban sisi server.
- Batasan utama: Kualitas pengambilan dan izin menentukan apa yang sampai ke model. Kutipan membantu Anda memeriksa jawaban; kutipan tidak menjamin kebenaran.
2. Дайте команде собственную студию генерации и редактирования изображений
Ошибка: переводим на индонезийский, не на русский. Исправляю ниже.
2. Berikan tim studio pembuatan dan pengeditan gambar sendiri
Sebuah toko kecil memiliki foto produk dan membutuhkan konsep latar belakang kampanye: latar studio, suasana musiman, atau palet warna yang berbeda. Hasilnya berupa sejumlah draf yang dapat dipilih dan disempurnakan oleh seseorang—tujuan awal yang lebih mudah dikelola dibandingkan menggantikan fotografi produk.
Alur kerja visual menghubungkan stasiun pemrosesan, yang disebut node, yang memuat gambar referensi, menerapkan instruksi, dan menyimpan hasil. GPU menjalankan model gambar untuk mengubah foto dan prompt menjadi variasi. Menyimpan alur kerja tersebut memberi tim titik awal yang dapat diulang untuk rangkaian konsep berikutnya.
Anggota tim dapat mengirimkan tugas ke antrean server bersama alih-alih membangun ulang pengaturan di masing-masing desktop. Model FLUX.2 [klein] 4B yang diusulkan menggunakan lisensi Apache-2.0, yang memungkinkan penggunaan komersial sesuai ketentuannya. Lisensi tersebut berlaku untuk varian ini, bukan untuk setiap model FLUX; hak atas gambar tetap penting.
- Proyek awal: Buat beberapa variasi latar belakang untuk satu gambar produk yang dimiliki. Bandingkan bentuk, teks kemasan, logo, dan konsistensi merek dengan gambar asli sebelum digunakan.
- Contoh tumpukan teknologi: ComfyUI untuk alur kerja visual yang disimpan dan antrean tugas; FLUX.2 [klein] 4B yang telah didistilasi untuk pembuatan dan pengeditan gambar referensi di GPU.
- Batasan utama: Gambar yang meyakinkan tetap dapat mengubah produk atau teksnya. Perlakukan hasil sebagai konsep yang memerlukan tinjauan keakuratan dan hak.
3. Превращайте записи в транскрипты, субтитры и материалы для поиска
Ошибка: the target language is Indonesian, not Russian. Correcting now.
3. Ubah rekaman menjadi transkrip, subtitle, dan pengetahuan yang dapat dicari
Webinar Anda atau rapat yang direkam dengan persetujuan yang sesuai dapat berisi informasi yang sulit ditemukan nanti. Pekerja transkripsi mengubahnya menjadi teks berstempel waktu dan file subtitle. Atur transkrip yang sudah ditinjau, dan pencarian teks biasa dapat membantu Anda menemukan topik tanpa memutar ulang setiap rekaman.

Model ucapan pertama-tama menghasilkan segmen transkrip dengan stempel waktu. Pembungkus ekspor—kode aplikasi di sekitar pustaka pengenalan—kemudian menyimpannya sebagai teks yang mudah dibaca dan file subtitle SRT atau VTT. Stempel waktu tersebut menghubungkan kata-kata kembali ke rekaman dan memberikan informasi waktu bagi pengekspor subtitle.
Folder unggahan atau antrean memungkinkan server memproses tumpukan rekaman tanpa pengawasan, dengan GPU menangani pengenalan ucapan. Ringkasan opsional memerlukan model lain, sebaiknya dijadwalkan terpisah pada satu kartu. Label pembicara memerlukan tahap terpisah untuk membedakan pembicara; transkripsi saja tidak menyediakannya.
- Proyek awal: Proses beberapa rekaman yang sudah mendapat izin menjadi transkrip dan subtitle. Bandingkan sampel dengan audio, periksa nama, kosakata teknis, dan waktu subtitle.
- Contoh tumpukan: faster-whisper dengan large-v3 dan pengaturan GPU presisi tereduksi yang sesuai; antrean unggahan; pembungkus ekspor untuk file subtitle dan penyimpanan transkrip yang dapat dicari.
- Batasan utama: Kualitas audio menentukan beban koreksi. Kebisingan, aksen, istilah yang tidak familiar, dan pembicara yang tumpang tindih dapat menimbulkan kesalahan yang perlu ditinjau manusia.
4. Подключение частного помощника по коду к редактору
Ошибка: the target language is Indonesian, not Russian. Correcting:
4. Hubungkan asisten kode pribadi ke editor Anda
Pilih sebuah fungsi di editor Anda lalu minta pembuatan tes, penjelasan, atau refaktor kecil. Anda akan mendapatkan draf kode di samping fungsi yang sedang Anda kerjakan. Editor dan file kerja Anda dapat tetap berada di laptop, sementara kode yang dipilih dikirim ke server untuk inferensi.
Editor mengirimkan kode yang dipilih dan pertanyaan Anda ke endpoint model jarak jauh, lalu menampilkan responsnya di ruang kerja pengembangan. Menyertakan perilaku fungsi yang dimaksud membantu membuat permintaan menjadi lebih konkret. Untuk tugas penulisan tes, hasilnya memberi Anda draf untuk dibandingkan dengan perilaku tersebut, bukan file tes kosong.
GPU menangani pembuatan respons, sementara server menyediakan endpoint yang dapat digunakan kembali untuk permintaan dari editor. Tetap kendalikan eksekusi dan perubahan berisiko, dengan izin yang dibatasi. Chat di editor adalah alur kerja awal di sini; autocomplete inline yang responsif memiliki kebutuhan model dan latensi yang berbeda.
- Proyek awal: Buat draf tes untuk satu modul. Periksa tes tersebut, jalankan di lingkungan pengembangan yang terkontrol, dan verifikasi perilaku yang dimaksud—bukan sekadar apakah tes tersebut dapat dikompilasi.
- Contoh stack: Lanjutkan untuk chat editor dan usulan perubahan; endpoint Ollama yang terkontrol menjalankan Qwen3.5-4B terkuantisasi di server untuk pembuatan respons.
- Batasan utama: Kualitas model kecil, konteks kode yang terbatas, dan latensi jaringan membatasi bantuan yang dapat diberikan. Ini bukan pengganti sistem coding komersial terbesar.
5. Ubah faktur dan hasil pemindaian menjadi catatan terstruktur
Gambar faktur dapat diubah menjadi kolom usulan untuk vendor, tanggal, nomor faktur, dan total dalam spreadsheet tinjauan. Menautkan setiap baris ke dokumen aslinya memudahkan perbandingan. Manfaat praktisnya adalah kumpulan catatan yang konsisten, yang dapat diperiksa seseorang dan diteruskan ke proses bisnis berikutnya.

Sebuah vision-language model menerima gambar maupun teks. Siapkan satu gambar halaman dalam satu waktu, lalu minta model tersebut mengambil kolom yang Anda butuhkan. Dengan cara ini GPU berguna untuk interpretasi visual, bukan dengan asumsi bahwa model dapat mengurai setiap jenis PDF. PDF berbasis teks yang bersih mungkin hanya memerlukan pengurai biasa tanpa GPU.
Setelah ekstraksi, kode aplikasi biasa memeriksa bahwa nilai yang wajib ada tersedia dan bahwa tanggal serta angka menggunakan format yang diharapkan. Kode ini juga dapat memeriksa aritmetika jika tersedia dan mencari pengenal faktur yang duplikat. Kolom yang hilang atau tidak pasti tetap ditandai. Server menggabungkan hasil batch beserta sumbernya untuk serah terima tinjauan:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Kolom hasil ekstraksi bersifat usulan sampai pemeriksaan biasa dan tinjauan manusia selesai; hanya setelah itu kolom tersebut boleh menjadi catatan yang disetujui.
- Proyek awal: Ubah satu jenis faktur menjadi spreadsheet tinjauan dengan referensi sumber. Bandingkan setiap kolom yang dipilih dengan dokumen asli sebelum menerima baris tersebut.
- Contoh tumpukan teknologi: Persiapan gambar halaman; Ollama dengan Qwen3.5-4B untuk ekstraksi visual; kode validasi/ekspor biasa dan langkah tinjauan untuk menghasilkan catatan spreadsheet yang disetujui dengan referensi sumber.
- Batasan utama: Nilai yang tampak masuk akal bisa saja salah. Wajibkan persetujuan manusia sebelum entri akuntansi atau pembayaran.
6. Mengolah video unggahan agar siap untuk berbagai penonton
Sebuah pelajaran atau demonstrasi produk mungkin memerlukan beberapa versi distribusi, bukan rekaman baru. Transkoding mengonversi video terenkode yang sudah ada. Master yang sesuai dapat menjadi salinan 1080p dan 720p untuk berbagai layar dan koneksi. Menurunkan resolusi dapat membantu distribusi; menaikkannya tidak dapat memulihkan detail yang hilang.
NVENC adalah encoder video khusus dari NVIDIA, terpisah dari komputasi model bahasa. Codec adalah teknologi yang digunakan untuk meng-encode dan men-decode video. H.264 adalah pilihan awal yang kompatibel secara luas; AV1 adalah opsi lain jika perangkat pemutaran target Anda mendukungnya. Decoding dan penskalaan mungkin melibatkan perangkat keras GPU lain atau CPU.
Server dapat menerapkan pengaturan konversi yang konsisten pada unggahan yang antre dan menyimpan salinan distribusi secara terpisah dari master. Perangkat keras media menangani encoding yang didukung, tetapi pengaturan tetap memengaruhi hasilnya. Pilih encoding perangkat keras untuk throughput, bukan peningkatan kualitas yang dijamin dibandingkan encoding CPU.
- Proyek awal: Konversi satu rekaman milik Anda menjadi versi 1080p dan 720p. Periksa pemutaran di perangkat target, sinkronisasi suara, keterbacaan konten, dan ukuran file.
- Contoh stack: FFmpeg untuk konversi dengan encoding yang didukung NVIDIA; antrean unggahan sederhana untuk menjadwalkan tugas dan penyimpanan untuk file sumber serta versi distribusi yang sudah jadi.
- Batasan utama: Kapasitas bergantung pada codec, pengaturan, pembatasan sesi driver, aktivitas disk, dan bandwidth transfer—bukan hanya memori GPU.
7. Відправлення рендерів Blender на віддалений GPU-воркер
Wait, the target language is Indonesian, not Ukrainian. Correcting:
7. Mengirim render Blender ke worker GPU jarak jauh
Seorang desainer produk dapat tetap memodelkan secara lokal sementara server menghasilkan gambar diam final atau frame turntable. Rendering berarti menghitung gambar final dari adegan 3D yang sudah ada, bukan menciptakan gambar dari prompt teks. Anda menyediakan adegan, material, pencahayaan, dan kamera; worker menghitung gambar jadi.
Backend rendering menghubungkan perhitungan adegan dengan akselerasi perangkat keras RTX. Anda dapat menjalankan rendering latar belakang tanpa desktop jarak jauh yang interaktif, sehingga pekerjaan yang telah disiapkan menghasilkan file output di server. Pilih rendering GPU secara terpisah; mode latar belakang saja tidak memilih perangkat rendering.
Proses serah terima memerlukan fitur Blender yang kompatibel dan semua aset yang dibutuhkan: kemas tekstur bersama proyek atau pastikan jalurnya dapat diakses di server. Waktu unggah dan persiapan dapat melebihi manfaatnya untuk pekerjaan kecil. Fallback memori yang didukung dapat membantu adegan besar agar muat, dengan trade-off performa.
- Proyek awal: Render satu adegan produk sederhana menjadi gambar diam final atau turntable pendek. Periksa tekstur, material, pencahayaan, dan framing pada satu frame yang representatif sebelum memasukkan semuanya ke antrean.
- Contoh tumpukan: Blender Cycles untuk rendering adegan; NVIDIA OptiX untuk akselerasi GPU; eksekusi latar belakang untuk menghasilkan file output tanpa memerlukan desktop jarak jauh yang interaktif.
- Batasan utama: Memori adegan dan tekstur menentukan kesesuaian. Beberapa kartu umumnya tidak menggabungkan memori adegan pada perangkat keras ini.
8. Адаптация небольшой модели под один повторяемый сценарий
Ошибка: переводить на русский нельзя, так как сайт AlexHost ориентирован на индонезийский язык. Ниже перевод на индонезийский язык.
8. Menyesuaikan model kecil untuk satu tugas yang dapat diulang
Tingkat lanjut. Anda dapat menyesuaikan model kecil untuk mengklasifikasikan permintaan dukungan ke dalam kategori yang sudah ada: penagihan, akses akun, atau masalah teknis. Anggap ini seperti melatih karyawan untuk prosedur yang sempit, bukan mengajarinya dari nol. Hasil akhirnya berupa adapter beserta bukti evaluasi, bukan tindakan tanpa pengawasan terhadap tiket.
QLoRA menjaga model dasar yang terkuantisasi tetap relatif tidak berubah sambil melatih komponen kecil tambahan yang disebut adapter. Ini bukan pelatihan model fondasi atau fine-tuning seluruh bobot. GPU menjalankan pelatihan; server menyediakan tugas yang terisolasi dan dapat diulang serta menyimpan artefaknya. Jadwalkan beban kerja satu kartu lainnya secara terpisah.
Mulailah dengan resep pelatihan model teks kecil yang didukung, bukan paket inferensi Ollama yang digunakan sebelumnya. Menurut persyaratan Unsloth, model yang didukung dengan sekitar tiga hingga delapan miliar parameter adalah kandidat awal. Urutan pendek dan batch kecil membantu mengendalikan penggunaan memori, tetapi tidak setiap model atau resep akan muat di 16 GB. Coba prompt terlebih dahulu; gunakan retrieval untuk fakta yang sering berubah.
- Proyek awal: Bandingkan model asli, versi dengan prompt yang kuat, dan versi yang telah disesuaikan pada permintaan uji yang sama—contoh yang tidak termasuk dalam pelatihan. Periksa pilihan kategori dan kegagalannya.
- Rangkaian contoh: Rute pelatihan yang didokumentasikan Unsloth menggunakan model teks Qwen2.5-7B-Instruct yang lebih lama dalam resep 4-bit yang kompatibel; contoh dukungan berlabel dan kode evaluasi untuk prediksi kategori.
- Batasan utama: Kualitas data dan evaluasi menentukan apakah adaptasi membantu. Menyelesaikan pelatihan tidak membuktikan adanya peningkatan.
Что нужно проекту помимо GPU
Ah, wait — the target language is Indonesian, not Russian. Correcting that:
Yang dibutuhkan proyek selain GPU
Setelah Anda memiliki proyek dalam pikiran, sesuaikan ukuran server di sekitarnya. Jika VRAM adalah meja kerja, RAM sistem adalah ruang penyimpanan sementara di dekatnya untuk aplikasi dan persiapan data. Pilih kapasitas CPU untuk parsing dan pekerjaan aplikasi pendukung lainnya. Penyimpanan NVMe SSD adalah gudang untuk model dan aset yang sedang aktif.
Penyimpanan yang lebih besar tidak memperbesar memori GPU; memindahkan pekerjaan ke RAM sistem dapat membantu aplikasi yang didukung agar muat, tetapi dengan overhead performa. Periksa persyaratan perangkat keras perangkat lunak pilihan Anda bersama sumber daya ini.
AlexHost mencantumkan konfigurasi single- dan dual-card, termasuk single RTX 4070 Ti SUPER dengan memori GPU 16 GB, RAM 64 GB, dan NVMe 1 TB. Ini adalah salah satu contoh memasangkan kartu tersebut dengan sumber daya untuk aplikasi pendukung.
Ketika beban kerja bertambah, bedakan antara antrean yang lebih panjang dengan pekerjaan yang memang tidak lagi muat. GPU lain dapat menangani pekerjaan independen. Model atau scene yang lebih besar mungkin justru membutuhkan memori per kartu yang lebih besar. Beberapa aplikasi model-serving dapat membagi pekerjaan di beberapa kartu, dengan overhead komunikasi; pekerja independen adalah pengaturan yang lebih sederhana:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Sisakan ruang di luar bobot model untuk konteks dan perhitungan sementara. Resolusi gambar yang lebih tinggi dan permintaan simultan juga dapat meningkatkan kebutuhan memori. Panduan memori Ollama menjelaskan mengapa ukuran unduhan bukan penggunaan memori puncak. Pada satu kartu, pekerjaan yang diantrekan atau jadwal terpisah dapat mencegah model yang saling bersaing menghabiskan memori.
📝 Catatan:Penugasan konseptual, bukan tata letak penyedia yang dijanjikan: dua GPU 16 GB terpisah memberikan total agregat 32 GB, bukan satu alokasi 32 GB otomatis. Pembagian model yang didukung adalah fitur perangkat lunak tersendiri, bukan penggabungan memori otomatis.
Pustaka rekaman membutuhkan penyimpanan dan cadangan, sementara transfer yang sering menjadikan bandwidth bagian dari keputusan sizing. Untuk layanan yang terbuka, gunakan autentikasi dan batasi akses hanya untuk pengguna yang dituju. Pemilik pemeliharaan harus memastikannya tetap diperbarui dan memeriksa jalur pemrosesan eksternal. Pemilik tersebut juga perlu memutuskan berapa lama log dan cadangan disimpan.
Pekerjaan yang berulang dapat membenarkan sumber daya khusus; penggunaan sporadis mungkin lebih cocok dengan API atau sewa sesekali. Timbang upaya mengoperasikan aplikasi terhadap biaya sewa.
Pilih satu proyek pertama yang berguna
Sesuaikan output yang Anda butuhkan dengan proyek kecil yang dapat Anda periksa:
| Tujuan Anda | Proyek awal | Kendala utama |
|---|---|---|
| 📚 Jawaban dari dokumen internal | Satu koleksi onboarding yang dikurasi | Kualitas pencarian dan izin akses |
| 🎨 Konsep gambar kampanye | Variasi dari satu foto produk milik sendiri | Akurasi produk dan hak cipta |
| 🎙️Rekaman yang mudah dibaca dan dicari | Transkrip dan subtitle yang telah ditinjau | Kualitas audio dan koreksi |
| 💻 Bantuan di dalam editor Anda | Draf pengujian untuk satu modul | Konteks dan peninjauan kode |
| 🧾 Catatan faktur terstruktur | Satu keluarga faktur ke dalam spreadsheet tinjauan | Validasi kolom dan persetujuan |
| 🎬 Video siap distribusi | Satu rekaman dalam dua resolusi | Dukungan codec dan kapasitas pipeline |
| 🧊 Visual 3D yang sudah jadi | Satu tugas render produk kecil | Memori scene dan transfer aset |
| 🧠 Perilaku model yang konsisten—lanjutan | Adapter untuk kategori dukungan | Data pelatihan dan evaluasi held-out |
Bagi tim yang memiliki dokumen, asisten pengetahuan menawarkan titik awal yang mudah didekati. Kreator visual dapat mulai dengan penyuntingan gambar, sementara orang yang memiliki pustaka rekaman dapat mulai dengan transkripsi. Pilih satu hasil kerja menggunakan input yang Anda miliki atau yang Anda punya izin untuk menggunakannya. Buat keberhasilan menjadi konkret: jawaban yang didukung oleh bagian yang tepat, atau subtitle yang sesuai dengan rekaman.
Jika hosting jarak jauh sesuai dengan pilihan Anda, layanan server GPU AlexHost menyediakan konfigurasi yang dapat Anda bandingkan dengan proyek yang telah Anda pilih. Kemudian bangun versi terkecil yang menghasilkan hasil yang berguna. Target pertama Anda adalah output jadi yang dapat Anda gunakan—bukan server penuh dengan aplikasi yang setengah jadi.