Відкритий квиток
 +373 79 600002
 Telegram Онлайн-чат
 Часті запитання
 Українська
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 български
 Polski
 Indonesia
 中文 (中国)


 на всіх хостингових послугах


Найкращі сценарії використання сервера з RTX 4070 Ti SUPER у 2026 році
Ваші документи для онбордингу можуть перетворитися на відповіді з посиланнями на джерела. Власне фото продукту може стати концептами фонів для кампаній. Наявна 3D-сцена може стати готовими візуалізаціями продукту — і все це без необхідності тримати ноутбук зайнятим. Це три практичні сценарії використання сервера з RTX 4070 Ti SUPER: конкретні завдання з передбачуваними результатами.
Вісім варіантів нижче є альтернативами, а не застосунками, які слід запускати разом. Тут «найкращий» означає корисні результати з реалістичним програмним шляхом, а не рейтинг за бенчмарками. Компактні моделі для роботи із зображеннями та текстом і робочі процеси редагування розширюють можливості у 2026 році; кодування та рендеринг також залишаються корисними. Оберіть один сфокусований сервіс або чергового воркера, який може працювати незалежно від вашого ноутбука.
Полезна межа: 16 ГБ швидкого робочого простору
RTX 4070 Ti SUPER має 16 ГБ VRAM — робочу пам’ять графічного процесора. Це його робочий стіл для моделей і сцен, тому наведені нижче проєкти використовують менші моделі та обмежені завдання. Сумісне програмне забезпечення NVIDIA обробляє ШІ та рендеринг, а спеціалізоване апаратне кодування відео підтримує роботу з медіа. Це відправні точки, підтверджені документацією, а не бенчмарки для розгортання. Кожна з них передбачає одну відповідно налаштовану карту.
1. Задавайте запитання своїм документам, а не всьому інтернету
Новий колега питає, який контрольний список адаптації стосується його ролі. Замість того щоб шукати по папках, він отримує чернетку відповіді з посиланнями на затверджені файли адаптації або інструкції з експлуатації. Оскільки модель розгорнута на віддаленому сервері з контрольованим доступом команди, це може стати приватним сервісом знань.
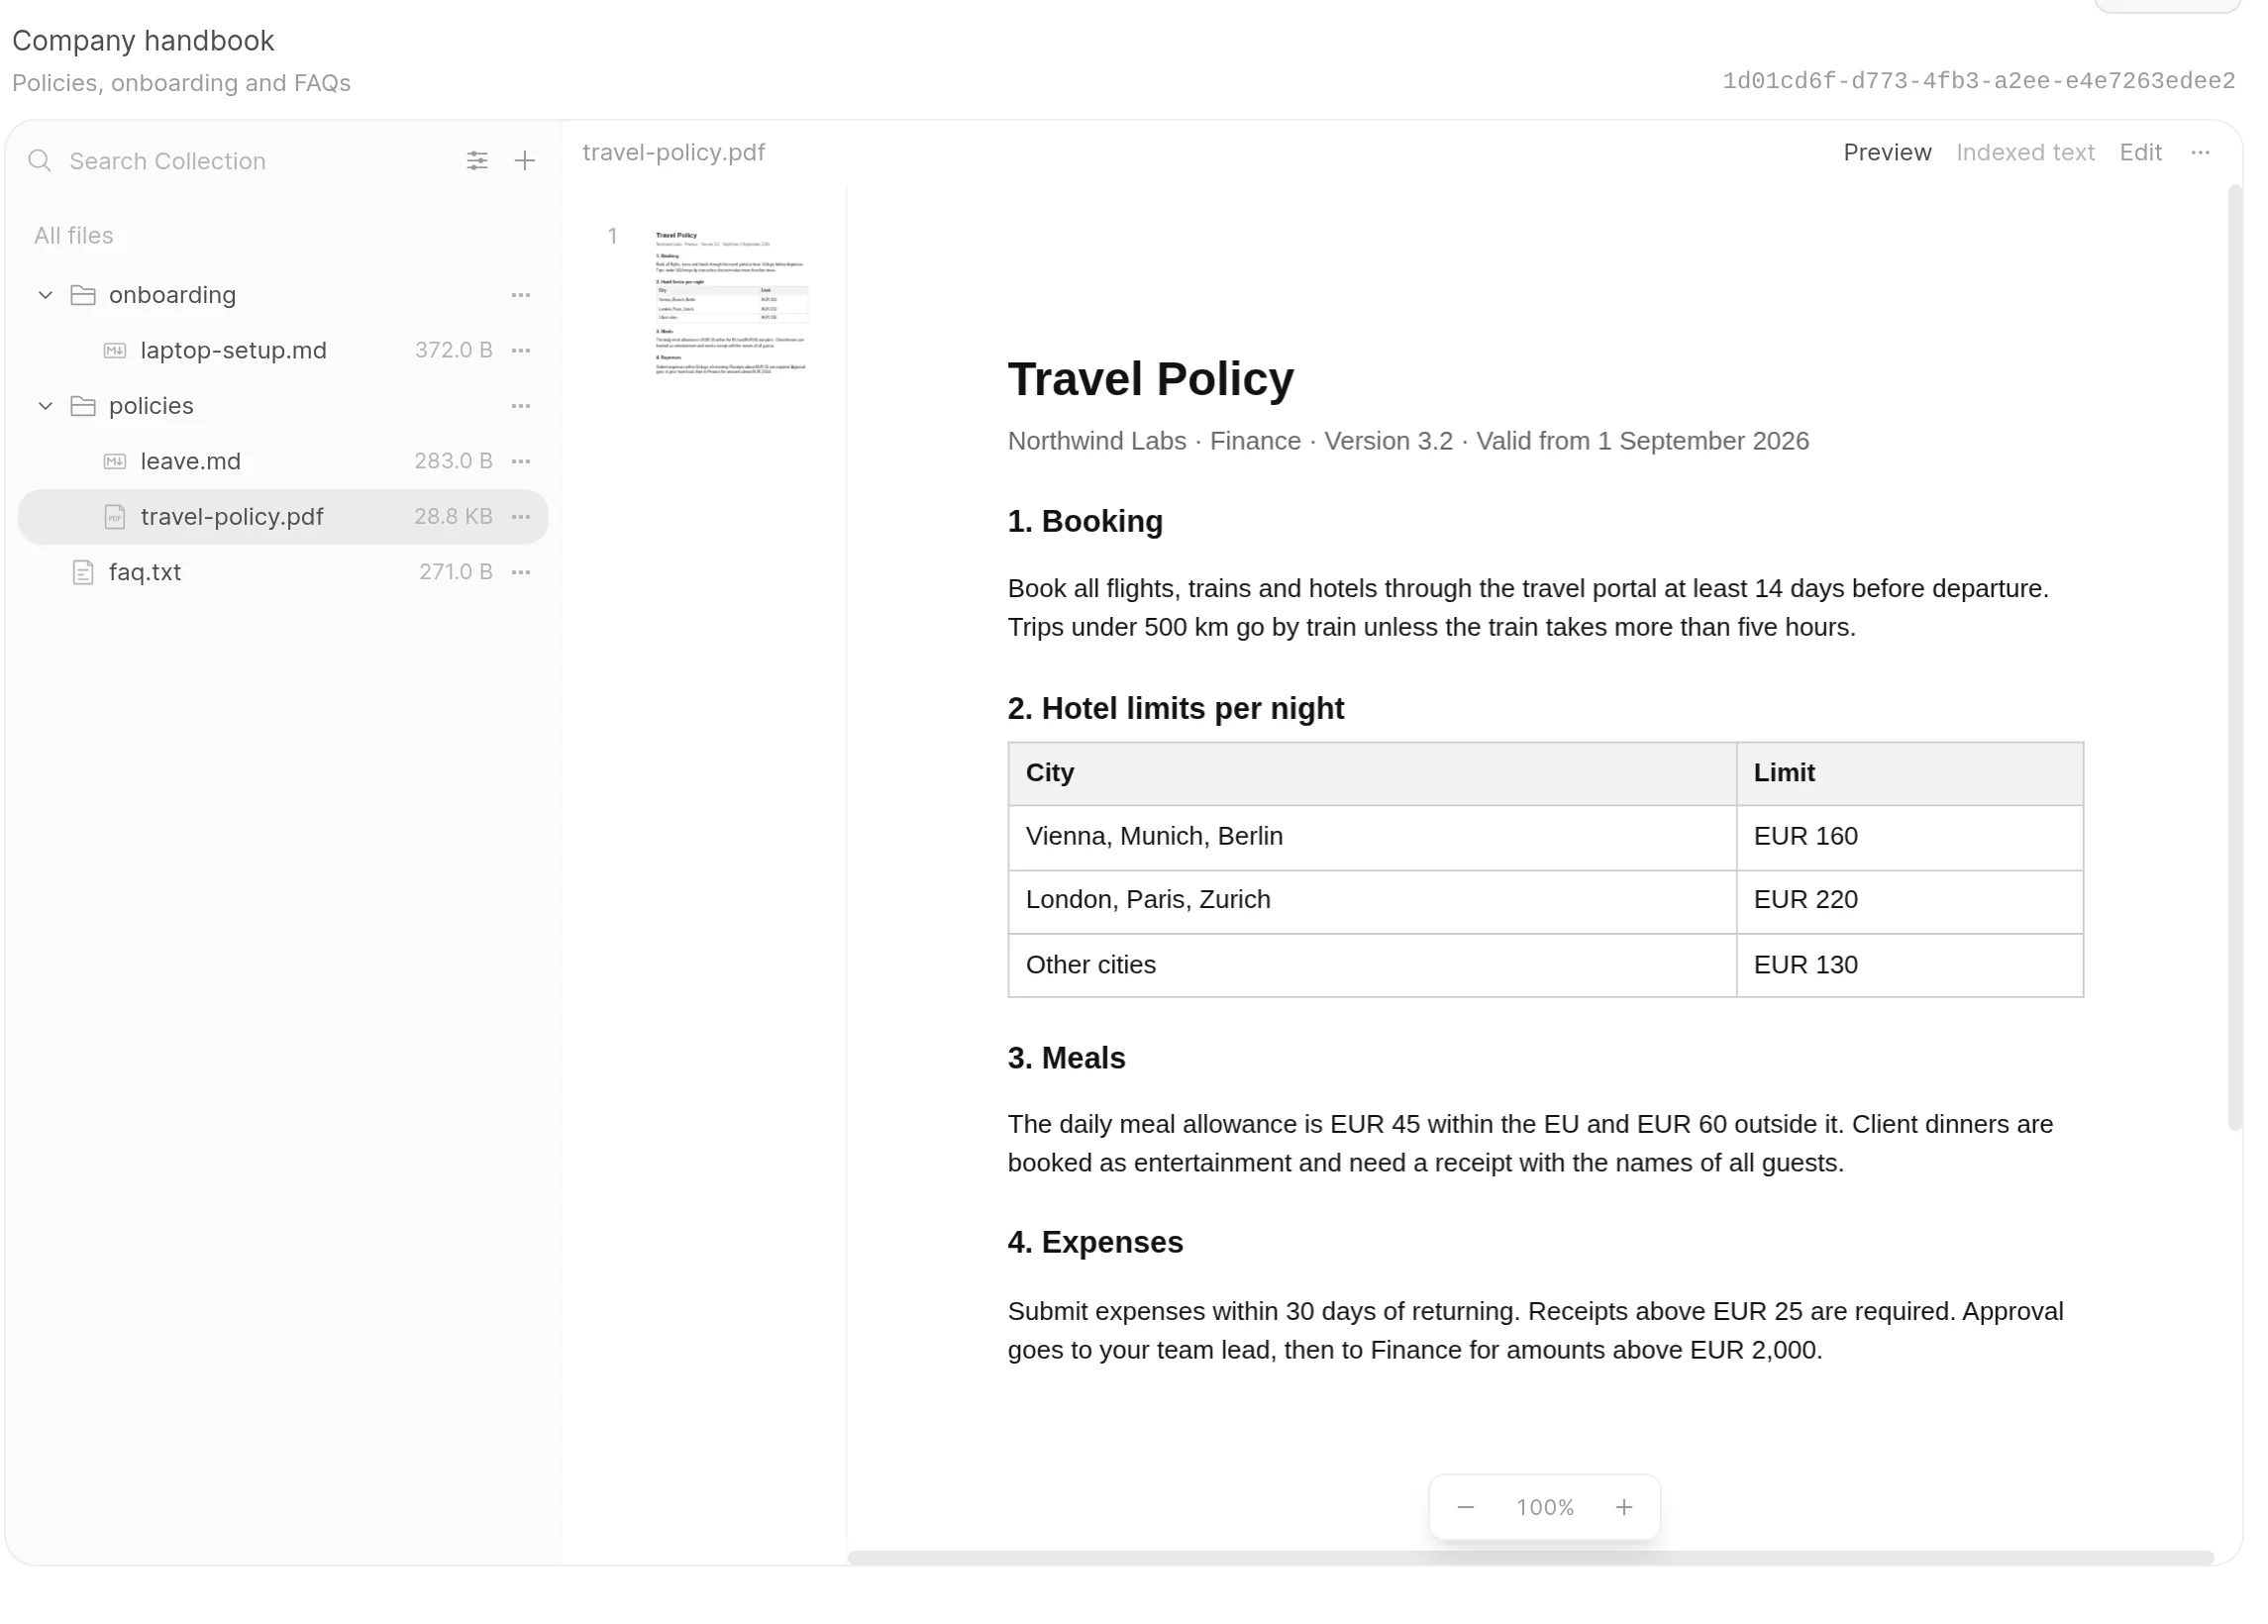
Retrieval-augmented generation, або RAG, працює як асистент з відкритою книгою: програмне забезпечення знаходить відповідні фрагменти та передає їх моделі до того, як вона відповість. Embeddings дозволяють шукати фрагменти за змістом, а не лише за точним формулюванням. Завантаження документів не перенавчає модель; відповідь залежить від матеріалів, отриманих для конкретного запитання.
📝 Примітка: Приватний inference означає, що модель працює на віддаленому сервері, а не що кожен компонент є приватним. Перевірте, де виконуються embeddings та парсинг документів. Логи та зовнішні резервні варіанти також потребують перегляду. Віддаленим хостингом залишається довірчі відносини з провайдером.
GPU передусім прискорює inference: використання вже навченої моделі для генерації відповіді. Квантизована модель зберігає числа з меншою кількістю біт, економлячи пам’ять із можливими компромісами якості. Запитання та отримані фрагменти становлять частину її контексту — інформації, яку модель утримує в полі зору для запиту. Співставлення фрагментів може використовувати невеликий самохостинговий компонент; зберігання та пошук файлів не обов’язково потребують іншого великого GPU-сервісу.
- Стартовий проєкт: Одна колекція матеріалів адаптації та запитання з відомими відповідями. Перевіряйте відповіді за цитованими фрагментами; додайте запитання без відповіді, щоб побачити, чи асистент визнає відсутність інформації.
- Приклад стеку: Open WebUI для документів і пошуку; самохостингові embeddings для співставлення фрагментів; Ollama, що запускає квантизовану Qwen3.5-4B для серверних відповідей.
- Основне обмеження: Якість пошуку та дозволи визначають, що потрапляє до моделі. Цитати допомагають перевіряти відповіді; вони не гарантують їх істинність.
2. Дайте команді власну студію генерації та редагування зображень
Невелика крамниця володіє фото продукту й потребує концептів фонів для кампанії: студійний задник, сезонна обстановка, інша колірна палітра. Результатом стане набір чернеток, які хтось зможе вибрати й доопрацювати — це реалістичніша перша мета, ніж заміна фотografії продукту.
Візуальний робочий процес з’єднує станції обробки, звані вузлами, які завантажують еталонне зображення, застосовують інструкції та зберігають результати. GPU запускає модель зображень, щоб перетворити фото та промпт на варіацію. Збереження цього робочого процесу дає команді повторювану відправну точку для наступного набору концептів.
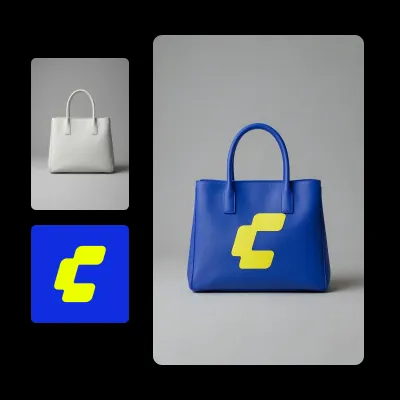
Члени команди можуть надсилати завдання до спільної серверної черги замість того, щоб відтворювати налаштування на окремих настільних комп’ютерах. Запропонована модель FLUX.2 [klein] 4B використовує ліцензію Apache-2.0, яка дозволяє комерційне використання на її умовах. Ця ліцензія стосується саме цього варіанта, а не всіх моделей FLUX; права на зображення все одно мають значення.
- Стартовий проєкт: Створіть кілька варіацій фону для одного належного вам зображення продукту. Перед використанням порівняйте форму, текст на упаковці, логотипи та відповідність бренду з оригіналом.
- Приклад стеку: ComfyUI для збереженого візуального робочого процесу та черги завдань; розподілений FLUX.2 [klein] 4B для генерації та редагування за еталонним зображенням на GPU.
- Основне обмеження: Переконливе зображення все ще може змінити продукт або його текст. Ставтеся до результатів як до концептів, що потребують перевірки точності та прав.
3. Перетворіть записи на транскрипти, субтитри та пошукові знання
Ваш вебінар або зустріч, записані за наявності відповідної згоди, можуть містити інформацію, яку потім важко знайти. Робочий процес транскрибування перетворює її на текст із позначками часу та файли субтитрів. Упорядковуйте перевірені транскрипти, і звичайний текстовий пошук допоможе знайти тему без повторного прослуховування кожного запису.

Модель розпізнавання мовлення спочатку створює сегменти транскрипту з позначками часу. Обгортка для експорту, тобто прикладний код навколо бібліотеки розпізнавання, потім зберігає їх у вигляді зручного для читання тексту та файлів субтитрів SRT або VTT. Ці позначки часу пов’язують слова із записом і передають експортеру субтитрів інформацію про синхронізацію.
Папка завантаження або черга дозволяють серверу без участі людини опрацьовувати backlog записів, а GPU виконує розпізнавання мовлення. Необов’язкові підсумки потребують іншої моделі, бажано запланованої окремо на тій самій карті. Мітки мовців потребують окремого етапу для розрізнення мовців; сама транскрибація їх не забезпечує.
- Стартовий проєкт: Обробіть кілька записів, для яких є дозвіл, у транскрипти та субтитри. Порівнюйте зразки із аудіо, перевіряючи імена, технічну термінологію та синхронізацію субтитрів.
- Приклад стеку: faster-whisper з large-v3 і відповідними налаштуваннями GPU зі зниженою точністю; черга завантаження; обгортка експорту для файлів субтитрів і зберігання транскриптів для пошуку.
- Основне обмеження: Якість аудіо визначає обсяг коригування. Шум, акценти, незнайомі терміни та мовці, які говорять одночасно, можуть залишати помилки, що потребують перевірки людиною.
4. Підключіть приватного помічника з кодування до вашого редактора
Виділіть функцію у вашому редакторі та попросіть створити тести, пояснення або невеликий рефакторинг. Ви отримаєте чернетку коду поруч із функцією, над якою працюєте. Ваш редактор і робочі файли можуть залишатися на ноутбуці, тоді як виділений код надсилається на сервер для інференсу.
Редактор надсилає виділений код і ваше запитання на віддалену кінцеву точку моделі, а потім відображає відповідь у робочому середовищі розробки. Додавання очікуваної поведінки функції допомагає зробити запит конкретним. Для завдання написання тестів результат дає вам чернетку, яку можна порівняти з цією поведінкою, а не порожній файл тестів.
GPU виконує генерацію відповідей, а сервер надає багаторазову кінцеву точку для запитів із редактора. Залишайте виконання та ризиковані зміни під своїм контролем, із обмеженими дозволами. Чат у редакторі — це початковий робочий процес; швидке вбудоване автодоповнення має інші вимоги до моделі та затримки.
- Стартовий проєкт: Створіть чернетки тестів для одного модуля. Перевірте їх, запустіть у контрольованому середовищі розробки та перевірте очікувану поведінку, а не лише те, чи компілюються вони.
- Приклад стека: Продовжуйте використовувати чат у редакторі та запропоновані зміни; контрольована кінцева точка Ollama на сервері з квантованою Qwen3.5-4B для генерації відповідей.
- Основне обмеження: Якість малої моделі, обмежений контекст коду та затримка мережі обмежують допомогу. Це не заміна найбільших комерційних систем для кодування.
5. Преобразование рахунків і сканів у структуровані записи
Зображення рахунків можна перетворити на запропоновані поля постачальника, дати, номера рахунку та загальної суми в таблиці для перевірки. Прив’язка кожного рядка до вихідного документа спрощує порівняння. Практична користь полягає в узгодженому наборі записів, які хтось може перевірити і передати в наступний бізнес-процес.

Модель vision-language приймає як зображення, так і текст. Підготуйте по одному зображенню сторінки за раз, а потім запитуйте потрібні поля. Це дозволяє використовувати GPU для візуальної інтерпретації, а не припускати, що модель здатна розібрати будь-який тип PDF. Чисті PDF з текстовим шаром можуть потребувати лише звичайного парсингу без використання GPU.
Після вилучення звичайний код застосунку перевіряє, чи присутні обов’язкові значення, і чи дати та числа мають очікуваний формат. За можливості він також перевіряє арифметику та шукає дублікати ідентифікаторів рахунків. Відсутні або сумнівні поля залишаються позначеними. Сервер зводить результати пакета та їх джерела разом для передачі на перевірку:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Вилучені поля є лише пропозиціями, доки не завершено звичайні перевірки та перегляд людиною; лише після цього їх можна зберігати як затверджені записи.
- Стартовий проєкт: Перетворіть одну групу рахунків на таблицю для перевірки з посиланнями на джерела. Порівняйте кожне вибране поле з оригіналом перед прийняттям рядка.
- Приклад стеку: Підготовка зображень сторінок; Ollama з Qwen3.5-4B для візуального вилучення; звичайний код валідації/експорту та крок перевірки для створення затверджених записів у таблиці з посиланнями на джерела.
- Основне обмеження: Правдоподібні значення можуть бути помилковими. Вимагайте людського схвалення перед бухгалтерським обліком або оплатою.
6. Підготовка завантаженого відео для різних глядачів
Урок або демонстрація продукту може потребувати кількох версій для доставки, а не нової зйомки. Транскодування перетворює вже закодоване відео. Придатний майстер-файл можна перетворити на копії 1080p і 720p для різних екранів і з’єднань. Зменшення роздільної здатності може полегшити доставку; збільшення не відновить втрачені деталі.
NVENC — це спеціалізований відеокодувальник від NVIDIA, окремий від обчислень мовних моделей. Кодек — це технологія, що використовується для кодування та декодування відео. H.264 є широко сумісним початковим вибором; AV1 — інший варіант, коли цільові пристрої відтворення його підтримують. Декодування та масштабування можуть залучати інше апаратне забезпечення GPU або CPU.
Сервер може застосовувати однакові параметри конвертації до черги завантажень і зберігати копії для доставки окремо від майстер-файлу. Апаратні медіаблоки обробляють підтримуване кодування, але параметри все одно впливають на результат. Обирайте апаратне кодування для пропускної здатності, а не для гарантованого покращення якості порівняно з кодуванням на CPU.
- Стартовий проєкт: Перетворіть один ваш власний запис на версії 1080p і 720p. Перевірте відтворення на цільових пристроях, синхронізацію звуку, читабельність вмісту та розмір файлів.
- Приклад стека: FFmpeg для конвертації з кодуванням, підтримуваним NVIDIA; проста черга завантажень для планування завдань і сховище для вихідних файлів і готових версій для доставки.
- Основне обмеження: Продуктивність залежить від кодеків, параметрів, обмежень сесій драйвера, активності диска та пропускної здатності передачі — а не лише від пам’яті GPU.
7. Надсилайте рендери Blender на віддалений GPU-воркер
Дизайнер продуктів може продовжувати моделювання локально, поки сервер створює фінальні зображення або кадри для обертання об’єкта (turntable). Рендеринг означає обчислення фінальних зображень з наявної 3D-сцени, а не створення зображення з текстового запиту. Ви надаєте сцену, матеріали, освітлення та камеру, а воркер обчислює готові зображення.
Бекенд рендерингу пов’язує обчислення сцени з апаратним прискоренням RTX. Можна запускати фоновий рендеринг без інтерактивного віддаленого робочого столу, і підготовлене завдання створюватиме вихідні файли на сервері. GPU-рендеринг потрібно вибирати окремо; самого фонового режиму недостатньо, щоб обрати пристрій для рендерингу.
Для передачі потрібні сумісні функції Blender та всі необхідні ресурси: упакуйте текстури разом із проєктом або переконайтеся, що їхні шляхи коректно визначаються на сервері. Час на завантаження та підготовку може перевищити вигоду для дуже малих завдань. Підтримуваний резервний режим пам’яті може допомогти великим сценам вміститися, але з компромісом у продуктивності.
- Стартовий проєкт: Відрендеріть одну помірну сцену продукту у фінальні зображення або короткий кадр обертання. Перевірте текстури, матеріали, освітлення та кадрування на репрезентативному кадрі, перш ніж ставити в чергу все інше.
- Приклад стеку: Blender Cycles для рендерингу сцен; NVIDIA OptiX для GPU-прискорення; фонове виконання для створення вихідних файлів без потреби в інтерактивному віддаленому робочому столі.
- Основне обмеження: Розмір сцени та текстур визначає, чи вона поміститься. Кілька карт, як правило, не об’єднують пам’ять сцени на цьому обладнанні.
8. Адаптація невеликої моделі до одного повторюваного завдання
Просунутий рівень. Можна адаптувати невелику модель для класифікації запитів у службу підтримки за існуючими категоріями: оплата, доступ до облікового запису або технічні проблеми. Думайте про це як про навчання співробітника вузькій процедурі, а не про навчання з нуля. Результатом є адаптер і докази оцінки якості, а не автоматичні дії з тікетами без нагляду.
QLoRA зберігає квантовану базову модель здебільшого незмінною, навчаючи невеликі додані компоненти, які називаються адаптерами. Це не навчання фундаментальної моделі та не повне донавчання всіх ваг. GPU виконує навчання, а сервер забезпечує ізольоване, повторюване завдання та зберігає його артефакти. Заплануйте інші навантаження на одній карті окремо.
Почніть із підтримуваного рецепту навчання невеликої текстової моделі, а не з раніше згаданого пакета для інференсу Ollama. Згідно з вимогами Unsloth, підтримувані моделі приблизно від трьох до восьми мільярдів параметрів є початковими кандидатами. Короткі послідовності та невеликі батчі допомагають контролювати використання пам’яті, але не кожна модель або рецепт помістяться в 16 ГБ. Спочатку спробуйте промпти; для змінних фактів використовуйте пошук із доповненням (retrieval).
- Стартовий проєкт: Порівняйте вихідну модель, версію з покращеним промптом і адаптовану версію на тих самих відкладених запитах, яких не було в навчальних прикладах. Перевірте вибір категорій і помилки.
- Приклад стеку: Задокументований маршрут навчання Unsloth із використанням старішої текстової моделі Qwen2.5-7B-Instruct у сумісному рецепті 4-bit; розмічені приклади звернень у підтримку та код оцінки прогнозів категорій.
- Головне обмеження: Якість даних і оцінка визначають, чи допомогла адаптація. Завершення навчання не доводить покращення.
Что нужно проекту помимо GPU
Когда у вас есть проект, подберите окружающий сервер. Если VRAM — это рабочий стол, то системная RAM — соседнее место для подготовки приложения и данных. Выбирайте мощность CPU для парсинга и другой сопутствующей работы приложения. NVMe SSD — это склад для активных моделей и ресурсов.
Больше места на диске не увеличивает память GPU; перенос работы в системную RAM может помочь поддерживаемым приложениям уместиться, но с накладными расходами на производительность. Проверьте требования к оборудованию выбранного ПО вместе с этими ресурсами.
AlexHost предлагает конфигурации с одной и двумя картами, включая одну RTX 4070 Ti SUPER с 16 GB памяти GPU, 64 GB RAM и 1 TB NVMe. Это один из примеров сочетания карты с ресурсами для окружающего приложения.
Когда нагрузка растет, отличайте более длинную очередь от задачи, которая больше не помещается. Другая GPU может обрабатывать независимые задания. Более крупной модели или сцене может понадобиться больше памяти на каждую карту. Некоторые приложения для обслуживания моделей могут распределять задачу между картами, с накладными расходами на коммуникацию; независимые воркеры — более простой вариант:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Оставляйте запас памяти сверх весов модели для контекста и временных вычислений. Более высокое разрешение изображений и одновременные запросы также могут увеличить потребность в памяти. В руководстве Ollama по памяти объясняется, почему размер загрузки не равен пиковому использованию памяти. На одной карте очереди заданий или отдельные расписания могут не дать конкурирующим моделям исчерпать память.
📝 Примечание:Концептуальные назначения, а не обещанная схема провайдера: две отдельные GPU по 16 GB дают суммарно 32 GB, а не автоматическое выделение 32 GB. Разделение модели между картами — отдельная функция ПО, а не автоматическое объединение памяти.
Библиотекам записей нужны хранилище и резервные копии, а частые передачи делают пропускную способность частью решения о мощности. Для открытого сервиса используйте аутентификацию и ограничивайте доступ предназначенными пользователями. Ответственный за обслуживание должен обновлять его и проверять внешние пути обработки. Этот ответственный также должен решить, как долго хранить логи и резервные копии.
Регулярная работа может оправдать выделенные ресурсы; эпизодическое использование может лучше подойти API или разовой аренде. Сопоставьте трудозатраты на эксплуатацию приложения со стоимостью аренды.
Оберіть один корисний перший проєкт
Підберіть результат, який вам потрібен, до невеликого проєкту, який можна перевірити:
| Ваша мета | Стартовий проєкт | Основне обмеження |
|---|---|---|
| 📚 Відповіді з внутрішніх документів | Одна відібрана колекція для онбордингу | Якість пошуку та дозволи доступу |
| 🎨 Концепції зображень для кампанії | Варіації однієї власної фотографії продукту | Точність продукту та права |
| 🎙️Зрозумілі та доступні для пошуку записи | Перевірена транскрипція та субтитри | Якість аудіо та виправлення |
| 💻 Допомога всередині вашого редактора | Чернеткові тести для одного модуля | Контекст і перевірка коду |
| 🧾 Структуровані записи рахунків-фактур | Одна родина рахунків-фактур у таблиці для перевірки | Валідація полів і затвердження |
| 🎬 Відео, готове до доставки | Один запис у двох роздільних здатностях | Підтримка кодеків і потужність конвеєра |
| 🧊 Готові 3D-візуалізації | Невелике завдання з рендерингу продукту | Обсяг пам’яті сцени та передача ресурсів |
| 🧠 Стабільна поведінка моделі—просунутий рівень | Адаптер для категорій підтримки | Навчальні дані та оцінка на відкладеній вибірці |
Для команд із документами базовельний помічник на основі знань є доступною відправною точкою. Візуальні креатори можуть почати з редагування зображень, а люди з бібліотеками записів — з транскрибування. Оберіть один результат, використовуючи вхідні дані, якими ви володієте або на використання яких маєте дозвіл. Зробіть успіх конкретним: відповідь, підкріплена потрібними фрагментами, або субтитри, які відповідають запису.
Якщо для вашого вибору підходить віддалений хостинг, GPU-сервери AlexHost дають конфігурації, які можна порівняти з обраним вами проєктом. Потім створіть найменшу версію, яка дає корисний результат. Ваша перша мета — готовий результат, який можна використовувати, а не сервер, заповнений напівзавершеними застосунками.