Открыть тикет
 +373 79 600002
 Телеграм-чат в реальном времени
 Часто задаваемые вопросы
 Русский
 English
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)


 на всех хостинговых услугах


Лучшие сценарии использования сервера с RTX 4070 Ti SUPER в 2026 году
Ваши учебные документы могут превращаться в ответы со ссылками на источники. Собственное фото продукта может становиться концепциями фонов для кампаний. Существующая 3D-сцена может превращаться в готовые визуалы продукта, и всё это без необходимости держать ноутбук занятым. Это три практичных сценария использования сервера с RTX 4070 Ti SUPER: сфокусированные задачи с понятными результатами.
Восемь вариантов ниже являются альтернативами, а не приложениями, которые нужно загружать вместе. Здесь под словом «лучший» понимаются полезные результаты при реалистичном программном пути, а не рейтинг по бенчмаркам. Компактные модели для работы с изображениями и текстом и рабочие процессы редактирования расширяют набор возможностей в 2026 году; кодирование и рендеринг также остаются полезными. Выберите один сфокусированный сервис или очередь задач, которая может работать независимо от вашего ноутбука.
Полезная граница: 16 ГБ быстрого рабочего пространства
RTX 4070 Ti SUPER имеет 16 ГБ VRAM — рабочую память графического процессора. Это его рабочий стол для моделей и сцен, поэтому проекты ниже используют модели меньшего размера и ограниченные задачи. Совместимое программное обеспечение NVIDIA обрабатывает задачи ИИ и рендеринга, а выделенное аппаратное обеспечение для кодирования видео поддерживает работу с медиа. Это отправные точки, основанные на документации, а не результаты тестов развертывания. Каждый вариант предполагает одну соответствующим образом настроенную карту.
1. Задавайте вопросы своим документам, а не всему интернету
Новый коллега спрашивает, какой чеклist онбординга подходит для его роли. Вместо поиска по папкам он получает черновик ответа со ссылками на утверждённые файлы онбординга или руководства по эксплуатации. Если модель размещена удалённо на собственном сервере и доступ команды контролируется, это может превратиться в закрытый сервис знаний.
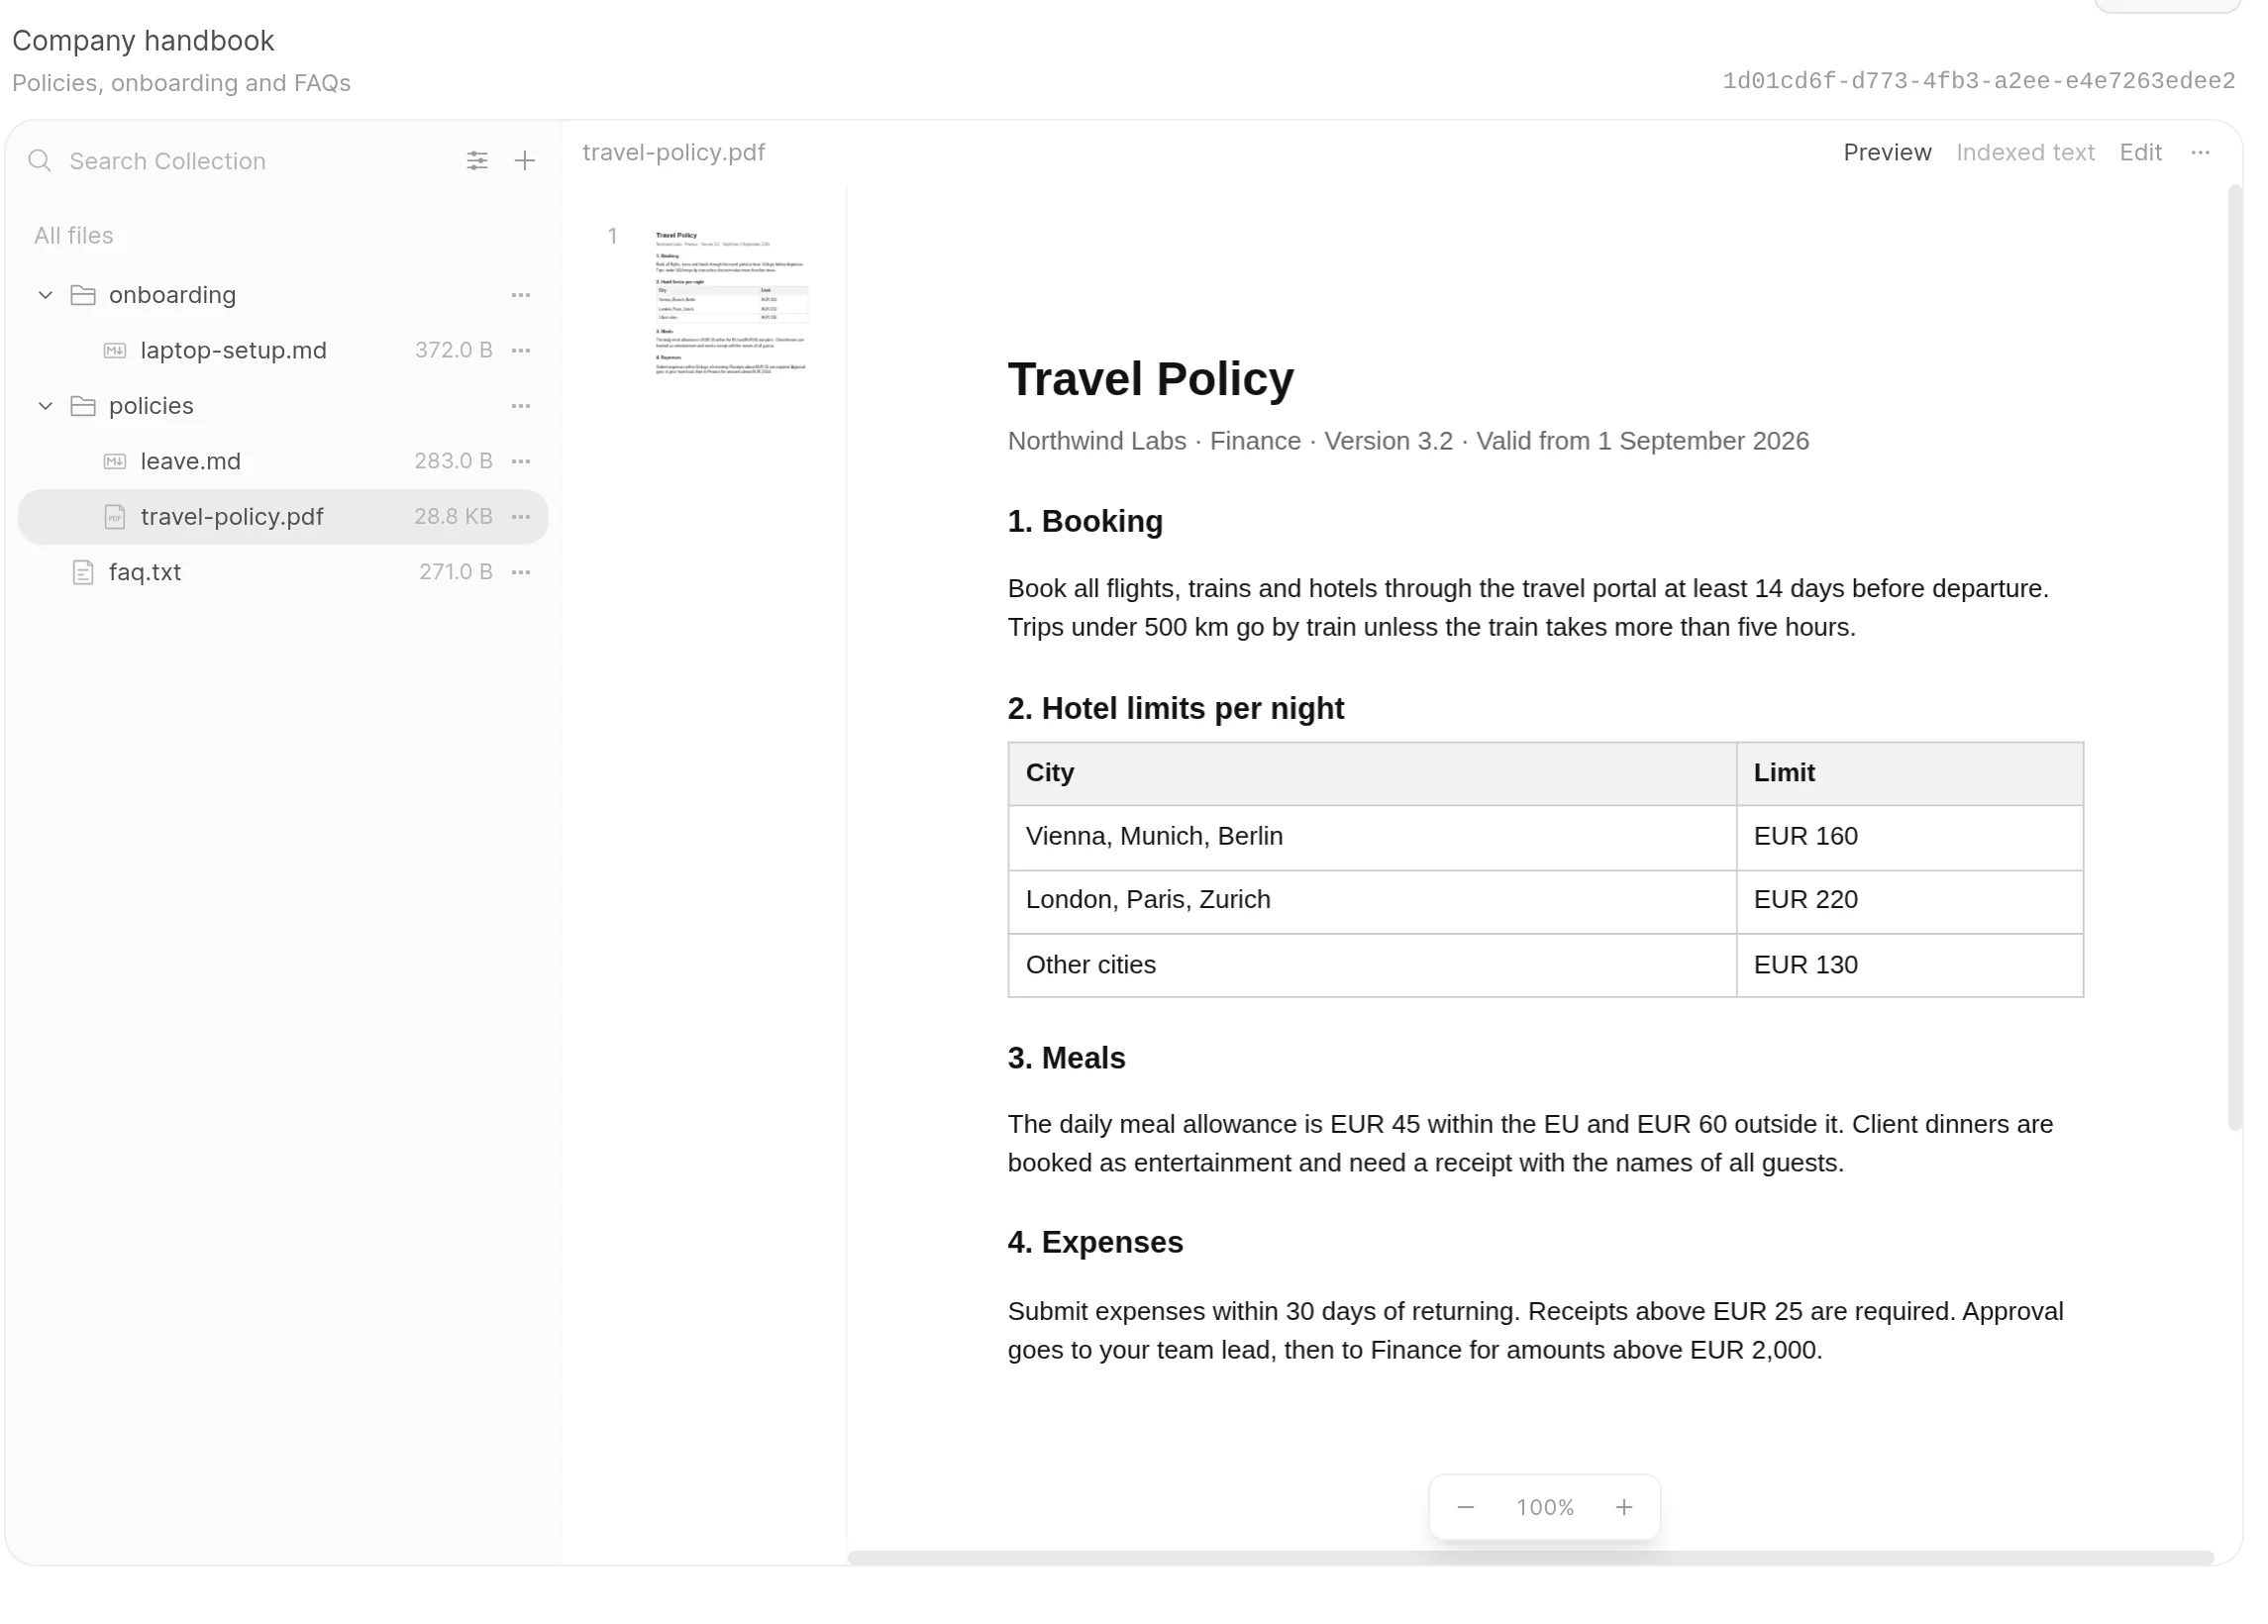
Retrieval-augmented generation, или RAG, работает как ассистент с открытой книгой: программа находит релевантные фрагменты и передаёт их модели до того, как она даст ответ. Эмбеддинги делают фрагменты доступными для поиска по смыслу, а не только по точному совпадению слов. Загрузка документов не переобучает модель; ответ зависит от материалов, найденных для конкретного вопроса.
📝 Примечание: Приватный инференс означает, что модель работает на удалённом сервере, но это не значит, что каждый компонент является приватным. Проверьте, где выполняются эмбеддинги и парсинг документов. Логи и внешние резервные варианты также требуют проверки. Удалённый хостинг остаётся доверительными отношениями с провайдером.
GPU в основном ускоряет инференс: использование уже обученной модели для генерации ответа. Квантизированная модель хранит свои числа с меньшим количеством бит, что экономит память, но может снизить качество. Вопрос и найденные фрагменты составляют часть её контекста — информации, которую она удерживает в поле зрения для запроса. Сопоставление фрагментов может использовать небольшой собственный компонент; хранение и поиск файлов не обязательно требуют отдельного крупного GPU-сервиса.
- Стартовый проект: Одна коллекция материалов онбординга и вопросы с известными ответами. Сверяйте ответы с процитированными фрагментами; добавьте вопрос без ответа, чтобы проверить, признаёт ли ассистент отсутствие информации.
- Пример стека: Open WebUI для документов и поиска; собственные эмбеддинги для сопоставления фрагментов; Ollama, запускающая квантизированную Qwen3.5-4B для ответов на сервере.
- Главное ограничение: Качество поиска и права доступа определяют, что попадает в модель. Цитаты помогают проверять ответы, но не гарантируют их истинность.
2. Дайте команде собственную студию генерации и редактирования изображений
Небольшой магазин владеет фотографией товара и нуждается в концептах фонов для кампании: студийный фон, сезонная обстановка, другая цветовая палитра. Результатом становится набор черновиков, из которых кто-то выбирает и дорабатывает лучшие варианты — это более реалистичная первая цель, чем замена фотографий товаров.
Визуальный рабочий процесс связывает обрабатывающие станции, называемые узлами, которые загружают эталонное изображение, применяют инструкции и сохраняют результаты. GPU запускает модель генерации изображений, чтобы превратить фото и промпт в вариацию. Сохранение этого рабочего процесса даёт команде повторяемую отправную точку для следующего набора концептов.
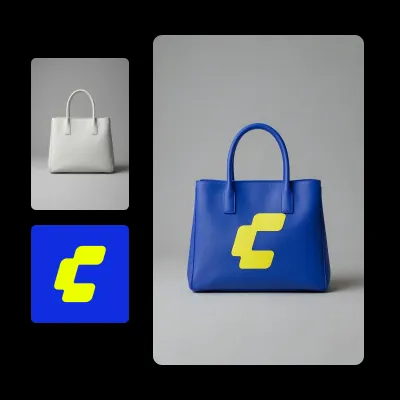
Члены команды могут отправлять задания в общую серверную очередь вместо того, чтобы заново настраивать среду на отдельных компьютерах. Предлагаемая модель FLUX.2 [klein] 4B распространяется по лицензии Apache-2.0, которая допускает коммерческое использование на её условиях. Эта лицензия относится к данному варианту, а не ко всем моделям FLUX; права на изображения по-прежнему имеют значение.
- Стартовый проект: Создайте несколько вариантов фона для одного принадлежащего вам изображения товара. Перед использованием сравните форму, текст на упаковке, логотипы и соответствие бренду с оригиналом.
- Пример стека: ComfyUI для сохранённого визуального рабочего процесса и очереди заданий; дистиллированная FLUX.2 [klein] 4B для генерации и редактирования по эталонному изображению на GPU.
- Основное ограничение: Убедительное изображение всё равно может изменить товар или его текст. Относитесь к результатам как к концептам, требующим проверки точности и прав.
3. Превращайте записи в транскрипты, субтитры и доступные для поиска знания
Ваш вебинар или встреча, записанная с соответствующего согласия, может содержать информацию, которую потом трудно найти. Рабочий процесс транскрибирования превращает её в текст с временными метками и файлы субтитров. Упорядочивайте проверенные транскрипты, и обычный текстовый поиск поможет найти нужную тему без повторного прослушивания каждой записи.

Модель распознавания речи сначала создаёт сегменты транскрипта с временными метками. Экспортная оболочка — прикладной код вокруг библиотеки распознавания — затем сохраняет их как читаемый текст и файлы субтитров SRT или VTT. Эти временные метки связывают слова с записью и передают экспортёру субтитров информацию о тайминге.
Папка загрузки или очередь позволяет серверу без присмотра обрабатывать накопившиеся записи, при этом распознаванием речи занимается GPU. Необязательные сводки требуют другой модели, желательно запускаемой отдельно на той же карте. Метки спикеров требуют отдельного этапа для различения говорящих; одной только транскрипции для этого недостаточно.
- Стартовый проект: Обработайте несколько записей, на обработку которых получено разрешение, в транскрипты и субтитры. Сверяйте образцы с аудио, проверяя имена, технический словарь и тайминг субтитров.
- Пример стека: faster-whisper с large-v3 и подходящими настройками GPU с пониженной точностью; очередь загрузки; экспортная оболочка для файлов субтитров и хранения транскриптов с возможностью поиска.
- Основное ограничение: Качество аудио определяет объём работы по исправлению. Шум, акценты, незнакомые термины и перекрывающиеся голоса могут оставлять ошибки, которые требуют проверки человеком.
4. Подключите приватного помощника по программированию к вашему редактору
Выделите функцию в редакторе и попросите написать тесты, объяснение или небольшой рефакторинг. Вы получите черновой код рядом с функцией, над которой работаете. Ваш редактор и рабочие файлы могут оставаться на ноутбуке, а выделенный код отправляется на сервер для инференса.
Редактор отправляет выделенный код и ваш вопрос на удалённую конечную точку модели, а затем отображает ответ в рабочей среде разработки. Указание предполагаемого поведения функции помогает сделать запрос конкретным. Для задачи написания тестов результат даёт вам черновик, который можно сравнить с этим поведением, а не пустой файл тестов.
GPU отвечает за генерацию ответов, а сервер предоставляет многократно используемую конечную точку для запросов из редактора. Выполнение кода и рискованные правки оставляйте под своим контролем, с ограниченными правами доступа. Чат в редакторе — это отправная точка для данного сценария; отзывчивое встроенное автодополнение имеет другие требования к модели и задержке.
- Стартовый проект: Составьте черновики тестов для одного модуля. Проверьте их, запустите в контролируемой среде разработки и убедитесь, что они соответствуют предполагаемому поведению, а не только тому, что они компилируются.
- Пример стека: Продолжайте использовать чат редактора и предлагаемые правки; контролируемая конечная точка Ollama с квантованной моделью Qwen3.5-4B на сервере для генерации ответов.
- Основное ограничение: Качество небольшой модели, ограниченный контекст кода и сетевая задержка ограничивают пользу. Это не замена крупнейшим коммерческим системам для программирования.
5. Преобразование счетов и сканов в структурированные записи
Изображения счетов могут превращаться в предлагаемые поля поставщика, даты, номера счёта и итоговой суммы в таблице для проверки. Привязка каждой строки к исходному документу упрощает сравнение. Практическая польза заключается в согласованном наборе записей, который можно проверить и передать в следующий бизнес-процесс.

Модель vision-language принимает как изображения, так и текст. Подготовьте изображение одной страницы за раз, затем запросите у модели нужные поля. Это позволяет использовать GPU для визуальной интерпретации, а не исходить из предположения, что модель может разобрать любой тип PDF. Чистые PDF с текстовым слоем могут требовать только обычного парсинга без участия GPU.
После извлечения обычный прикладной код проверяет, что обязательные значения присутствуют, а даты и числа соответствуют ожидаемым форматам. Он также может проверять арифметику, где это возможно, и искать повторяющиеся идентификаторы счетов. Отсутствующие или неоднозначные поля остаются помеченными. Сервер объединяет результаты пакетной обработки и их источники для передачи на проверку:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Извлечённые поля являются предложениями до завершения обычных проверок и проверки человеком; только после этого их следует сохранять как утверждённые записи.
- Стартовый проект: Преобразуйте одну группу счетов в таблицу для проверки со ссылками на источники. Сверяйте каждое выбранное поле с оригиналом перед принятием строки.
- Пример стека: Подготовка изображений страниц; Ollama с Qwen3.5-4B для визуального извлечения; обычный код валидации/экспорта и этап проверки для получения утверждённых записей таблицы со ссылками на источники.
- Главное ограничение: Правдоподобные значения могут быть ошибочными. Требуйте одобрения человеком перед бухгалтерской проводкой или платежом.
6. Подготовка загруженного видео для разных зрителей
Урок или демонстрация продукта может требовать несколько версий для доставки, а не новых съёмок. Транскодирование преобразует уже закодированное видео. Подходящий мастер-файл может стать копиями в 1080p и 720p для разных экранов и каналов связи. Уменьшение разрешения может упростить доставку; увеличение разрешения не восстановит утраченные детали.
NVENC — это специализированный видеокодировщик NVIDIA, отдельный от вычислений языковых моделей. Кодек — это технология кодирования и декодирования видео. H.264 — широко совместимый вариант для старта; AV1 — другой вариант, если целевые устройства воспроизведения его поддерживают. Декодирование и масштабирование могут выполняться другим графическим оборудованием или процессором.
Сервер может применять единые настройки конвертации к файлам в очереди загрузки и хранить версии для доставки отдельно от мастер-файла. Медиааппаратное обеспечение выполняет поддерживаемое кодирование, но настройки всё равно определяют результат. Выбирайте аппаратное кодирование ради производительности, а не гарантированного улучшения качества по сравнению с кодированием на CPU.
- Стартовый проект: Преобразуйте одну собственную запись в версии 1080p и 720p. Проверьте воспроизведение на целевых устройствах, синхронизацию звука, читаемость содержимого и размеры файлов.
- Пример стека: FFmpeg для конвертации с кодированием, поддерживаемым NVIDIA; простая очередь загрузки для планирования задач и хранилище для исходных файлов и готовых версий для доставки.
- Основное ограничение: Производительность зависит от кодеков, настроек, ограничений сессий драйвера, активности диска и пропускной способности передачи — а не только от объёма памяти GPU.
7. Отправка рендеров Blender на удалённый GPU-воркер
Дизайнер продукта может продолжать моделирование локально, пока сервер создаёт финальные статичные изображения или кадры вращения. Рендеринг означает вычисление финальных изображений из существующей 3D-сцены, а не создание изображения по текстовому запросу. Вы предоставляете сцену, материалы, освещение и камеру; воркер вычисляет готовые изображения.
Бэкенд рендеринга связывает вычисления сцены с аппаратным ускорением RTX. Можно запускать фоновый рендеринг без интерактивного удалённого рабочего стола, и подготовленное задание создаст выходные файлы на сервере. Выбирайте GPU-рендеринг отдельно; одного фонового режима недостаточно для выбора устройства рендеринга.
Для передачи необходимы совместимые функции Blender и все нужные ресурсы: упакуйте текстуры вместе с проектом или убедитесь, что их пути доступны на сервере. Время загрузки и подготовки может превышать пользу для очень мелких задач. Поддерживаемый резервный режим памяти может помочь большим сценам уместиться, но с компромиссом в производительности.
- Стартовый проект: Отрендерите одну умеренную сцену продукта в финальные статичные изображения или короткое вращение. Проверьте текстуры, материалы, освещение и кадрирование на репрезентативном кадре, прежде чем ставить всё в очередь.
- Пример стека: Blender Cycles для рендеринга сцены; NVIDIA OptiX для GPU-ускорения; фоновое выполнение для создания выходных файлов без необходимости интерактивного удалённого рабочего стола.
- Основное ограничение: Объём памяти для сцены и текстур определяет, что поместится. Несколько карт, как правило, не объединяют память сцены на этом оборудовании.
8. Адаптация небольшой модели под один повторяемый сценарий
Более продвинутый уровень. Можно адаптировать небольшую модель для классификации обращений в поддержку по существующим категориям: биллинг, доступ к аккаунту или технические проблемы. Представьте, что вы обучаете сотрудника узкой процедуре, а не обучаете его с нуля. Результатом является адаптер и доказательства оценки качества, а не автоматические действия с тикетами без контроля человека.
QLoRA сохраняет квантованную базовую модель практически неизменной, а обучает небольшие добавляемые компоненты, называемые адаптерами. Это не обучение фундаментальной модели и не полная донастройка всех весов. GPU выполняет обучение; сервер обеспечивает изолированное, повторяемое задание и хранит его артефакты. Другие задачи, требующие одной карты, планируйте отдельно.
Начните с поддерживаемого рецепта обучения небольших текстовых моделей, а не с ранее использованного пакета инференса Ollama. Согласно требованиям Unsloth, поддерживаемые модели примерно от трёх до восьми миллиардов параметров являются подходящими стартовыми кандидатами. Короткие последовательности и небольшие батчи помогают контролировать использование памяти, но не каждая модель или рецепт поместится в 16 ГБ. Сначала попробуйте промпты; для изменяющихся фактов используйте поиск по данным (retrieval).
- Стартовый проект: Сравните исходную модель, версию с улучшенным промптом и адаптированную версию на одних и тех же отложенных запросах — примерах, не использованных при обучении. Изучите выбор категорий и ошибки.
- Пример стека: Задокументированный в Unsloth маршрут обучения с использованием более старой текстовой модели Qwen2.5-7B-Instruct в совместимом 4-битном рецепте; размеченные примеры обращений и код оценки предсказаний категорий.
- Главное ограничение: Качество данных и оценка определяют, помогла ли адаптация. Завершение обучения не demonstrates улучшения.
Что нужно вашему проекту помимо GPU
Когда у вас появился проект, подберите сопутствующие ресурсы сервера. Если VRAM — это рабочий стол, то системная оперативная память — соседняя зона для подготовки приложения и данных. Выбирайте мощность CPU для парсинга и другой сопутствующей работы приложения. NVMe SSD-накопитель — это склад для активных моделей и ресурсов.
Больше места на накопителе не увеличивает объём памяти GPU; перенос работы в системную RAM может помочь поддерживаемым приложениям уместиться, но с накладными расходами на производительность. Сверяйте требования выбранного ПО к оборудованию с этими ресурсами.
AlexHost предлагает конфигурации с одной и двумя картами, включая одну RTX 4070 Ti SUPER с 16 GB объёма памяти GPU, 64 GB RAM и 1 TB NVMe. Это один из примеров сочетания карты с ресурсами для сопутствующего приложения.
Когда нагрузка растёт, различайте более длинную очередь и задачу, которая больше не помещается. Другая GPU может обрабатывать независимые задачи. Более крупной модели или сцене, возможно, потребуется больше памяти на одну карту. Некоторые приложения для обслуживания моделей могут распределять задачу между картами с накладными расходами на связь; независимые воркеры — более простой вариант:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Оставляйте запас памяти сверх весов модели для контекста и временных вычислений. Более высокое разрешение изображений и одновременные запросы также могут увеличить потребность в памяти. Руководство Ollama по памяти объясняет, почему размер загрузки не равен пиковому использованию памяти. На одной карте очереди задач или раздельные расписания могут не дать конкурирующим моделям исчерпать память.
📝 Примечание:Концептуальные назначения, а не обещанная схема провайдера: две отдельные GPU по 16 GB дают 32 GB суммарно, а не автоматическое выделение 32 GB на одну задачу. Разделение модели между картами — отдельная функция ПО, а не автоматическое объединение памяти.
Библиотекам записей нужны хранилище и резервные копии, а частые передачи делают пропускную способность частью решения о мощности. Для сервиса, доступного извне, используйте аутентификацию и ограничивайте доступ предназначенными пользователями. Ответственный за обслуживание должен поддерживать его в актуальном состоянии и проверять внешние пути обработки данных. Этот ответственный также должен решить, как долго хранить журналы и резервные копии.
Регулярная работа может оправдать выделенные ресурсы; эпизодическое использование может лучше подойти API или разовой аренде. Соотносите усилия по эксплуатации приложения со стоимостью аренды.
Выберите один полезный первый проект
Сопоставьте нужный результат с небольшим проектом, который можно проверить:
| Ваша цель | Начальный проект | Основное ограничение |
|---|---|---|
| 📚 Ответы на основе внутренних документов | Одна подобранная коллекция материалов для адаптации | Качество поиска и права доступа |
| 🎨 Концепции изображений для кампаний | Вариации одного собственного фото продукта | Точность изображения продукта и права |
| 🎙️Читаемые и доступные для поиска записи | Проверенная расшифровка и субтитры | Качество аудио и исправления |
| 💻 Помощь внутри редактора кода | Черновые тесты для одного модуля | Контекст и проверка кода |
| 🧾 Структурированные записи счетов | Одна группа счетов в таблице для проверки | Проверка полей и утверждение |
| 🎬 Видео, готовое к публикации | Одна запись в двух разрешениях | Поддержка кодеков и мощность конвейера |
| 🧊 Готовые 3D-визуализации | Небольшая задача по рендерингу продукта | Объём памяти сцены и передача ресурсов |
| 🧠 Стабильное поведение модели — продвинутый уровень | Адаптер для категорий поддержки | Обучающие данные и оценка на отложенной выборке |
Для команд, работающих с документами, помощник по знаниям — доступная отправная точка. Визуальные создатели могут начать с редактирования изображений, а владельцы библиотек записей — с транскрибирования. Выберите один результат, используя материалы, которыми вы владеете или на использование которых у вас есть разрешение. Сделайте успех конкретным: ответ, подкреплённый нужными фрагментами, или субтитры, которые соответствуют записи.
Если для вашего выбора подходит удалённый хостинг, предложение GPU-серверов AlexHost предлагает конфигурации, которые можно сравнить с выбранным вами проектом. Затем создайте минимальную версию, которая даёт полезный результат. Ваша первая веха — готовый результат, который можно использовать, а не сервер, заполненный незавершёнными приложениями.