Bilhete aberto
 +373 79 600002
 Chat ao vivo do Telegram
 F.A.Q
 Português
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Українська
 български
 Polski
 Indonesia
 中文 (中国)


 em todos os serviços de alojamento


Melhores casos de uso para servidores com RTX 4070 Ti SUPER em 2026
Your onboarding documents could become source-linked answers. An owned product photo could become campaign-background concepts. An existing 3D scene could become finished product visuals—all without keeping a laptop occupied. Those are three practical RTX 4070 Ti SUPER server use cases: focused jobs with recognizable outputs.
The eight options below are alternatives, not applications to load together. Here, “best” means useful outcomes with a realistic software path, not a benchmark ranking. Compact image-and-text models and editing workflows expand the options in 2026; encoding and rendering remain useful too. Choose one focused service or queued worker that can keep running independently of your laptop.
La frontera útil: 16 GB de espacio de trabajo rápido
La RTX 4070 Ti SUPER tiene 16 GB de VRAM: la memoria de trabajo de la GPU. Es su banco de trabajo para modelos y escenas, por lo que los proyectos siguientes usan modelos más pequeños y trabajos acotados. El software compatible de NVIDIA se encarga de la IA y el renderizado; el hardware dedicado de codificación de vídeo respalda el trabajo multimedia. Estos son puntos de partida respaldados por documentación, no pruebas de rendimiento de despliegue. Cada uno supone una sola tarjeta configurada adecuadamente.
1. Ask your own documents, not the whole internet
Un nuevo compañero pregunta qué lista de verificación de incorporación se aplica a su puesto. En lugar de buscar en carpetas, recibe una respuesta preliminar vinculada a archivos o runbooks de incorporación aprobados. Con el modelo alojado de forma remota y el acceso del equipo controlado, esto puede convertirse en un servicio privado de conocimiento.
Wait, I must translate into Portuguese, not Spanish. Let me redo.
1. Ask your own documents, not the whole internet
Um novo colega pergunta qual lista de verificação de integração se aplica à sua função. Em vez de pesquisar em pastas, ele recebe uma resposta preliminar vinculada a arquivos ou runbooks de integração aprovados. Com o modelo hospedado remotamente e o acesso da equipe controlado, isso pode se tornar um serviço privado de conhecimento.
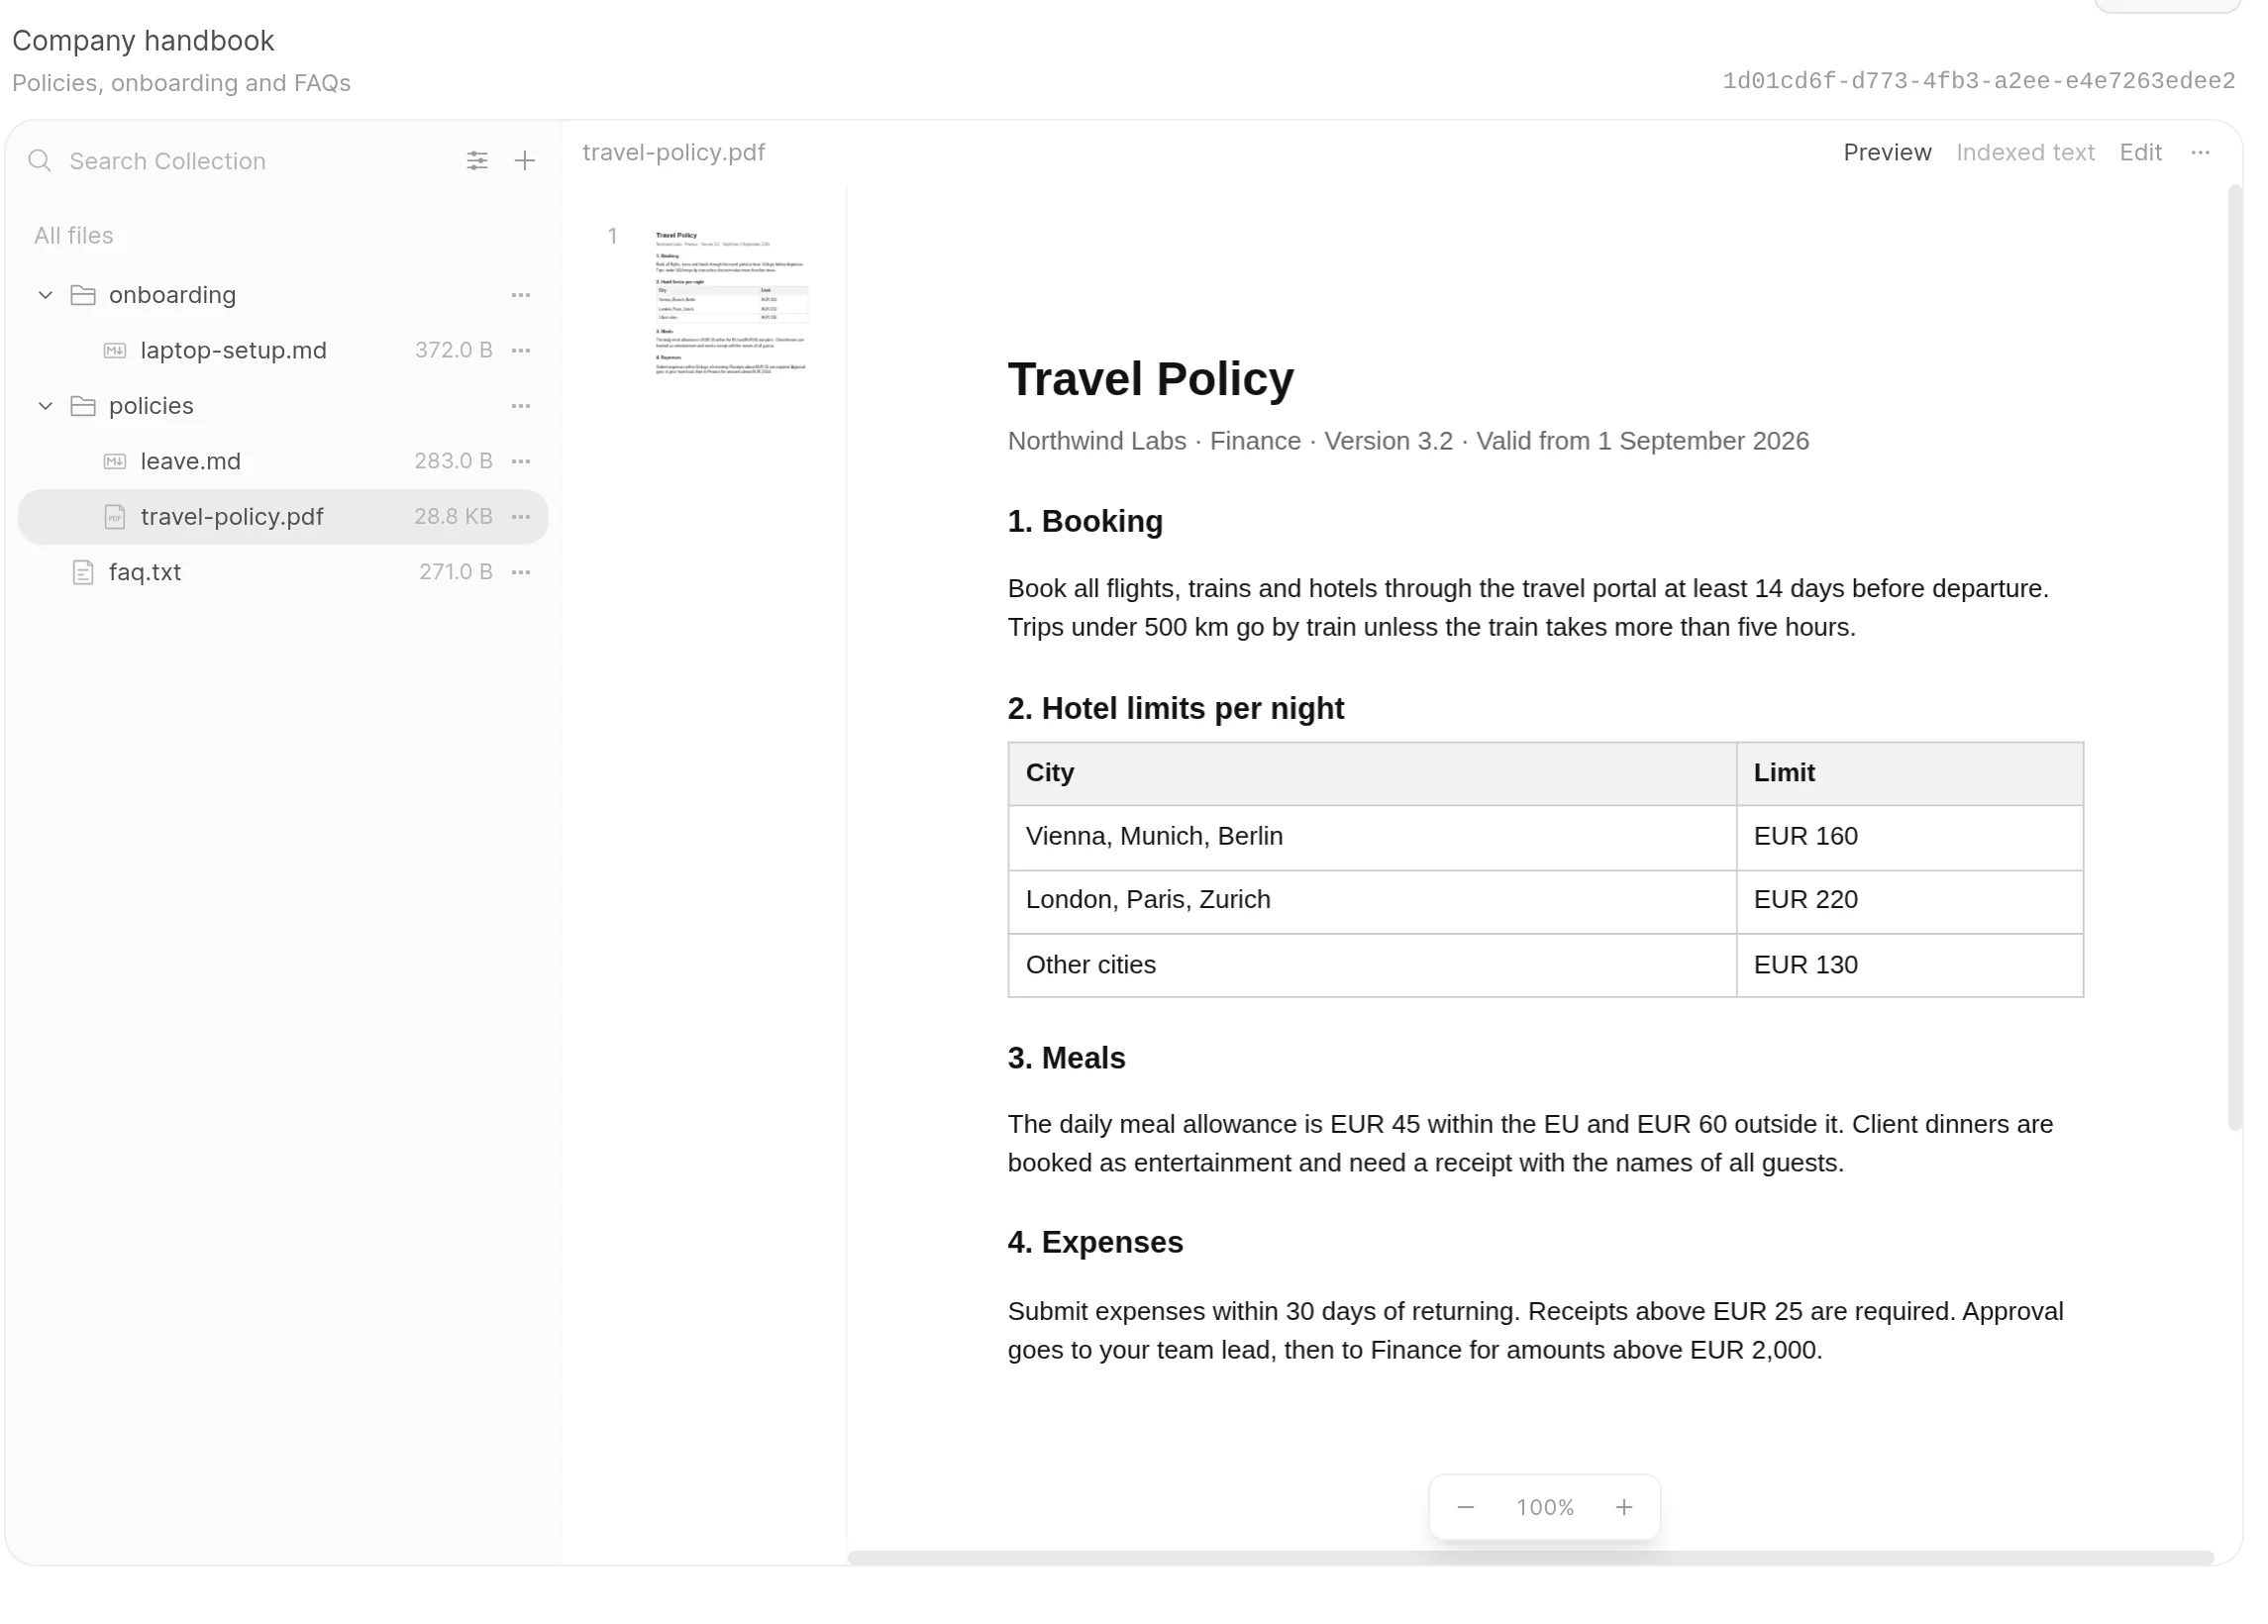
A geração aumentada por recuperação, ou RAG, funciona como um assistente de consulta com livro aberto: o software encontra trechos relevantes e os entrega ao modelo antes de ele responder. Os embeddings tornam os trechos pesquisáveis por significado, e não apenas por wording exato. Enviar documentos não retreina o modelo; a resposta depende do material recuperado para aquela pergunta.
📝 Note: Private inference means the model runs on the remote server, not that every component is private. Check where embeddings and document parsing run. Logs and external fallbacks also need review. Remote hosting remains a trust relationship with the provider.
A GPU acelera principalmente a inferência: o uso de um modelo já treinado para gerar a resposta. Um modelo quantizado armazena seus números com menos bits, economizando memória com possíveis trade-offs de qualidade. A pergunta e os trechos recuperados fazem parte do seu contexto, as informações que o modelo mantém em foco para uma requisição. A correspondência de trechos pode usar um pequeno componente autohospedado; armazenar e pesquisar arquivos não exige necessariamente outro grande serviço de GPU.
- Projeto inicial: Uma coleção de integração e perguntas com respostas conhecidas. Verifique as respostas em relação aos trechos citados; inclua uma pergunta sem resposta para ver se o assistente reconhece a informação ausente.
- Exemplo de stack: Open WebUI para documentos e recuperação; embeddings autohospedados para correspondência de trechos; Ollama executando o Qwen3.5-4B quantizado para respostas no servidor.
- Principal limite: A qualidade da recuperação e as permissões determinam o que chega ao modelo. As citações ajudam a verificar as respostas; elas não certificam a verdade.
2. Dê a uma equipe seu próprio estúdio de geração e edição de imagens
Uma pequena loja possui a foto de um produto e precisa de conceitos de fundo para campanhas: um cenário de estúdio, um ambiente sazonal, uma paleta de cores diferente. O resultado é um conjunto de rascunhos para que alguém selecione e refine, um primeiro objetivo mais viável do que substituir a fotografia de produtos.
O fluxo de trabalho visual conecta estações de processamento, chamadas nós, que carregam uma imagem de referência, aplicam instruções e salvam os resultados. A GPU executa o modelo de imagem para transformar a foto e o prompt em uma variação. Salvar esse fluxo de trabalho oferece à equipe um ponto de partida repetível para o próximo conjunto de conceitos.
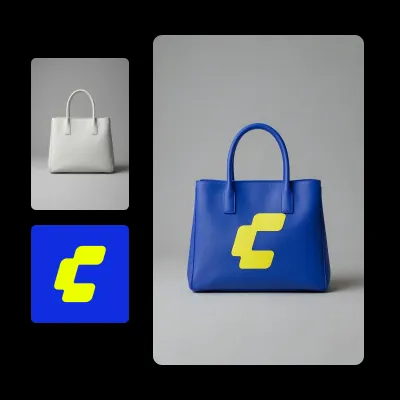
Os membros da equipe podem enviar tarefas para uma fila de servidor compartilhada, em vez de recriar a configuração em computadores individuais. O modelo FLUX.2 [klein] 4B proposto usa a licença Apache-2.0, que permite uso comercial de acordo com seus termos. Essa licença se aplica a esta variante, não a todos os modelos FLUX; os direitos sobre as imagens continuam importando.
- Projeto inicial: Crie algumas variações de fundo para uma imagem de produto de sua propriedade. Compare o formato, o texto da embalagem, os logotipos e a consistência da marca com o original antes do uso.
- Pilha de exemplo: ComfyUI para o fluxo de trabalho visual salvo e a fila de tarefas; FLUX.2 [klein] 4B destilado para geração e edição de imagens de referência na GPU.
- Principal limitação: Uma imagem convincente ainda pode alterar o produto ou seu texto. Trate os resultados como conceitos que exigem revisão de precisão e de direitos.
3. Превратите записи в транскрипты, субтитры и доступные для поиска знания
Wait — the target language is Portuguese, not Russian. Correcting that:
3. Transforme gravações em transcrições, legendas e conhecimento pesquisável
Seu webinar ou uma reunião gravada com o consentimento adequado pode conter informações difíceis de encontrar depois. Um worker de transcrição converte isso em texto com marcações de tempo e arquivos de legenda. Organize as transcrições revisadas e a pesquisa de texto comum pode ajudar a localizar um tema sem reproduzir cada gravação.

O modelo de fala primeiro produz segmentos de transcrição com marcações de tempo. Um wrapper de exportação — código de aplicação em torno da biblioteca de reconhecimento — então salva esses segmentos como texto legível e como arquivos de legenda SRT ou VTT. Essas marcações de tempo conectam as palavras de volta à gravação e fornecem ao exportador de legendas as informações de temporização.
Uma pasta de upload ou fila permite que o servidor processe um acúmulo de gravações sem supervisão, com a GPU cuidando do reconhecimento de fala. Resumos opcionais exigem outro modelo, de preferência agendado separadamente em uma mesma placa. Rótulos de falantes exigem uma etapa separada para distinguir os falantes; a transcrição sozinha não os fornece.
- Projeto inicial: Processe várias gravações com permissão liberada em transcrições e legendas. Compare amostras com o áudio, verificando nomes, vocabulário técnico e a temporização das legendas.
- Stack de exemplo: faster-whisper com large-v3 e configurações de GPU de precisão reduzida adequadas; uma fila de upload; um wrapper de exportação para arquivos de legenda e armazenamento de transcrições pesquisável.
- Principal limitação: A qualidade do áudio determina a carga de correção. Ruído, sotaques, termos desconhecidos e falantes sobrepostos podem deixar erros que precisam de revisão humana.
4. Connect a private coding assistant to your editor
Select a function in your editor and ask for tests, an explanation, or a small refactor. You get draft code beside the function you are working on. Your editor and working files can stay on the laptop while selected code travels to the server for inference.
O editor envia o código selecionado e a sua pergunta para um endpoint de modelo remoto e, em seguida, exibe a resposta no espaço de desenvolvimento. Incluir o comportamento pretendido da função ajuda a tornar o pedido concreto. Para uma tarefa de escrita de testes, o resultado oferece-lhe um rascunho para comparar com esse comportamento, em vez de um ficheiro de teste em branco.
A GPU trata da geração de respostas, enquanto o servidor fornece um endpoint reutilizável para os pedidos do editor. Mantenha a execução e as edições de risco sob o seu controlo, com permissões restritas. O chat no editor é o fluxo de trabalho inicial aqui; o autocomplete inline responsivo tem requisitos diferentes de modelo e latência.
- Projeto inicial: Escreva rascunhos de testes para um módulo. Analise-os, execute-os num ambiente de desenvolvimento controlado e verifique o comportamento pretendido — não apenas se compilam.
- Stack de exemplo: Continue para o chat do editor e edições propostas; um endpoint Ollama controlado a executar o Qwen3.5-4B quantizado no servidor para a geração de respostas.
- Principal limitação: A qualidade de modelos pequenos, o contexto de código limitado e a latência de rede restringem a ajuda. Isto não substitui os maiores sistemas comerciais de programação.
5. Transformar faturas e digitalizações em registros estruturados
Imagens de faturas podem se tornar campos propostos de fornecedor, data, número da fatura e valor total em uma planilha de revisão. Vincular cada linha ao seu documento original facilita a comparação. A vantagem prática é um conjunto consistente de registros que alguém pode verificar e encaminhar para o próximo processo de negócio.

Um modelo de visão e linguagem aceita imagens além de texto. Prepare uma imagem de página por vez e, em seguida, solicite os campos de que você precisa. Isso torna a GPU útil para a interpretação visual, em vez de presumir que o modelo consegue analisar todos os tipos de PDF. PDFs limpos e baseados em texto podem exigir apenas análise comum, sem envolver a GPU.
Após a extração, código de aplicação comum verifica se os valores obrigatórios estão presentes e se datas e números seguem os formatos esperados. Ele também pode verificar a aritmética quando disponível e procurar identificadores de fatura duplicados. Campos ausentes ou incertos permanecem sinalizados. O servidor reúne os resultados do lote e suas fontes para a etapa de revisão:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Os campos extraídos são propostas até que as verificações comuns e a revisão humana sejam concluídas; somente então devem se tornar registros aprovados.
- Projeto inicial: Converta uma família de faturas em uma planilha de revisão com referências de origem. Compare cada campo selecionado com o original antes de aceitar a linha.
- Pilha de exemplo: Preparação de imagens de página; Ollama com Qwen3.5-4B para extração visual; código comum de validação/exportação e uma etapa de revisão para produzir registros de planilha aprovados com referências de origem.
- Principal limitação: Valores plausíveis podem estar errados. Exija aprovação humana antes do lançamento contábil ou do pagamento.
6. Versionar el video subido para distintos espectadores
Una lección o una demostración de producto puede necesitar varias versiones de entrega, no nuevas grabaciones. La transcodificación convierte video ya codificado. Un máster adecuado puede convertirse en copias de 1080p y 720p para distintas pantallas y conexiones. Reducir la resolución puede ayudar a la entrega; aumentarla no puede recuperar detalles perdidos.
NVENC es el codificador de video especializado de NVIDIA, separado del cálculo de modelos de lenguaje. Un códec es la tecnología que se usa para codificar y decodificar video. H.264 es una opción de partida ampliamente compatible; AV1 es otra opción cuando los dispositivos de reproducción de destino la admiten. La decodificación y el escalado pueden implicar otro hardware de GPU o la CPU.
El servidor puede aplicar configuraciones de conversión coherentes a las subidas en cola y almacenar las copias de entrega por separado del máster. El hardware multimedia se encarga de la codificación compatible, pero la configuración sigue influyendo en el resultado. Elija la codificación por hardware por rendimiento, no por mejoras de calidad garantizadas frente a la codificación por CPU.
- Proyecto inicial: Convierta una grabación propia en versiones de 1080p y 720p. Compruebe la reproducción en los dispositivos previstos, la sincronización del sonido, la legibilidad del contenido y el tamaño de los archivos.
- Pila de ejemplo: FFmpeg para la conversión con codificación compatible con NVIDIA; una cola de subida sencilla para programar los trabajos y un almacenamiento para los archivos de origen y las versiones de entrega terminadas.
- Límite principal: La capacidad depende de los códecs, la configuración, las restricciones de sesiones del controlador, la actividad del disco y el ancho de banda de transferencia, no solo de la memoria de la GPU.
7. Отправка рендеров Blender на удалённый GPU-воркер
Wait — the target language is Portuguese, not Russian. Correcting that:
7. Envio de renderizações do Blender para um worker GPU remoto
Um designer de produtos pode continuar modelando localmente enquanto um servidor produz imagens finais ou quadros de turntable. Renderização significa calcular imagens finais a partir de uma cena 3D existente, e não criar uma imagem a partir de um prompt de texto. Você fornece a cena, os materiais, a iluminação e a câmera; o worker calcula as imagens finalizadas.
O backend de renderização conecta os cálculos da cena à aceleração por hardware RTX. Você pode executar a renderização em segundo plano, sem uma área de trabalho remota interativa, permitindo que o job preparado produza os arquivos de saída no servidor. Selecione a renderização por GPU separadamente; o modo em segundo plano por si só não escolhe o dispositivo de renderização.
A transferência exige recursos compatíveis do Blender e todos os ativos necessários: empacote as texturas com o projeto ou garanta que seus caminhos sejam resolvidos no servidor. O tempo de upload e preparação pode superar o benefício em jobs muito pequenos. O fallback de memória suportado pode ajudar cenas maiores a caber, com um custo de desempenho.
- Projeto inicial: Renderize uma cena de produto modesta em imagens finais ou um turntable curto. Verifique as texturas, materiais, iluminação e enquadramento de um quadro representativo antes de enfileirar tudo.
- Stack de exemplo: Blender Cycles para renderização de cena; NVIDIA OptiX para aceleração por GPU; execução em segundo plano para produzir arquivos de saída sem exigir uma área de trabalho remota interativa.
- Principal limite: A memória de cena e de texturas determina o encaixe. Várias placas normalmente não combinam a memória da cena neste hardware.
8. Адаптация небольшой модели под одну повторяемую задачу
Ошибка: the system prompt says translate English to Portuguese. The content is English; I must translate to Portuguese, not Russian. Correcting:
8. Adaptar um modelo pequeno a uma tarefa repetível
Mais avançado. Você poderia adaptar um modelo pequeno para classificar pedidos de suporte em categorias existentes: faturamento, acesso à conta ou problemas técnicos. Pense em treinar um funcionário em um procedimento específico, e não em ensiná-lo do zero. O resultado final é um adaptador mais evidências de avaliação, e não ações não supervisionadas sobre chamados.
O QLoRA mantém um modelo base quantizado praticamente fixo enquanto treina pequenos componentes adicionados chamados adaptadores. Isso não é treinamento de modelo fundacional nem ajuste fino de todos os pesos. A GPU realiza o treinamento; um servidor fornece uma tarefa isolada e repetível e armazena seus artefatos. Agende outras cargas de trabalho de uma única placa separadamente.
Comece com uma receita de treinamento compatível com modelos de texto pequenos, em vez do pacote de inferência Ollama usado anteriormente. De acordo com os requisitos do Unsloth, modelos suportados com cerca de três a oito bilhões de parâmetros são candidatos iniciais. Sequências curtas e lotes pequenos ajudam a controlar o uso de memória, mas nem todo modelo ou receita caberá em 16 GB. Teste primeiro com prompts; use recuperação de informações para fatos que mudam.
- Projeto inicial: Compare o modelo original, uma versão com prompt aprimorado e uma versão adaptada sobre as mesmas solicitações de teste reservadas, isto é, exemplos excluídos do treinamento. Inspecione as escolhas de categoria e as falhas.
- Pilha de exemplo: Rota de treinamento documentada pelo Unsloth usando o modelo de texto Qwen2.5-7B-Instruct, mais antigo, em uma receita 4-bit compatível; exemplos de suporte rotulados e código de avaliação para previsões de categoria.
- Principal limitação: A qualidade dos dados e a avaliação determinam se a adaptação ajudou. Concluir o treinamento não demonstra melhoria.
O que seu projeto precisa além da GPU
Depois de definir um projeto, dimensione o servidor ao redor. Se a VRAM é a bancada de trabalho, a RAM do sistema é o espaço de preparação próximo para a aplicação e a preparação de dados. Escolha a capacidade da CPU para análise e outras tarefas de aplicação ao redor. O armazenamento NVMe SSD é o armazém para modelos e recursos ativos.
Mais armazenamento não aumenta a memória da GPU; mover o trabalho para a RAM do sistema pode ajudar aplicações compatíveis a caber na memória, com sobrecarga de desempenho. Verifique os requisitos de hardware do software escolhido junto com esses recursos.
A AlexHost lista configurações com uma e duas placas, incluindo uma única RTX 4070 Ti SUPER com 16 GB de memória de GPU, 64 GB de RAM e 1 TB de NVMe. Este é um exemplo de combinação da placa com recursos para a aplicação ao redor.
Quando a carga de trabalho cresce, distinga uma fila maior de um trabalho que não cabe mais. Outra GPU pode lidar com trabalhos independentes. Um modelo ou cena maior pode, em vez disso, exigir mais memória por placa. Algumas aplicações de servir modelos podem dividir um trabalho entre placas, com sobrecarga de comunicação; trabalhadores independentes são a configuração mais simples:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Deixe espaço, além dos pesos do modelo, para contexto e cálculos temporários. Resoluções de imagem mais altas e solicitações simultâneas também podem aumentar as necessidades de memória. As orientações de memória do Ollama explicam por que o tamanho do download não é o uso máximo de memória. Em uma única placa, trabalhos em fila ou agendamentos separados podem impedir que modelos concorrentes esgotem a memória.
📝 Nota:Atribuições conceituais, não um layout de provedor garantido: duas GPUs separadas de 16 GB fornecem 32 GB agregados, não uma alocação automática de 32 GB. A divisão de modelos compatível é um recurso de software separado, não um pool automático de memória.
Bibliotecas de gravações precisam de armazenamento e backups, enquanto transferências frequentes tornam a largura de banda parte da decisão de dimensionamento. Para um serviço exposto, use autenticação e restrinja o acesso aos usuários pretendidos. Um responsável pela manutenção deve mantê-lo atualizado e verificar os caminhos de processamento externo. Esse responsável também precisa decidir por quanto tempo logs e backups serão retidos.
Trabalhos recorrentes podem justificar recursos dedicados; o uso esporádico pode se adequar melhor a uma API ou a um aluguel ocasional. Avalie o esforço de operar a aplicação junto com os custos de aluguel.
Escolha um primeiro projeto útil
Associe o resultado que você precisa a um pequeno projeto que você consiga verificar:
| Seu objetivo | Projeto inicial | Principal restrição |
|---|---|---|
| 📚 Respostas a partir de documentos internos | Uma coleção de integração curada | Qualidade da recuperação e permissões |
| 🎨 Conceitos de imagem para campanhas | Variações de uma foto de produto própria | Precisão do produto e direitos |
| 🎙️Gravações legíveis e pesquisáveis | Transcrição e legendas revisadas | Qualidade de áudio e correção |
| 💻 Ajuda dentro do seu editor | Rascunhos de testes para um módulo | Contexto e revisão de código |
| 🧾 Registros estruturados de faturas | Uma família de faturas em uma planilha de revisão | Validação de campos e aprovação |
| 🎬 Vídeo pronto para entrega | Uma gravação em duas resoluções | Suporte a codecs e capacidade do pipeline |
| 🧊 Visuais 3D finalizados | Um pequeno trabalho de renderização de produto | Memória da cena e transferência de ativos |
| 🧠 Comportamento consistente do modelo—avançado | Um adaptador para categorias de suporte | Dados de treinamento e avaliação com conjunto de retenção |
Para equipes com documentos, um assistente de conhecimento oferece um ponto de partida acessível. Criadores visuais podem começar com edição de imagens, enquanto quem tem bibliotecas de gravações pode começar com transcrição. Escolha um resultado final usando insumos que você possui ou tem permissão para usar. Torne o sucesso concreto: uma resposta baseada nas passagens certas, ou legendas que acompanhem a gravação.
Se a hospedagem remota se adequa à sua escolha, a oferta de servidores GPU da AlexHost apresenta configurações para você comparar com o projeto selecionado. Em seguida, construa a versão mais simples que produza um resultado útil. Seu primeiro marco é um resultado final que você possa usar, não um servidor cheio de aplicações meio iniciadas.