提交工单
 +373 79 600002
 Telegram 在线聊天
 常见问题
 中文 (中国)
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia





2026年RTX 4070 Ti SUPER服务器的最佳应用场景
Ваши учебные документы могут превращаться в ответы со ссылками на источник. Собственное фото продукта может стать концептами фона для кампаний. Существующая 3D-сцена может превратиться в готовые визуалы продукта, и всё это без необходимости держать ноутбук занятым. Это три практичных сценария использования сервера с RTX 4070 Ti SUPER: сфокусированные задачи с понятными результатами.
Восемь вариантов ниже являются альтернативами, а не приложениями, которые нужно запускать вместе. Здесь «лучший» означает полезные результаты с реалистичным программным путём, а не рейтинг по бенчмаркам. Компактные модели для работы с изображениями и текстом и рабочие процессы редактирования расширяют возможности в 2026 году; кодирование и рендеринг по-прежнему полезны. Выберите один сфокусированный сервис или очередь задач, которая сможет работать независимо от вашего ноутбука.
有用的边界:16 GB 高速工作空间
RTX 4070 Ti SUPER 配备 16 GB 显存——即 GPU 的工作内存。这是模型和场景的工作台,因此下面的项目使用较小的模型和有限的任务。兼容的 NVIDIA 软件负责 AI 和渲染;专用视频编码硬件支持媒体处理工作。这些都是基于官方文档的起点,并非部署基准测试。每项都假设配置得当的单张显卡。
1. Ask your own documents, not the whole internet
A new teammate asks which onboarding checklist applies to their role. Instead of searching folders, they receive a draft answer linked to approved onboarding files or runbooks. With the model self-hosted remotely and team access controlled, this can become a private knowledge service.
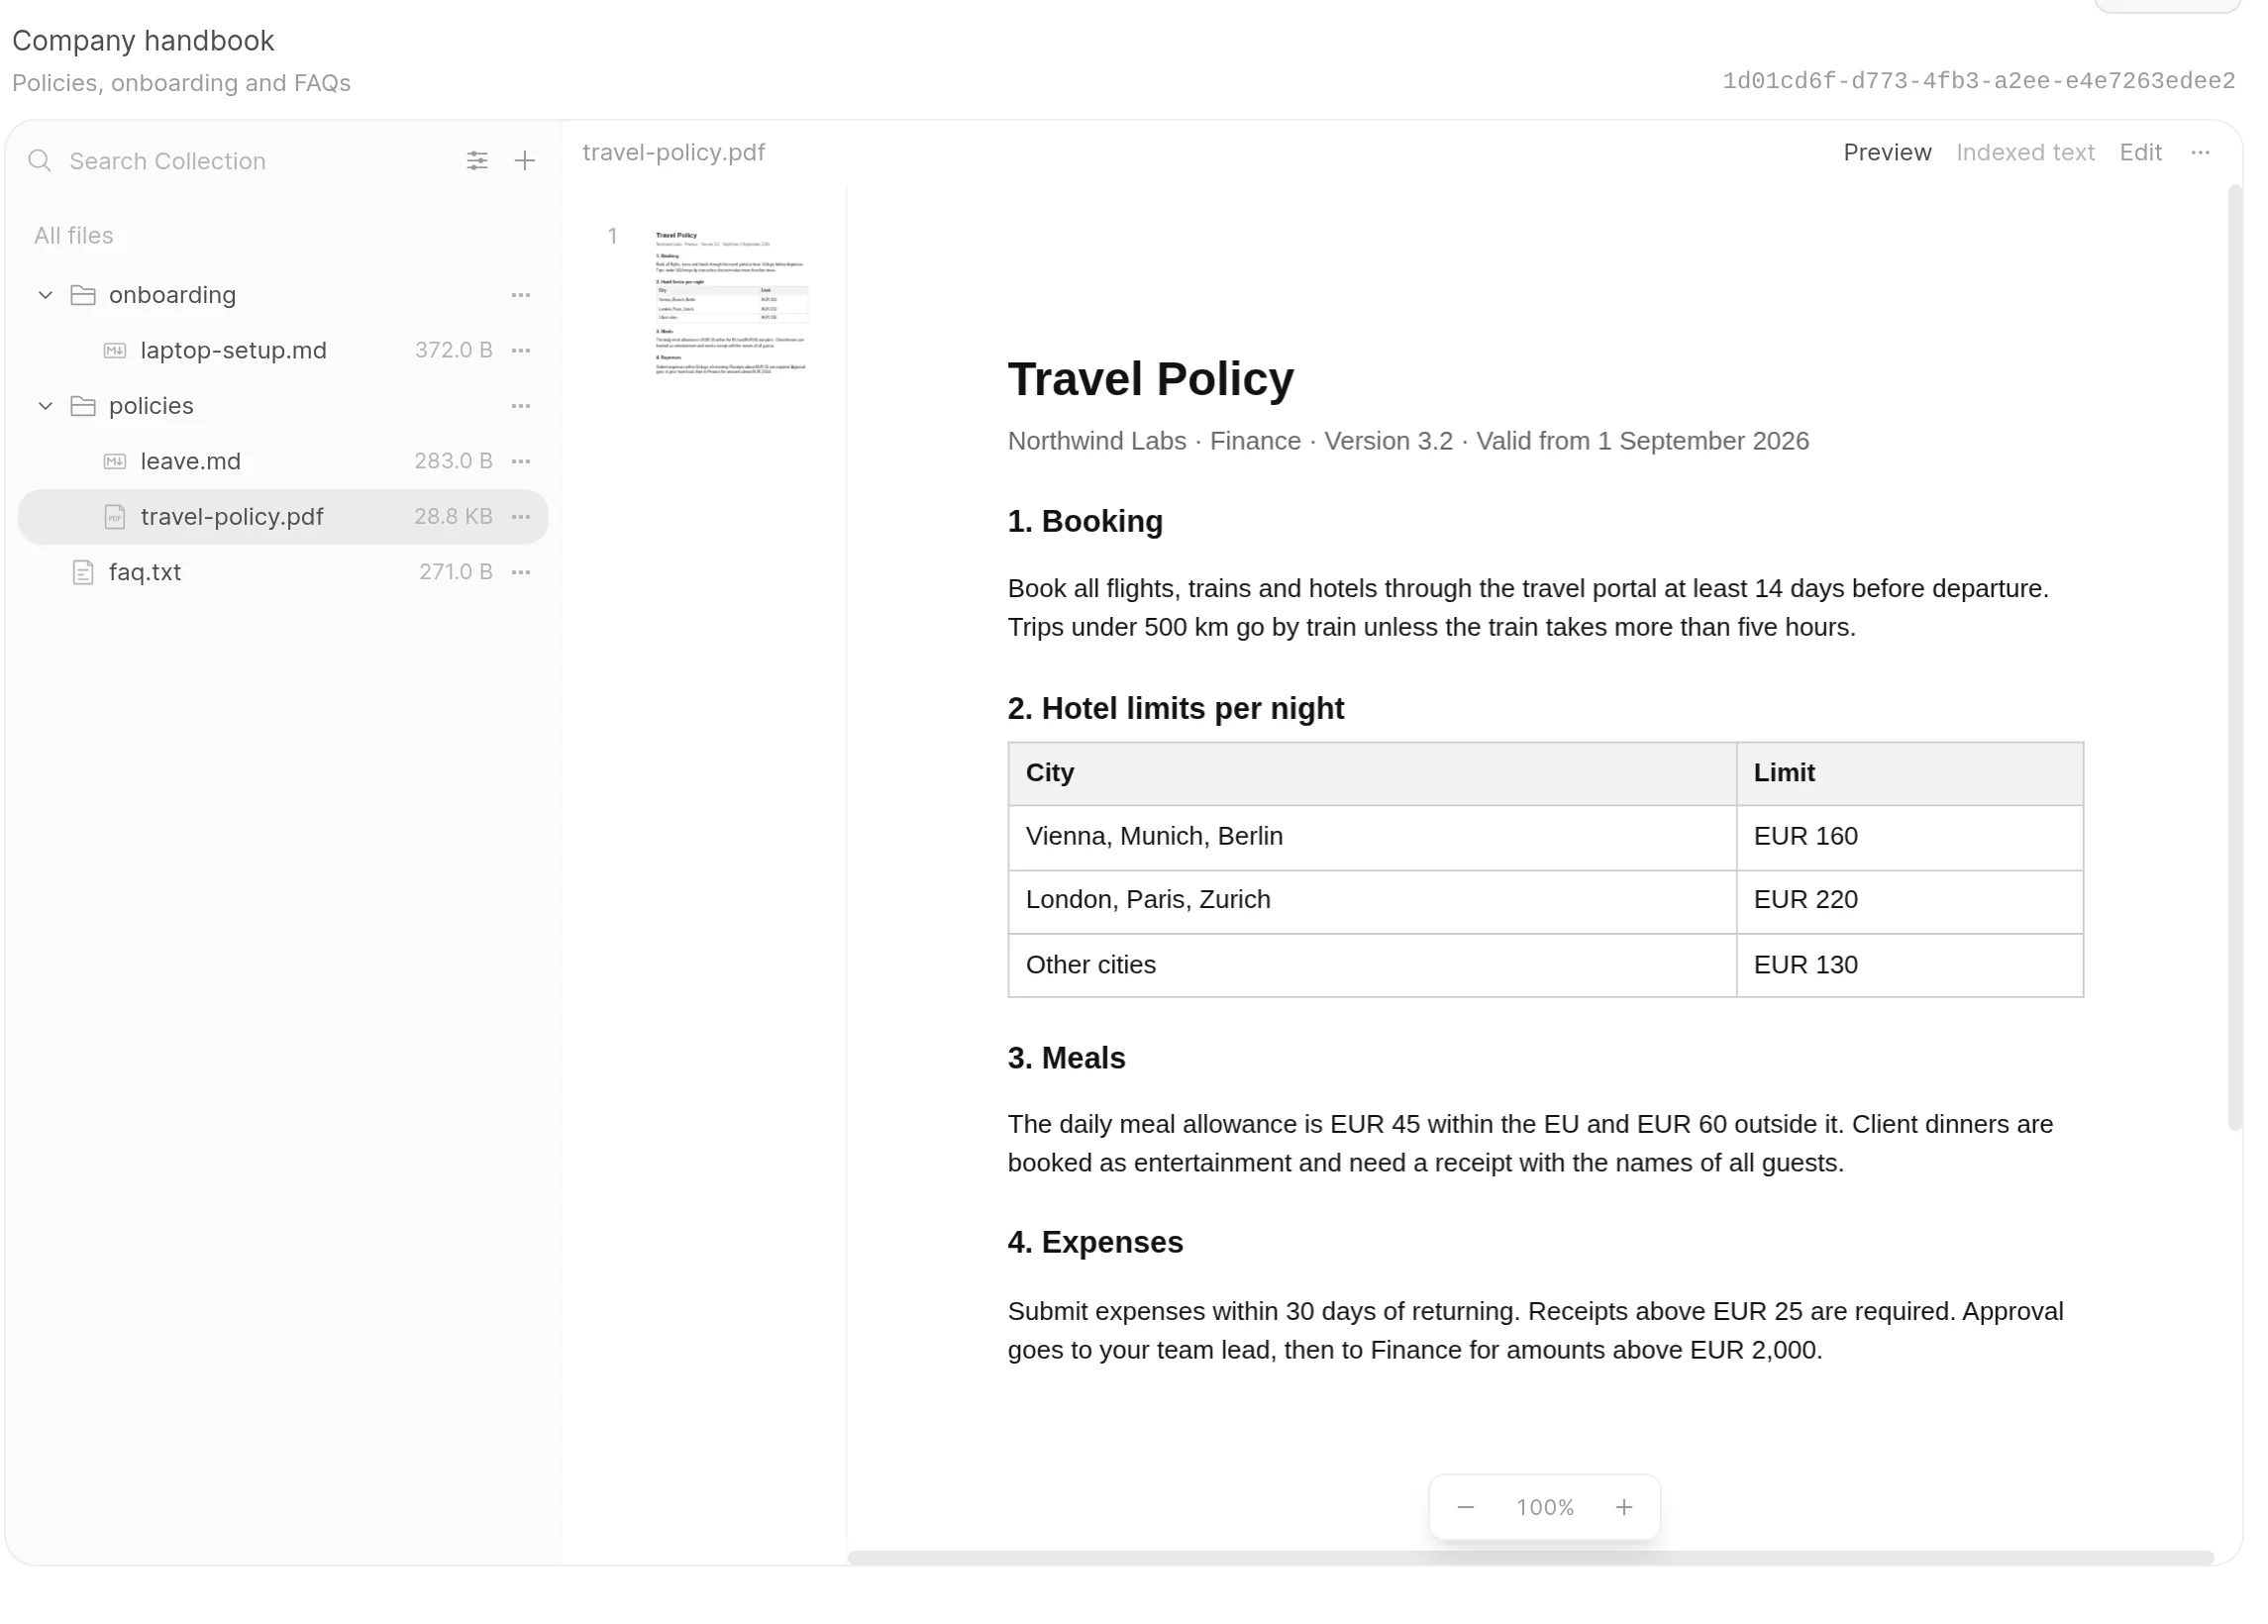
Retrieval-augmented generation, or RAG, works like an open-book assistant: software finds relevant passages and gives them to the model before it answers. Embeddings make passages searchable by meaning rather than exact wording alone. Uploading documents does not retrain the model; the answer depends on the material retrieved for that question.
📝 Note: 私有推理意味着模型运行在远程服务器上,但这并不代表每个组件都是私有的。请检查嵌入和文档解析在哪里运行。日志和外部备用方案也需要审查。远程托管仍然是与服务提供商之间的信任关系。
GPU主要用于加速推理:即使用已经训练好的模型来生成答案。量化模型以更少的位数存储其数值,从而节省内存,但可能会有质量上的权衡。问题和检索到的段落构成其上下文的一部分——即模型在处理请求时所关注的信息。段落匹配可以使用小型自托管组件;存储和搜索文件不一定需要另一个大型GPU服务。
- 入门项目:一个入职资料集和已知答案的问题。对照引用的段落检查答案;加入一个无法回答的问题,以查看助手是否会承认信息缺失。
- 示例技术栈:Open WebUI用于文档和检索;自托管嵌入用于段落匹配;Ollama运行量化的Qwen3.5-4B用于服务器端回答。
- 主要限制:检索质量和权限决定了哪些内容能够传递给模型。引用有助于你核查答案,但并不能证明答案的真实性。
2. 为团队配备专属的图像生成与编辑工作室
一家小店拥有一张产品照片,需要制作营销背景的概念图:摄影棚背景、应季场景或不同的配色方案。输出结果是一组草稿,供人员挑选和进一步优化。相比直接替代产品摄影,这是一个更易管理的初始目标。
视觉工作流将多个处理节点(称为 nodes)连接起来,用于加载参考图像、应用指令并保存结果。GPU 运行图像模型,将照片和提示词转化为变体图像。保存该工作流后,团队便拥有了可重复使用的起点,用于制作下一批概念图。
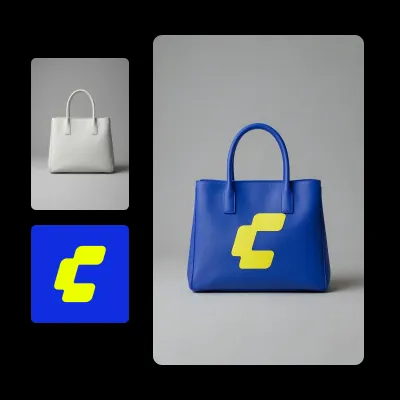
团队成员可以将任务提交到共享服务器队列,而无需在各自的台式机上重新搭建环境。拟使用的 FLUX.2 [klein] 4B 模型采用 Apache-2.0 许可证,在其条款范围内允许商业使用。该许可证仅适用于此变体,并非所有 FLUX 模型都适用;生成图像的权利问题依然需要重视。
- 入门项目:针对一张自有产品图像,制作几款背景变体。在使用前,将外形、包装文字、标志以及品牌一致性与原图进行对比。
- 示例技术栈:使用 ComfyUI 管理保存的视觉工作流和任务队列;在 GPU 上使用蒸馏版 FLUX.2 [klein] 4B 进行生成和参考图像编辑。
- 主要限制:即使图像看起来逼真,仍可能改变产品或其上的文字。应将输出结果视为概念图,并需经过准确性和版权审核。
3. Превращайте записи в транскрипты, субтитры и поисковые знания
Ошибка: вы просили перевести на китайский, а не на русский. Исправляю:
3. 将录音转换为文字稿、字幕和可搜索的知识
经过适当同意录制的网络研讨会或会议,可能包含日后难以查找的信息。转录工作程序会将其转换为带时间戳的文本和字幕文件。整理经过审核的文字稿后,普通文本搜索可以帮助您快速定位某个主题,而无需重新播放每段录音。

语音模型首先生成带时间戳的转录片段。导出封装程序(围绕识别库的应用代码)随后将其保存为可读文本以及SRT或VTT字幕文件。这些时间戳将文字与录音相对应,并为字幕导出器提供时序信息。
上传文件夹或队列让服务器无人值守地处理录音积压,由GPU负责语音识别。可选的摘要功能需要另一个模型,最好在同一块显卡上单独排期。说话人标签需要单独的阶段来区分不同说话人;仅靠转录无法提供这些标签。
- 入门项目:将几段已获授权的录音处理为文字稿和字幕。对照音频检查人名、专业术语和字幕时间轴。
- 示例技术栈:faster-whisper搭配large-v3,并使用合适的降低精度GPU设置;一个上传队列;一个用于生成字幕文件和可搜索文字稿存储的导出封装程序。
- 主要限制:音频质量决定校对工作量。噪音、口音、不熟悉的术语以及多人同时说话,都可能产生需要人工审核的错误。
4. 将私有编程助手连接到你的编辑器
在编辑器中选中一个函数,然后请求生成测试、解释或小范围重构。你会在正在处理的函数旁边获得草稿代码。编辑器和工作文件可以保留在笔记本电脑上,而选中的代码会发送到服务器进行推理。
编辑器会将选中的代码和你的问题发送到远程模型端点,然后在开发工作区中显示响应。加入函数的预期行为有助于使请求更加具体。对于编写测试的任务,结果会为你提供一份可与该预期行为对照的草稿,而不是一个空白的测试文件。
GPU负责生成响应,服务器则提供一个可复用的端点,用于处理编辑器请求。执行操作和有风险的修改应保持在你的控制之下,并限制权限。这里的起始工作流是编辑器聊天;响应迅速的内联自动补全对模型和延迟有不同的要求。
- 入门项目:为一个模块起草测试。检查这些测试,在受控的开发环境中运行它们,并验证预期行为——而不仅仅是检查它们能否编译。
- 示例技术栈:编辑器聊天和建议的修改继续使用;服务器上运行经过量化的Qwen3.5-4B的受控Ollama端点,用于生成响应。
- 主要限制:小模型的质量、有限的代码上下文以及网络延迟都会限制帮助效果。它无法替代最大的商业编程系统。
5. 将发票和扫描件转换为结构化记录
发票图像可以转换为审核电子表格中的待确认供应商、日期、发票号码和总金额字段。将每一行链接到其原始文档,可以方便地进行比对。实际收益在于获得一组一致的记录,有人可以对其进行核对,并将其传递到下一个业务流程。

一个视觉语言模型既能接受图像,也能接受文本。每次准备一页图像,然后让模型提取所需字段。这使GPU用于视觉解析,而不是假设模型能够解析所有类型的PDF。干净的、基于文本的PDF可能只需要普通解析,无需使用GPU。
提取完成后,普通应用程序代码会检查必填值是否存在,日期和数字是否采用预期格式。在可用的情况下,它还可以核对算术结果,并查找重复的发票标识符。缺失或不确定的字段会保持标记状态。服务器将批量结果及其来源汇总,以便交接给审核人员:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
在普通检查和人工审核完成之前,提取的字段仅为待确认建议;只有完成这些步骤后,才应将其转为已批准的记录。
- 入门项目:将一类发票转换为带有来源引用的审核电子表格。在接受每一行之前,将所选字段与原始文档逐一比对。
- 示例技术栈:页面图像准备;使用Qwen3.5-4B进行视觉提取的Ollama;普通验证/导出代码以及审核步骤,以生成带有来源引用的已批准电子表格记录。
- 主要局限:看似合理的数值也可能有误。在进行会计入账或付款之前,必须获得人工批准。
6. 使上传的视频适配不同的观看者
课程或产品演示可能需要多个交付版本,而不是新的素材。转码是对已编码视频的转换。合适的母版可以生成适用于不同屏幕和网络环境的1080p和720p副本。降低分辨率有助于交付;提高分辨率无法恢复丢失的细节。
NVENC是NVIDIA的专用视频编码器,与语言模型计算是分开的。编解码器是用于对视频进行编码和解码的技术。H.264是一个兼容性广泛的入门选择;当目标播放设备支持时,AV1是另一种选择。解码和缩放可能涉及其他GPU硬件或CPU。
服务器可以对排队的上传文件应用一致的转换设置,并将交付副本与母版分开存储。媒体硬件可以处理受支持的编码,但设置仍会影响最终效果。选择硬件编码是为了提高吞吐量,而不是保证比CPU编码获得更好的质量。
- 入门项目:将一个您拥有的录像转换为1080p和720p版本。检查目标设备的播放情况、声音同步、内容的可读性以及文件大小。
- 示例技术栈:使用FFmpeg进行支持NVIDIA编码的转换;使用简单的上传队列来安排任务,并使用存储空间保存源文件和完成的交付版本。
- 主要限制:处理能力取决于编解码器、设置、驱动会话限制、磁盘活动和传输带宽,而不仅仅是GPU显存。
7. 将 Blender 渲染任务发送到远程 GPU 工作节点
产品设计师可以在本地继续建模,同时由服务器生成最终静帧或转台动画帧。渲染是指根据现有的 3D 场景计算最终图像,而不是根据文本提示凭空生成图像。您需要提供场景、材质、灯光和摄像机;工作节点负责计算出最终图像。
渲染后端将场景计算与 RTX 硬件加速相连接。您可以在无需交互式远程桌面的情况下运行后台渲染,让准备好的任务在服务器上生成输出文件。请单独选择 GPU 渲染;仅使用后台模式并不会选择渲染设备。
此流程需要兼容的 Blender 功能以及所有必需的资源:将纹理与项目一起打包,或确保其路径可在服务器上正确解析。对于很小的任务,上传和准备所需的时间可能超过带来的收益。受支持的显存回退机制可能有助于较大的场景放入显存,但会带来一定的性能折中。
- 入门项目:将一个规模适中的产品场景渲染为最终静帧或短转台动画。在将所有任务加入队列之前,先检查一个代表性帧的纹理、材质、灯光和构图。
- 示例方案:使用 Blender Cycles 进行场景渲染;使用 NVIDIA OptiX 进行 GPU 加速;通过后台执行生成输出文件,无需交互式远程桌面。
- 主要限制:场景和纹理的显存占用决定能否容纳。在此硬件上,多块显卡通常不会合并使用场景显存。
8. 将小型模型适配到一个可重复的任务
进阶内容。您可以将小型模型适配为把支持请求归入现有类别:账单、账户访问或技术问题。可以把它想象成对员工进行某项狭窄流程的培训,而不是从零开始教育他。交付物是一个适配器加上评估证据,而不是无人值守的工单操作。
QLoRA 在训练时保持量化后的基础模型基本固定,同时训练称为适配器的小型附加组件。这不是基础模型训练,也不是全权重微调。GPU 负责训练;服务器提供一个隔离、可重复的任务,并存储其产物。其他单卡工作负载应单独安排。
应从受支持的小型文本模型训练方案开始,而不是之前的 Ollama 推理包。根据 Unsloth 的要求,约 30 亿至 80 亿参数的受支持模型是起步候选。较短的序列和较小的批次有助于控制内存占用,但并非每个模型或方案都能在 16 GB 中运行。应先尝试提示词;对于会变化的事实,请使用检索。
- 入门项目:在同一批保留的请求上比较原始模型、强提示词版本和适配版本,这些请求不包含在训练样本中。检查类别选择和失败案例。
- 示例技术栈:Unsloth 记录的训练路线,使用较早的 Qwen2.5-7B-Instruct 文本模型,采用兼容的 4-bit 方案;包括带标签的支持样本以及用于类别预测的评估代码。
- 主要限制:数据质量和评估决定适配是否有帮助。训练完成并不能证明模型已经改进。
除 GPU 之外,您的项目还需要什么
确定项目后,就要规划配套的服务器。如果把显存比作工作台,那么系统内存就是旁边的暂存空间,用于应用程序和数据准备。CPU 容量要满足解析及其他配套应用工作的需求。NVMe SSD 存储则是存放活跃模型和素材的仓库。
增加存储并不能扩大 GPU 显存;将工作转移到系统内存中,可以帮助支持的应用程序容纳工作负载,但会带来性能开销。请同时查看所选软件的硬件要求,并结合这些资源进行评估。
AlexHost 列出了单卡和双卡配置,其中包括搭配 16 GB GPU 显存、64 GB 内存和 1 TB NVMe 的单张 RTX 4070 Ti SUPER。这只是将显卡与配套应用资源搭配的一个示例。
当工作负载增长时,需要区分是排队时间变长,还是任务已经无法放入现有资源。另一块 GPU 可以处理相互独立的任务。而更大的模型或场景则可能需要单卡有更多显存。部分模型服务应用可以将任务拆分到多块显卡上,但会产生通信开销;让多个独立工作进程各自运行则是更简单的方案:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
除模型权重外,还要为上下文和临时计算预留空间。更高的图像分辨率和同时处理的请求数量也会增加内存需求。Ollama 的内存指南解释了为什么下载大小并不等于峰值内存占用。在单张显卡上,排队执行任务或分开安排运行时间,可以防止相互竞争的模型耗尽显存。
📝 注意:以下为概念性分配方案,并非服务商承诺的实际布局:两块独立的 16 GB GPU 合计提供 32 GB,但这并不会自动形成一个 32 GB 的分配空间。受支持的模型拆分是一项独立的软件功能,而不是自动的内存池化。
录制素材库需要存储空间和备份,而频繁的数据传输使带宽也成为规划时必须考虑的因素。对于对外开放的服务,请使用身份验证,并将访问权限限制给预期用户。维护负责人必须保持服务更新,并检查外部处理路径。该负责人还需要决定日志和备份的保留时长。
经常性的工作可以证明专用资源是值得的;而偶尔使用的情况则可能更适合通过 API 或按需租用的方式解决。请权衡运营应用程序所需的精力与租赁成本。
选择一个实用的首个项目
将你需要的输出与一个可以检验的小项目相匹配:
| 你的目标 | 起始项目 | 主要限制 |
|---|---|---|
| 📚 基于内部文档的答案 | 一个精心整理的入职资料集 | 检索质量和权限 |
| 🎨 营销活动图像构思 | 一张自有产品照片的变体 | 产品准确性和版权 |
| 🎙️可读、可搜索的录音 | 经过审校的文字稿和字幕 | 音频质量和校正 |
| 💻 编辑器内的帮助 | 一个模块的测试草稿 | 上下文和代码审查 |
| 🧾 结构化发票记录 | 将一类发票整理到审核电子表格中 | 字段验证和审批 |
| 🎬 可直接交付的视频 | 一段录制内容的两种分辨率版本 | 编解码器支持和处理能力 |
| 🧊 完成的 3D 视觉效果 | 一个小型产品渲染任务 | 场景内存和资产传输 |
| 🧠 一致的模型行为——进阶 | 针对支持类别的适配器 | 训练数据和留出评估 |
对于拥有文档的团队,知识助手是一个易于上手的起点。视觉创作者可以从图像编辑开始,而拥有录音库的人可以从转录入手。请使用你拥有或已获得使用许可的输入来选择一个交付物。让成功标准具体化:一个有正确段落作为依据的答案,或者与录音内容同步的字幕。
如果远程托管适合你的选择,AlexHost 的 GPU 服务器产品提供了多种配置,可与你选定的项目进行对比。然后构建能产生有用结果的最小版本。你的第一个里程碑是一个可以使用的成品输出,而不是一台堆满半成品应用的服务器。