Billete abierto
 +373 79 600002
 Chat en directo de Telegram
 F.A.Q
 Español
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)


 en todos los servicios de hosting


Mejores casos de uso del servidor RTX 4070 Ti SUPER en 2026
Tus documentos de incorporación podrían convertirse en respuestas con enlaces a sus fuentes. Una foto de producto propia podría convertirse en conceptos de fondo para campañas. Una escena 3D existente podría convertirse en visuales de producto terminados, todo sin tener que mantener un portátil ocupado. Estos son tres casos de uso prácticos para un servidor con RTX 4070 Ti SUPER: trabajos concretos con resultados reconocibles.
Las ocho opciones que aparecen a continuación son alternativas, no aplicaciones para cargar en conjunto. Aquí, “mejor” significa resultados útiles con una ruta de software realista, no una clasificación de benchmarks. Los modelos compactos de imagen y texto y los flujos de trabajo de edición amplían las opciones en 2026; la codificación y el renderizado también siguen siendo útiles. Elija un servicio concreto o un worker en cola que pueda seguir funcionando de forma independiente de su portátil.
La frontera útil: 16 GB de espacio de trabajo rápido
La RTX 4070 Ti SUPER tiene 16 GB de VRAM: la memoria de trabajo de la GPU. Es su banco de trabajo para modelos y escenas, por lo que los proyectos siguientes usan modelos más pequeños y trabajos acotados. El software compatible de NVIDIA se encarga de la IA y el renderizado; el hardware dedicado de codificación de vídeo respalda el trabajo multimedia. Estos son puntos de partida respaldados por la documentación, no pruebas de rendimiento de despliegue. Cada uno asume una tarjeta adecuadamente configurada.
1. Pregunte a sus propios documentos, no a toda la internet
Un nuevo compañero de equipo pregunta qué lista de verificación de incorporación se aplica a su puesto. En lugar de buscar en carpetas, recibe un borrador de respuesta vinculado a archivos o manuales de incorporación aprobados. Con el modelo alojado de forma remota en un servidor propio y el acceso del equipo controlado, esto puede convertirse en un servicio privado de conocimiento.
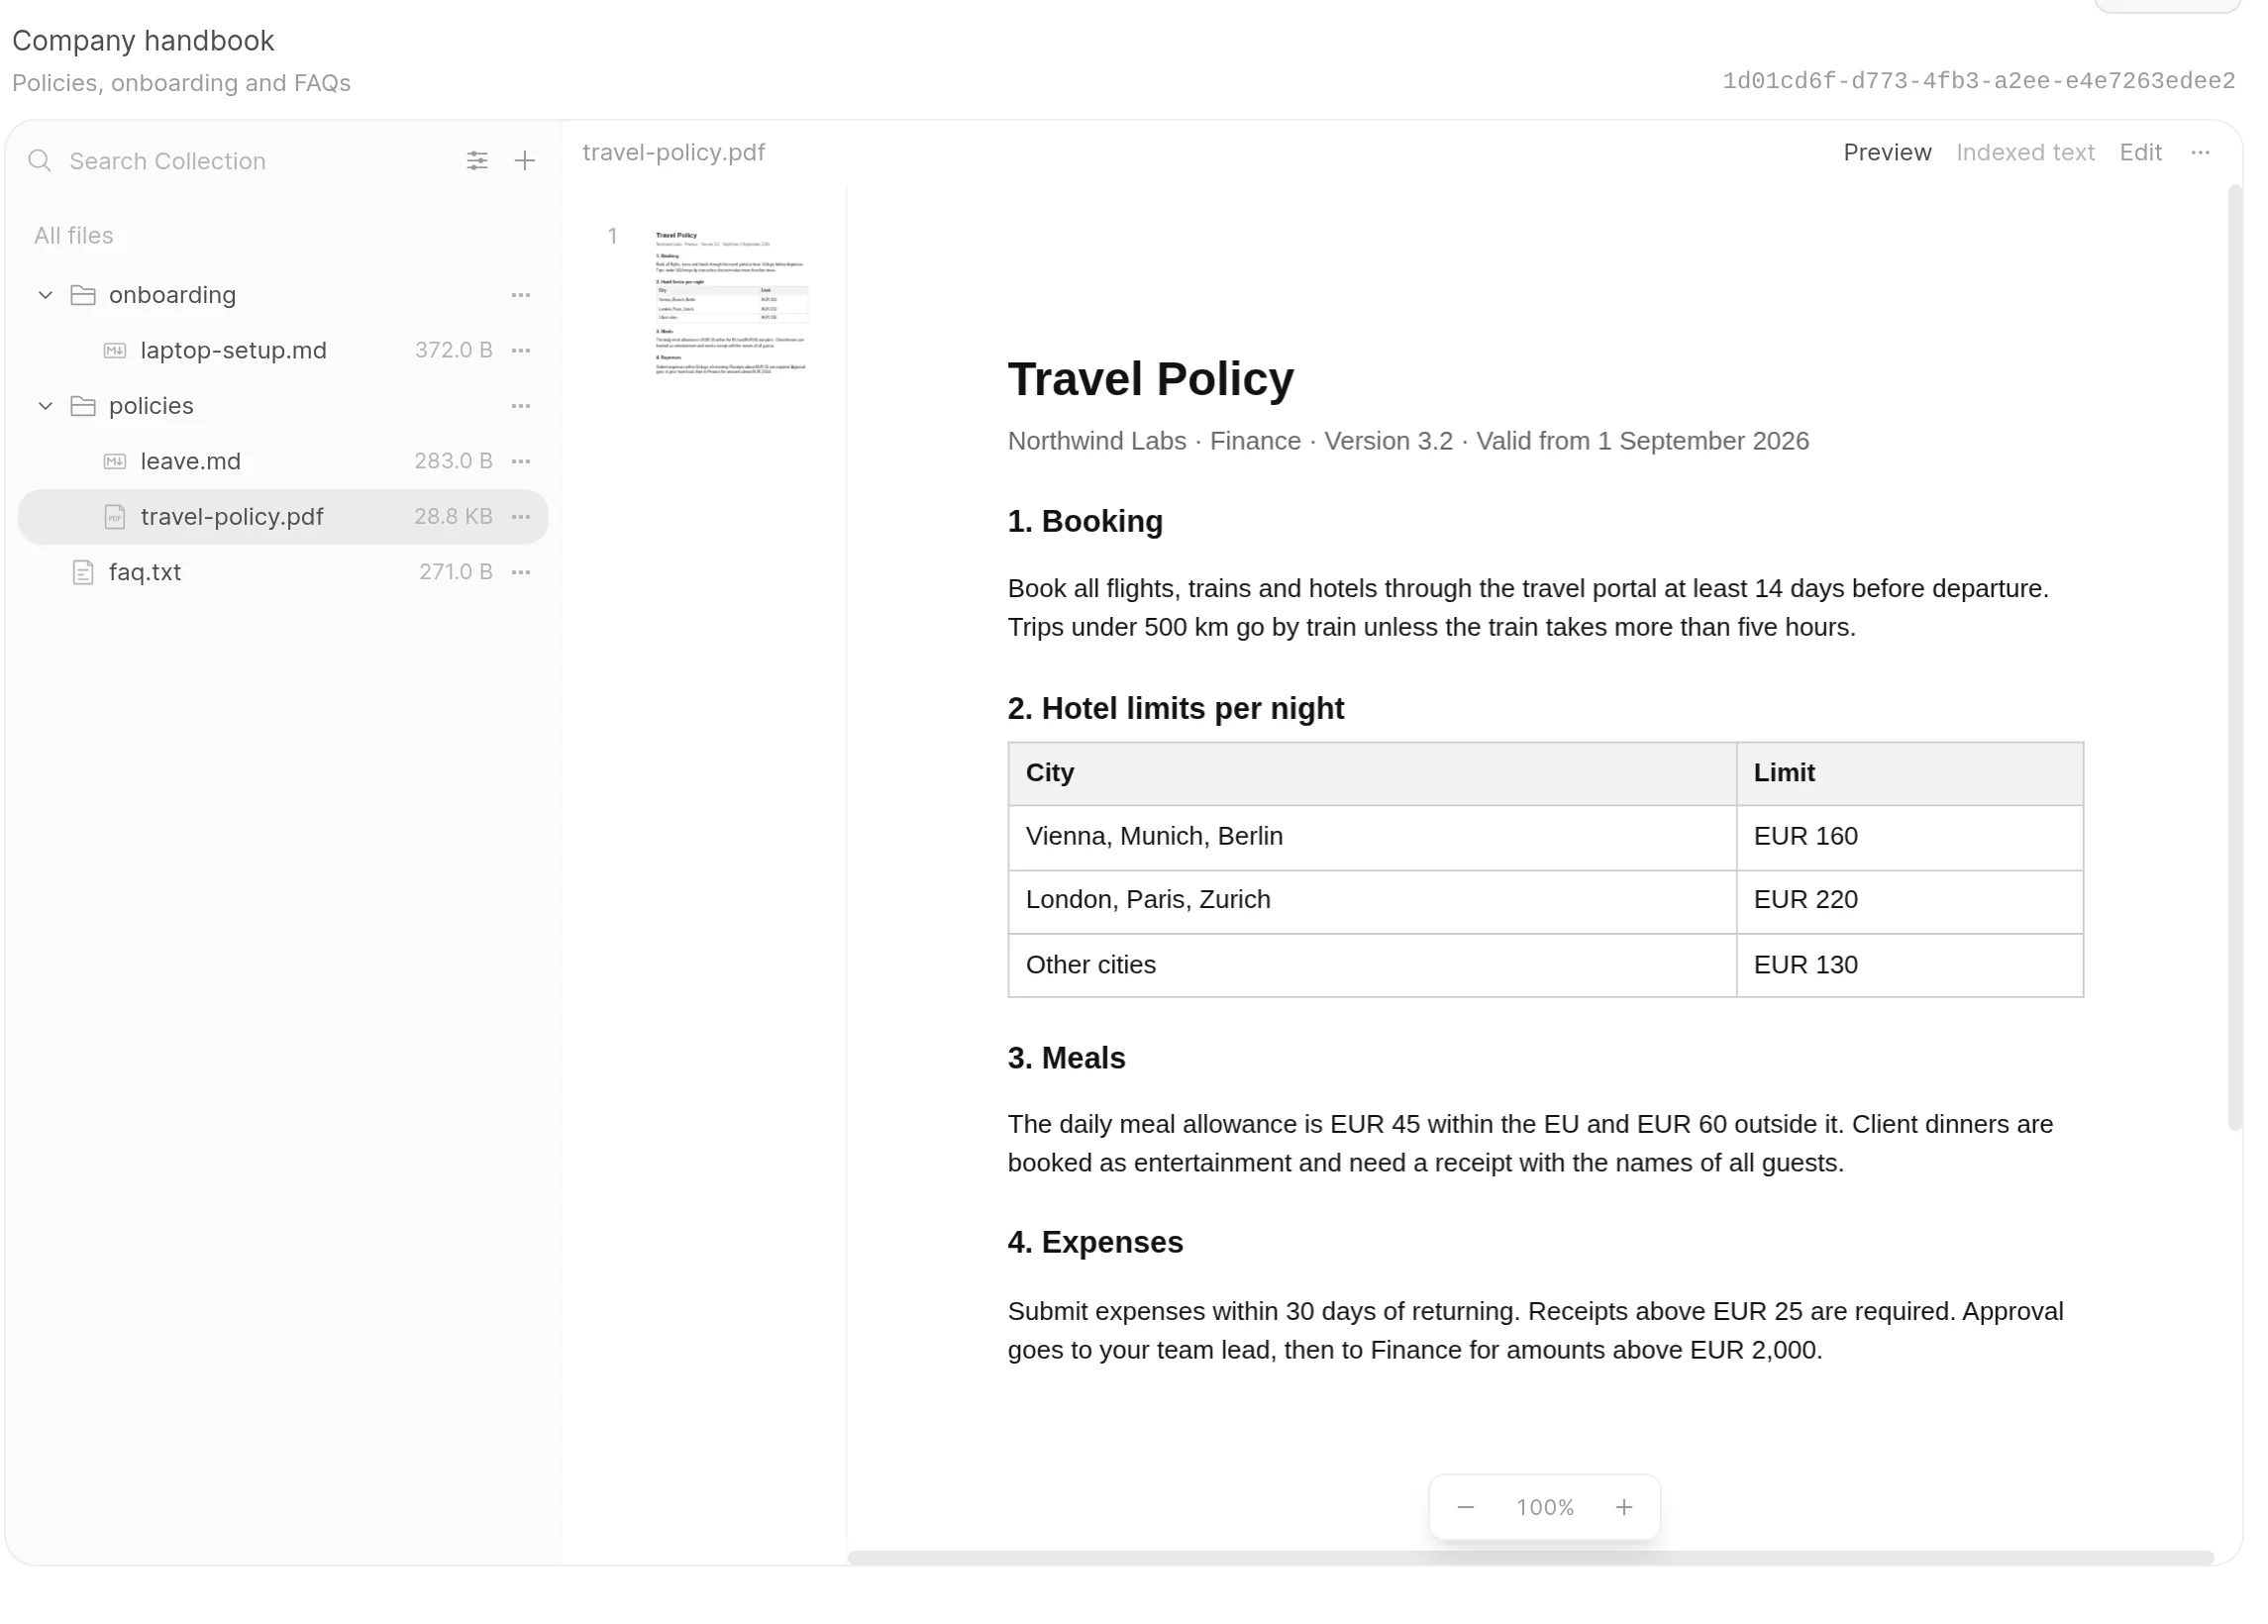
La generación aumentada por recuperación, o RAG, funciona como un asistente de libro abierto: el software encuentra los pasajes relevantes y se los entrega al modelo antes de que responda. Los embeddings permiten buscar pasajes por significado y no solo por coincidencia exacta de palabras. Subir documentos no reentrena el modelo; la respuesta depende del material recuperado para esa pregunta.
📝 Nota: La inferencia privada significa que el modelo se ejecuta en el servidor remoto, no que todos los componentes sean privados. Verifique dónde se ejecutan los embeddings y el análisis de documentos. También hay que revisar los registros y los respaldos externos. Alojar en un servidor remoto sigue implicando una relación de confianza con el proveedor.
La GPU acelera principalmente la inferencia: el uso de un modelo ya entrenado para generar la respuesta. Un modelo cuantizado almacena sus números con menos bits, lo que ahorra memoria con posibles compromisos de calidad. La pregunta y los pasajes recuperados forman parte de su contexto, es decir, la información que el modelo mantiene presente para una solicitud. La coincidencia de pasajes puede usar un componente pequeño alojado por usted; almacenar y buscar archivos no requiere necesariamente otro servicio grande con GPU.
- Proyecto inicial: Una colección de incorporación y preguntas con respuesta conocida. Compare las respuestas con los pasajes citados; incluya una pregunta sin respuesta para comprobar si el asistente reconoce la información faltante.
- Pila de ejemplo: Open WebUI para documentos y recuperación; embeddings alojados por usted para la coincidencia de pasajes; Ollama ejecutando Qwen3.5-4B cuantizado para respuestas en el servidor.
- Limitación principal: La calidad de la recuperación y los permisos determinan qué llega al modelo. Las citas ayudan a verificar las respuestas; no certifican que sean verdaderas.
2. Dar a un equipo su propio estudio de generación y edición de imágenes
Una pequeña tienda posee una foto de producto y necesita conceptos de fondo para campañas: un fondo de estudio, un escenario de temporada, una paleta de colores diferente. El resultado es un conjunto de borradores para que alguien los seleccione y refine, un primer objetivo más manejable que reemplazar la fotografía de producto.
El flujo de trabajo visual conecta estaciones de procesamiento, llamadas nodos, que cargan una imagen de referencia, aplican instrucciones y guardan los resultados. La GPU ejecuta el modelo de imágenes para convertir la foto y el prompt en una variación. Guardar ese flujo de trabajo le da al equipo un punto de partida repetible para el siguiente conjunto de conceptos.
Los miembros del equipo pueden enviar trabajos a una cola de servidor compartida en lugar de reconstruir la configuración en computadoras de escritorio individuales. El modelo propuesto FLUX.2 [klein] 4B utiliza la licencia Apache-2.0, que permite el uso comercial según sus condiciones. Esa licencia se aplica a esta variante, no a todos los modelos FLUX; los derechos sobre las imágenes siguen siendo importantes.
- Proyecto inicial: Crear algunas variaciones de fondo para una imagen de producto propia. Comparar la forma, el texto del empaque, los logotipos y la coherencia de marca con el original antes de usarlas.
- Pila de ejemplo: ComfyUI para el flujo de trabajo visual guardado y la cola de trabajos; FLUX.2 [klein] 4B destilado para la generación y la edición con imagen de referencia en la GPU.
- Limitación principal: Una imagen convincente aún puede cambiar el producto o su texto. Trate los resultados como conceptos que requieren revisión de precisión y de derechos.
3. Превращение записей в транскрипты, субтитры и поисковые знания
Ошибка: текст на английском, переводить нужно на испанский. Исправлю ниже.
3. Convertir grabaciones en transcripciones, subtítulos y conocimiento con búsqueda
Su seminario web o una reunión grabada con el consentimiento correspondiente puede contener información que luego es difícil de encontrar. Un proceso de transcripción convierte el contenido en texto con marcas de tiempo y en archivos de subtítulos. Organice las transcripciones revisadas, y la búsqueda de texto habitual le ayudará a localizar un tema sin volver a reproducir cada grabación.

El modelo de voz primero genera segmentos de transcripción con marcas de tiempo. Un contenedor de exportación (código de aplicación que rodea la biblioteca de reconocimiento) los guarda después como texto legible y como archivos de subtítulos SRT o VTT. Esas marcas de tiempo vinculan las palabras con la grabación y proporcionan al exportador de subtítulos la información de sincronización.
Una carpeta de carga o una cola permite que el servidor procese una acumulación de grabaciones sin supervisión, con la GPU encargándose del reconocimiento de voz. Los resúmenes opcionales requieren otro modelo, preferiblemente programado por separado en la misma tarjeta. Las etiquetas de hablante necesitan una etapa independiente para distinguir a los hablantes; la transcripción por sí sola no las proporciona.
- Proyecto inicial: Procese varias grabaciones con permiso verificado para obtener transcripciones y subtítulos. Compare las muestras con el audio, revisando nombres, vocabulario técnico y la sincronización de los subtítulos.
- Pila de ejemplo: faster-whisper con large-v3 y configuraciones de GPU de precisión reducida adecuadas; una cola de carga; un contenedor de exportación para archivos de subtítulos y almacenamiento de transcripciones con búsqueda.
- Límite principal: La calidad del audio determina la carga de corrección. El ruido, los acentos, los términos desconocidos y los hablantes superpuestos pueden dejar errores que requieren revisión humana.
4. Conecta un asistente de programación privado a tu editor
Selecciona una función en tu editor y pide pruebas, una explicación o una pequeña refactorización. Obtendrás código de borrador junto a la función en la que estás trabajando. Tu editor y tus archivos de trabajo pueden permanecer en el portátil, mientras que el código seleccionado se envía al servidor para la inferencia.
El editor envía el código seleccionado y tu pregunta a un endpoint de modelo remoto, y luego muestra la respuesta en el espacio de trabajo de desarrollo. Incluir el comportamiento previsto de la función ayuda a que la solicitud sea concreta. En una tarea de escritura de pruebas, el resultado te ofrece un borrador con el que comparar ese comportamiento, en lugar de un archivo de pruebas en blanco.
La GPU se encarga de generar las respuestas, mientras que el servidor proporciona un endpoint reutilizable para las solicitudes del editor. Mantén el control sobre la ejecución y las ediciones arriesgadas, con permisos restringidos. El chat del editor es el flujo de trabajo inicial aquí; el autocompletado en línea con respuesta inmediata tiene requisitos de modelo y latencia diferentes.
- Proyecto inicial: Redacta pruebas para un módulo. Revísalas, ejecútalas en un entorno de desarrollo controlado y verifica el comportamiento previsto, no solo si compilan.
- Pila de ejemplo: Continúa con el chat del editor y las ediciones propuestas; un endpoint controlado de Ollama que ejecuta Qwen3.5-4B cuantizado en el servidor para la generación de respuestas.
- Limitación principal: La calidad de los modelos pequeños, el contexto de código limitado y la latencia de red restringen la ayuda. Esto no sustituye a los sistemas comerciales de programación más grandes.
5. Convertir facturas y escaneos en registros estructurados
Las imágenes de facturas pueden convertirse en campos propuestos de proveedor, fecha, número de factura y total en una hoja de cálculo de revisión. Vincular cada fila con su documento original facilita la comparación. La ventaja práctica es un conjunto coherente de registros que alguien puede verificar y trasladar al siguiente proceso de negocio.

Un modelo de visión y lenguaje acepta imágenes además de texto. Prepare una imagen de página a la vez y luego solicite los campos que necesita. Así, la GPU resulta útil para la interpretación visual, en lugar de asumir que el modelo puede analizar cualquier tipo de PDF. Los PDF limpios y basados en texto pueden necesitar solo un análisis convencional, sin intervención de la GPU.
Tras la extracción, el código de aplicación habitual comprueba que los valores obligatorios estén presentes y que las fechas y los números tengan los formatos esperados. También puede verificar la aritmética cuando esté disponible y buscar identificadores de factura duplicados. Los campos que falten o sean inciertos permanecen marcados. El servidor reúne los resultados del lote y sus fuentes para la entrega a revisión:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Los campos extraídos son propuestas hasta que se completen las comprobaciones habituales y la revisión humana; solo entonces deben convertirse en registros aprobados.
- Proyecto inicial: Convierta una familia de facturas en una hoja de cálculo de revisión con referencias a las fuentes. Compare cada campo seleccionado con el original antes de aceptar la fila.
- Pila de ejemplo: Preparación de imágenes de página; Ollama con Qwen3.5-4B para la extracción visual; código de validación/exportación habitual y un paso de revisión para producir registros de hoja de cálculo aprobados con referencias a las fuentes.
- Limitación principal: Los valores plausibles pueden ser incorrectos. Exija aprobación humana antes de registrarlos en contabilidad o de realizar cualquier pago.
6. Preparar el video subido para distintos espectadores
Una lección o una demostración de producto puede necesitar varias versiones de entrega, no nuevas grabaciones. La transcodificación convierte video ya codificado. Un master adecuado puede convertirse en copias de 1080p y 720p para distintas pantallas y conexiones. Reducir la resolución puede ayudar a la entrega; aumentarla no puede recuperar detalles perdidos.
NVENC es el codificador de video especializado de NVIDIA, separado del cálculo de modelos de lenguaje. Un códec es la tecnología que se usa para codificar y decodificar video. H.264 es una opción de partida ampliamente compatible; AV1 es otra opción cuando los dispositivos de reproducción de destino la admiten. La decodificación y el escalado pueden implicar otro hardware de GPU o la CPU.
El servidor puede aplicar configuraciones de conversión coherentes a las subidas en cola y almacenar las copias de entrega por separado del master. El hardware multimedia se encarga de la codificación compatible, pero la configuración sigue influyendo en el resultado. Elija la codificación por hardware por rendimiento, no por mejoras de calidad garantizadas frente a la codificación por CPU.
- Proyecto inicial: Convierta una grabación propia en versiones de 1080p y 720p. Compruebe la reproducción en los dispositivos previstos, la sincronización del sonido, la legibilidad del contenido y los tamaños de archivo.
- Pila de ejemplo: FFmpeg para la conversión con codificación compatible con NVIDIA; una cola de subida sencilla para programar los trabajos y un almacenamiento para los archivos de origen y las versiones de entrega terminadas.
- Límite principal: La capacidad depende de los códecs, la configuración, las restricciones de sesiones del controlador, la actividad del disco y el ancho de banda de transferencia, no solo de la memoria de la GPU.
7. Envío de renders de Blender a un worker GPU remoto
Un diseñador de producto puede seguir modelando localmente mientras un servidor produce imágenes fijas finales o fotogramas de turntable. Renderizado significa calcular imágenes finales a partir de una escena 3D existente, no inventar una imagen a partir de un texto. Tú proporcionas la escena, los materiales, la iluminación y la cámara; el worker calcula las imágenes terminadas.
El backend de renderizado conecta los cálculos de la escena con la aceleración por hardware RTX. Puedes ejecutar el renderizado en segundo plano sin un escritorio remoto interactivo, de modo que el trabajo preparado genera los archivos de salida en el servidor. Selecciona el renderizado por GPU por separado; el modo en segundo plano por sí solo no elige el dispositivo de renderizado.
El traspaso necesita funciones compatibles de Blender y todos los recursos requeridos: incluye las texturas en el proyecto o asegúrate de que sus rutas se resuelvan en el servidor. El tiempo de carga y preparación puede superar el beneficio en trabajos muy pequeños. El respaldo de memoria compatible puede ayudar a que escenas más grandes quepan, con una compensación en el rendimiento.
- Proyecto inicial: Renderiza una escena de producto modesta en imágenes fijas finales o en un turntable corto. Revisa las texturas, materiales, iluminación y encuadre de un fotograma representativo antes de encolar todo.
- Stack de ejemplo: Blender Cycles para el renderizado de la escena; NVIDIA OptiX para la aceleración por GPU; ejecución en segundo plano para generar archivos de salida sin requerir un escritorio remoto interactivo.
- Límite principal: La memoria de la escena y de las texturas determina si cabe. Varias tarjetas normalmente no combinan la memoria de la escena en este hardware.
8. Ajustar un modelo pequeño a una tarea repetible
Más avanzado. Podrías ajustar un modelo pequeño para clasificar las solicitudes de soporte en categorías existentes: facturación, acceso a la cuenta o problemas técnicos. Piensa en entrenar a un empleado en un procedimiento específico, no en formarlo desde cero. El entregable es un adaptador junto con evidencia de evaluación, no acciones automáticas sobre los tickets sin supervisión.
QLoRA mantiene en gran medida fijo un modelo base cuantizado mientras entrena pequeños componentes añadidos llamados adaptadores. No se trata del entrenamiento de un modelo fundacional ni de un ajuste fino de todos los pesos. La GPU realiza el entrenamiento; un servidor proporciona un trabajo aislado y repetible y almacena sus artefactos. Programa las demás cargas de trabajo de una sola tarjeta por separado.
Empieza con una receta de entrenamiento compatible para modelos de texto pequeños en lugar del paquete de inferencia de Ollama utilizado anteriormente. Según los requisitos de Unsloth, los modelos compatibles de aproximadamente tres a ocho mil millones de parámetros son candidatos iniciales. Las secuencias cortas y los lotes pequeños ayudan a controlar el uso de memoria, pero no todos los modelos ni todas las recetas cabrán en 16 GB. Prueba primero con prompts; utiliza recuperación de información para datos que cambian.
- Proyecto inicial: Compara el modelo original, una versión con un prompt sólido y una versión adaptada con las mismas solicitudes de prueba reservadas, es decir, ejemplos excluidos del entrenamiento. Revisa las categorías elegidas y los fallos.
- Stack de ejemplo: La ruta de entrenamiento documentada por Unsloth, que usa el modelo de texto Qwen2.5-7B-Instruct, más antiguo, en una receta compatible de 4 bits; ejemplos de soporte etiquetados y código de evaluación para las predicciones de categoría.
- Límite principal: La calidad de los datos y la evaluación determinan si la adaptación ayudó. Terminar el entrenamiento no demuestra una mejora.
Lo que tu proyecto necesita además de la GPU
Una vez que tengas un proyecto en mente, dimensiona el servidor que lo rodea. Si la VRAM es la mesa de trabajo, la RAM del sistema es el espacio auxiliar cercano para la aplicación y la preparación de datos. Elige la capacidad de CPU para el análisis y otras tareas de la aplicación. El almacenamiento NVMe SSD es el almacén de los modelos y recursos activos.
Más almacenamiento no amplía la memoria de la GPU; trasladar trabajo a la RAM del sistema puede ayudar a que las aplicaciones compatibles quepan, con una sobrecarga de rendimiento. Revisa los requisitos de hardware del software que elijas junto con estos recursos.
AlexHost ofrece configuraciones de una y dos tarjetas, incluida una sola RTX 4070 Ti SUPER con 16 GB de memoria GPU, 64 GB de RAM y 1 TB de NVMe. Este es un ejemplo de combinar la tarjeta con los recursos para la aplicación que la rodea.
Cuando la carga de trabajo crece, distingue entre una cola más larga y un trabajo que ya no cabe. Otra GPU puede manejar trabajos independientes. Un modelo o una escena más grandes pueden requerir, en cambio, más memoria por tarjeta. Algunas aplicaciones de servicio de modelos pueden dividir un trabajo entre varias tarjetas, con una sobrecarga de comunicación; los workers independientes son la opción más sencilla:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Deja espacio, además de los pesos del modelo, para el contexto y los cálculos temporales. Una mayor resolución de imagen y las solicitudes simultáneas también pueden aumentar las necesidades de memoria. La guía de memoria de Ollama explica por qué el tamaño de la descarga no es el uso máximo de memoria. En una sola tarjeta, las tareas en cola o los horarios separados pueden evitar que modelos que compiten entre sí agoten la memoria.
📝 Nota:Asignaciones conceptuales, no una distribución de proveedor garantizada: dos GPU separadas de 16 GB proporcionan 32 GB en conjunto, no una asignación automática de 32 GB. La división de modelos compatible es una función de software independiente, no una agrupación automática de memoria.
Las bibliotecas de grabaciones necesitan almacenamiento y copias de seguridad, mientras que las transferencias frecuentes hacen que el ancho de banda forme parte de la decisión de dimensionamiento. Para un servicio expuesto, usa autenticación y restringe el acceso a los usuarios previstos. Un responsable de mantenimiento debe mantenerlo actualizado y revisar las rutas de procesamiento externo. Ese responsable también debe decidir durante cuánto tiempo se conservan los registros y las copias de seguridad.
El trabajo recurrente puede justificar recursos dedicados; el uso esporádico podría encajar mejor con una API o con un alquiler ocasional. Sopesa el esfuerzo de operar la aplicación frente a los costes de alquiler.
Elija un primer proyecto útil
Relacione el resultado que necesita con un proyecto pequeño que pueda verificar:
| Su objetivo | Proyecto inicial | Restricción principal |
|---|---|---|
| 📚 Respuestas a partir de documentos internos | Una colección de incorporación seleccionada | Calidad de recuperación y permisos |
| 🎨 Conceptos de imagen para campañas | Variaciones de una foto de producto propia | Precisión del producto y derechos |
| 🎙️Grabaciones legibles y con búsqueda | Transcripción y subtítulos revisados | Calidad de audio y corrección |
| 💻 Ayuda dentro de su editor | Pruebas de borrador para un módulo | Contexto y revisión de código |
| 🧾 Registros de facturas estructurados | Una familia de facturas en una hoja de cálculo de revisión | Validación de campos y aprobación |
| 🎬 Video listo para entregar | Una grabación en dos resoluciones | Compatibilidad de códecs y capacidad del flujo de trabajo |
| 🧊 Visuales 3D terminados | Un pequeño trabajo de renderizado de producto | Memoria de escena y transferencia de activos |
| 🧠 Comportamiento coherente del modelo: avanzado | Un adaptador para categorías de soporte | Datos de entrenamiento y evaluación con datos reservados |
Para equipos con documentos, un asistente de conocimiento ofrece un punto de partida accesible. Los creadores visuales pueden empezar con la edición de imágenes, mientras que quienes tienen bibliotecas de grabaciones pueden empezar con la transcripción. Elija un entregable usando insumos que sean suyos o para los que tenga permiso de uso. Haga el éxito concreto: una respuesta respaldada por los pasajes correctos, o subtítulos que sigan la grabación.
Si el alojamiento remoto se ajusta a su elección, la oferta de servidores GPU de AlexHost le ofrece configuraciones para comparar con el proyecto que ha seleccionado. Luego, construya la versión más pequeña que produzca un resultado útil. Su primer hito es un resultado terminado que pueda usar, no un servidor lleno de aplicaciones a medio terminar.