Ticket öffnen
 +373 79 600002
 Telegramm Live Chat
 Häufige Fragen
 Deutsch
 English
 Русский
 Română
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)


 bei allen Hosting-Diensten


Beste Anwendungsfälle für RTX 4070 Ti SUPER Server im Jahr 2026
Ваши онбординг-документы могут превращаться в ответы со ссылками на источники. Владеемый вами фотопродукт может становиться концептами фоновых изображений для кампаний. Существующая 3D-сцена может превращаться в готовые визуалы продукта — и всё это без необходимости держать ноутбук занятым. Это три практичных сценария использования сервера с RTX 4070 Ti SUPER: целевые задачи с понятными результатами.
Восемь вариантов ниже являются альтернативами, а не приложениями для одновременной загрузки. Здесь «лучший» означает полезные результаты с реалистичным программным путём, а не рейтинг по бенчмаркам. Компактные модели для работы с изображениями и текстом и рабочие процессы редактирования расширяют набор возможностей в 2026 году; кодирование и рендеринг также остаются полезными. Выберите один целевой сервис или фоновый воркер, который сможет работать независимо от вашего ноутбука.
Die nützliche Grenze: 16 GB schneller Arbeitsspeicher
Die RTX 4070 Ti SUPER verfügt über 16 GB VRAM—den Arbeitsspeicher der GPU. Er ist die Werkbank für Modelle und Szenen, weshalb die unten genannten Projekte kleinere Modelle und begrenzte Aufgaben verwenden. Kompatible NVIDIA-Software übernimmt KI- und Rendering-Aufgaben; dedizierte Hardware für Videokodierung unterstützt Medienarbeiten. Dies sind dokumentationsgestützte Ausgangspunkte, keine Deployment-Benchmarks. Jede Angabe setzt eine passend konfigurierte Karte voraus.
1. Ask your own documents, not the whole internet
Ein neuer Teamkollege fragt, welche Onboarding-Checkliste für seine Rolle gilt. Anstatt Ordner zu durchsuchen, erhält er eine Antwortentwurf, der mit genehmigten Onboarding-Dateien oder Runbooks verknüpft ist. Da das Modell remote selbst gehostet wird und der Teamzugriff kontrolliert ist, kann daraus ein privater Wissensdienst entstehen.
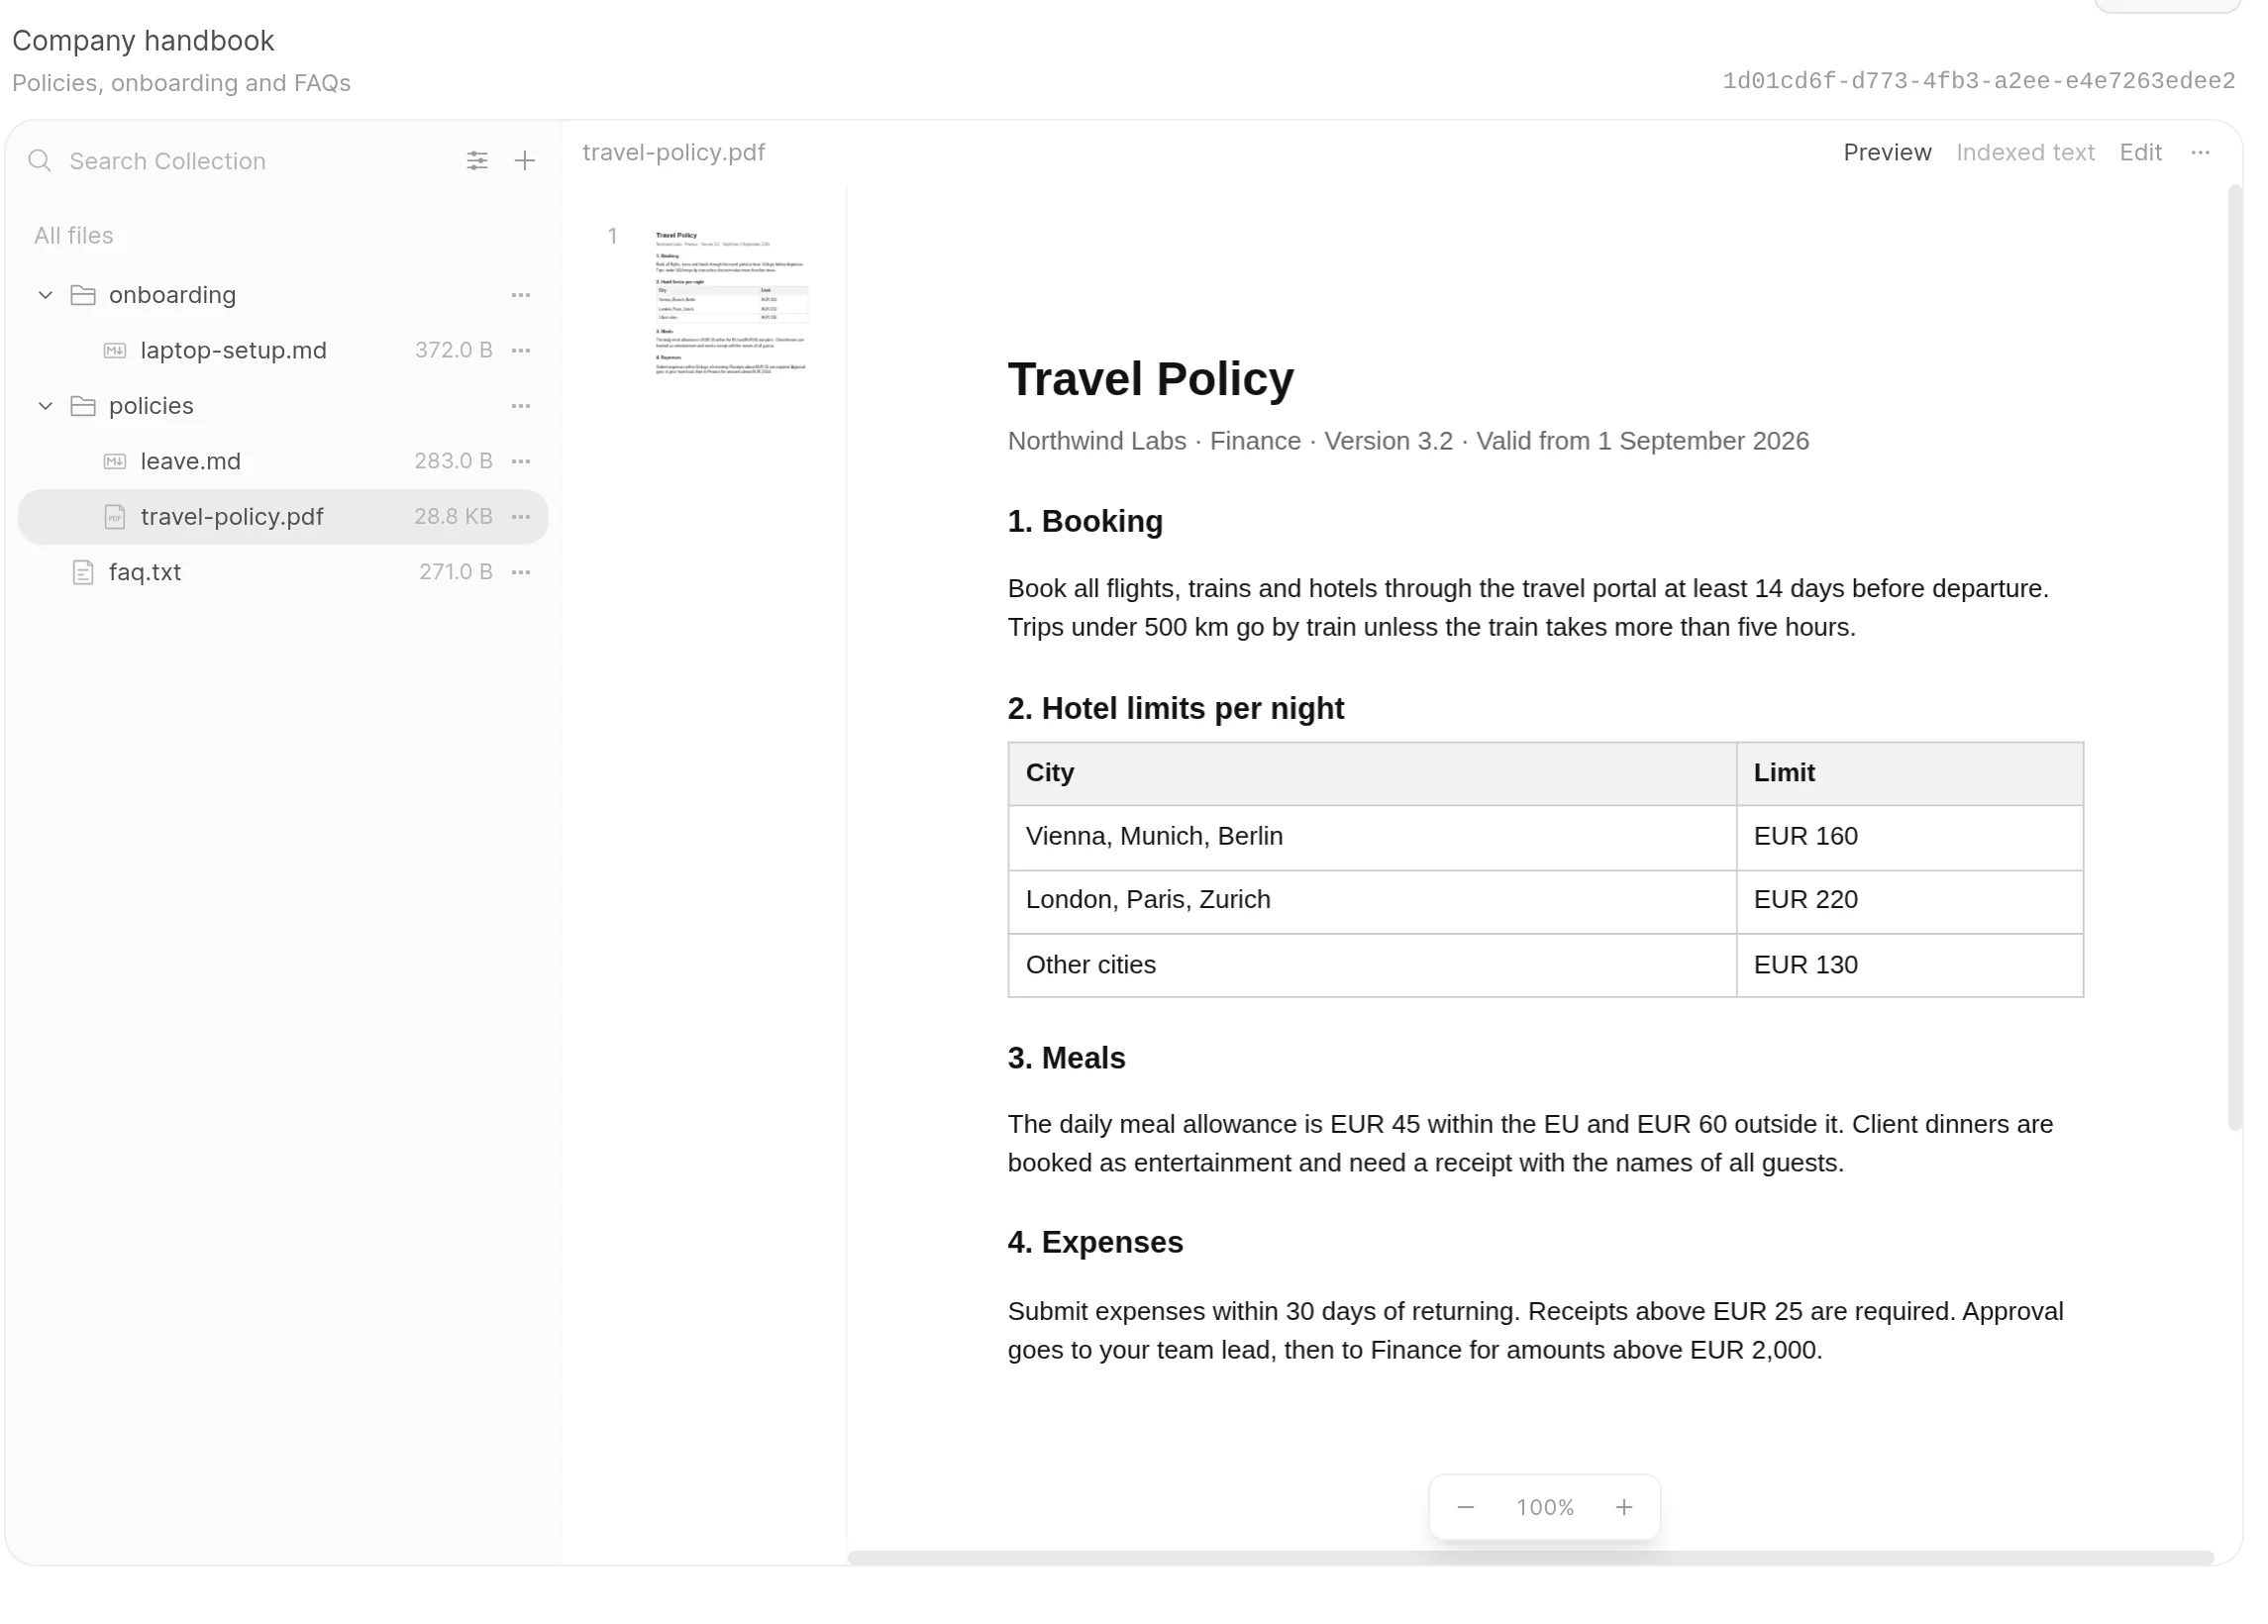
Retrieval-augmented Generation, kurz RAG, funktioniert wie ein Assistent mit offenem Buch: Software findet relevante Textpassagen und gibt sie dem Modell, bevor es antwortet. Embeddings machen Passagen nach Bedeutung durchsuchbar, nicht nur nach exakter Formulierung. Das Hochladen von Dokumenten trainiert das Modell nicht neu; die Antwort hängt vom Material ab, das für diese Frage abgerufen wurde.
📝 Hinweis: Private Inferenz bedeutet, dass das Modell auf dem Remote-Server läuft, nicht dass jede Komponente privat ist. Prüfen Sie, wo Embeddings und die Dokumentenverarbeitung ausgeführt werden. Logs und externe Fallbacks müssen ebenfalls geprüft werden. Remote-Hosting bleibt eine Vertrauensbeziehung mit dem Anbieter.
Die GPU beschleunigt vor allem die Inferenz: die Nutzung eines bereits trainierten Modells zur Erzeugung der Antwort. Ein quantisiertes Modell speichert seine Zahlen mit weniger Bits, was Speicher spart, aber möglicherweise Qualitätseinbußen mit sich bringt. Die Frage und die abgerufenen Passagen bilden Teil seines Kontexts, also der Informationen, die das Modell für eine Anfrage im Blick behält. Die Passagenzuordnung kann eine kleine selbst gehostete Komponente übernehmen; das Speichern und Durchsuchen von Dateien erfordert nicht zwingend einen weiteren großen GPU-Dienst.
- Einstiegsprojekt: Eine Onboarding-Sammlung und Fragen mit bekannten Antworten. Prüfen Sie die Antworten anhand der zitierten Passagen; nehmen Sie eine unbeantwortbare Frage auf, um zu sehen, ob der Assistent fehlende Informationen erkennt.
- Beispiel-Stack: Open WebUI für Dokumente und Retrieval; selbst gehostete Embeddings für die Passagenzuordnung; Ollama, das das quantisierte Qwen3.5-4B serverseitig für Antworten ausführt.
- Hauptgrenze: Die Qualität des Retrievals und die Berechtigungen bestimmen, was das Modell erhält. Zitate helfen bei der Überprüfung von Antworten; sie garantieren jedoch keine Wahrheit.
2. Einem Team sein eigenes Studio für die Bilderzeugung und -bearbeitung geben
Ein kleiner Shop besitzt ein Produktfoto und benötigt Konzepte für Kampagnen-Hintergründe: einen Studiohintergrund, einen saisonalen Schauplatz oder eine andere Farbpalette. Das Ergebnis ist eine Reihe von Entwürfen, aus denen jemand auswählen und die er verfeinern kann. Das ist ein überschaubareres erstes Ziel als der Ersatz von Produktfotografie.
Der visuelle Workflow verbindet Verarbeitungsstationen, sogenannte Nodes, die ein Referenzbild laden, Anweisungen anwenden und Ergebnisse speichern. Die GPU führt das Bildmodell aus, das das Foto und den Prompt in eine Variante umwandelt. Das Speichern dieses Workflows bietet dem Team einen wiederholbaren Ausgangspunkt für die nächste Reihe von Konzepten.
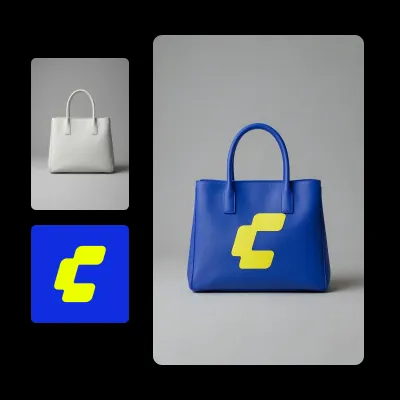
Teammitglieder können Aufträge an eine gemeinsame Server-Warteschlange senden, statt die Einrichtung auf einzelnen Desktops neu aufzubauen. Das vorgeschlagene FLUX.2 [klein] 4B-Modell nutzt die Apache-2.0-Lizenz, die eine kommerzielle Nutzung im Rahmen ihrer Bedingungen erlaubt. Diese Lizenz gilt für diese Variante, nicht für jedes FLUX-Modell; die Rechte an den Bildern bleiben dennoch wichtig.
- Einstiegsprojekt: Erstellen Sie einige Hintergrundvarianten für ein eigenes Produktbild. Vergleichen Sie Form, Verpackungstext, Logos und Markenkonsistenz mit dem Original, bevor Sie die Bilder verwenden.
- Beispiel-Stack: ComfyUI für den gespeicherten visuellen Workflow und die Auftragswarteschlange; destilliertes FLUX.2 [klein] 4B für die Generierung und die Bearbeitung von Referenzbildern auf der GPU.
- Hauptbeschränkung: Ein überzeugend wirkendes Bild kann das Produkt oder dessen Text dennoch verändern. Behandeln Sie die Ergebnisse als Konzepte, die eine Prüfung auf Genauigkeit und Rechte erfordern.
3. Преобразуйте записи в транскрипты, субтитры и поисковые знания
Ошибка: перевод должен быть на немецкий язык. Исправляю ниже.
3. Turn recordings into transcripts, subtitles, and searchable knowledge
Ich korrigiere mich: Die Anfrage verlangt eine Übersetzung ins Deutsche, daher folgt die deutsche Fassung.
3. Aufnahmen in Transkripte, Untertitel und durchsuchbares Wissen umwandeln
Ihr Webinar oder ein mit angemessener Einwilligung aufgezeichnetes Meeting kann Informationen enthalten, die später schwer zu finden sind. Ein Transkriptions-Worker wandelt sie in zeitgestempelten Text und Untertiteldateien um. Organisieren Sie die geprüften Transkripte, und eine einfache Textsuche hilft Ihnen, ein Thema zu finden, ohne jede Aufnahme erneut abzuspielen.

Das Spracherkennungsmodell erzeugt zunächst Transkriptsegmente mit Zeitstempeln. Ein Export-Wrapper, also Anwendungscode rund um die Erkennungsbibliothek, speichert diese anschließend als lesbaren Text sowie als SRT- oder VTT-Untertiteldateien. Die Zeitstempel verknüpfen die Wörter mit der Aufnahme und liefern dem Untertitel-Exporter die Timing-Informationen.
Eine Upload-Ablage oder Warteschlange lässt den Server einen Aufnahmestau ohne Aufsicht abarbeiten, wobei die GPU die Spracherkennung übernimmt. Optionale Zusammenfassungen benötigen ein weiteres Modell, das vorzugsweise separat auf einer Karte eingeplant wird. Sprecherkennzeichnungen erfordern eine eigene Stufe zur Unterscheidung der Sprecher; die Transkription allein liefert sie nicht.
- Einstiegsprojekt: Verarbeiten Sie mehrere Aufnahmen, für die die Berechtigung vorliegt, zu Transkripten und Untertiteln. Vergleichen Sie Stichproben mit dem Audio und prüfen Sie Namen, Fachvokabular und das Untertiming.
- Beispiel-Stack: faster-whisper mit large-v3 und geeigneten GPU-Einstellungen mit reduzierter Genauigkeit; eine Upload-Warteschlange; ein Export-Wrapper für Untertiteldateien und durchsuchbare Transkriptspeicherung.
- Hauptbeschränkung: Die Audioqualität bestimmt den Korrekturaufwand. Rauschen, Akzente, unbekannte Begriffe und überlappende Sprecher können Fehler hinterlassen, die manuell geprüft werden müssen.
4. Verbinden Sie einen privaten Coding-Assistenten mit Ihrem Editor
Wählen Sie eine Funktion in Ihrem Editor aus und bitten Sie um Tests, eine Erklärung oder ein kleines Refactoring. Sie erhalten Code-Entwürfe direkt neben der Funktion, an der Sie gerade arbeiten. Ihr Editor und Ihre Arbeitsdateien können auf dem Laptop bleiben, während der ausgewählte Code zur Inferenz an den Server gesendet wird.
Der Editor sendet den ausgewählten Code und Ihre Frage an einen entfernten Modell-Endpunkt und zeigt die Antwort anschließend im Entwicklungsarbeitsbereich an. Die Angabe des beabsichtigten Verhaltens der Funktion hilft, die Anfrage konkret zu machen. Bei einer Aufgabe zum Schreiben von Tests erhalten Sie so einen Entwurf, den Sie mit diesem Verhalten vergleichen können, statt einer leeren Testdatei.
Die GPU übernimmt die Generierung der Antworten, während der Server einen wiederverwendbaren Endpunkt für Editor-Anfragen bereitstellt. Behalten Sie Ausführung und riskante Änderungen unter Ihrer Kontrolle, mit eingeschränkten Berechtigungen. Der Editor-Chat ist hier der Einstiegsworkflow; reaktionsschnelle Inline-Autovervollständigung hat andere Anforderungen an Modell und Latenz.
- Starterprojekt: Entwerfen Sie Tests für ein Modul. Prüfen Sie diese, führen Sie sie in einer kontrollierten Entwicklungsumgebung aus und überprüfen Sie das beabsichtigte Verhalten – nicht nur, ob sie kompilieren.
- Beispiel-Stack: Weiter für Editor-Chat und vorgeschlagene Änderungen; ein kontrollierter Ollama-Endpunkt mit quantisiertem Qwen3.5-4B auf dem Server zur Antwortgenerierung.
- Haupteinschränkung: Die Qualität kleiner Modelle, begrenzter Code-Kontext und Netzwerklatenz schränken die Hilfe ein. Dies ist kein Ersatz für die größten kommerziellen Coding-Systeme.
5. Rechnungen und Scans in strukturierte Datensätze umwandeln
Rechnungsbilder können in einer Prüftabelle als vorgeschlagene Felder für Lieferant, Datum, Rechnungsnummer und Gesamtbetrag erfasst werden. Wenn jede Zeile mit dem Originaldokument verknüpft ist, lässt sich der Vergleich unkompliziert durchführen. Der praktische Nutzen liegt in einem einheitlichen Satz von Datensätzen, den jemand prüfen und an den nächsten Geschäftsprozess weitergeben kann.

Ein Vision-Language-Modell verarbeitet neben Text auch Bilder. Bereiten Sie jeweils eine Seite als Bild vor und fordern Sie anschließend die benötigten Felder an. So wird die GPU für die visuelle Interpretation genutzt, ohne dass angenommen werden muss, das Modell könne jeden PDF-Typ auslesen. Saubere, textbasierte PDFs benötigen unter Umständen nur eine gewöhnliche Verarbeitung ohne GPU.
Nach der Extraktion prüft gewöhnlicher Anwendungscode, ob erforderliche Werte vorhanden sind und ob Datums- und Zahlenangaben dem erwarteten Format entsprechen. Wo möglich, kann er außerdem die Rechenlogik kontrollieren und nach doppelten Rechnungskennungen suchen. Fehlende oder unsichere Felder bleiben markiert. Der Server führt die Batch-Ergebnisse und ihre Quellen für die Übergabe zur Prüfung zusammen:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Extrahierte Felder sind Vorschläge, bis die gewöhnlichen Prüfungen und die menschliche Kontrolle abgeschlossen sind; erst danach sollten sie zu genehmigten Datensätzen werden.
- Einstiegsprojekt: Wandeln Sie eine Rechnungsart in eine Prüftabelle mit Quellenverweisen um. Vergleichen Sie jedes ausgewählte Feld mit dem Original, bevor Sie die Zeile übernehmen.
- Beispiel-Stack: Aufbereitung der Seitenbilder; Ollama mit Qwen3.5-4B für die visuelle Extraktion; gewöhnlicher Validierungs- und Exportcode sowie ein Prüfschritt, um genehmigte Tabellendatensätze mit Quellenverweisen zu erstellen.
- Hauptgrenze: Plausibel wirkende Werte können falsch sein. Vor der Buchung oder Zahlung ist eine menschliche Freigabe erforderlich.
6. Videoinhalte für unterschiedliche Zuschauer bereitstellen
Eine Lektion oder Produktdemonstration benötigt womöglich mehrere Auslieferungsversionen, nicht neues Material. Transcodierung wandelt vorhandenes kodiertes Video um. Ein geeignetes Master kann zu 1080p- und 720p-Kopien für unterschiedliche Bildschirme und Verbindungen werden. Eine geringere Auflösung kann die Auslieferung erleichtern; eine Erhöhung kann fehlende Details nicht wiederherstellen.
NVENC ist der spezialisierte Videoencoder von NVIDIA, getrennt von der Berechnung von Sprachmodellen. Ein Codec ist die Technologie, mit der Video kodiert und dekodiert wird. H.264 ist eine breit kompatible Ausgangswahl; AV1 ist eine weitere Option, wenn Ihre Wiedergabegeräte es unterstützen. Dekodierung und Skalierung können andere GPU-Hardware oder die CPU einbeziehen.
Der Server kann einheitliche Konvertierungseinstellungen auf eingereihte Uploads anwenden und Auslieferungskopien getrennt vom Master speichern. Medien-Hardware übernimmt die unterstützte Kodierung, doch die Einstellungen bestimmen weiterhin das Ergebnis. Wählen Sie Hardware-Kodierung wegen des Durchsatzes, nicht wegen garantierter Qualitätsgewinne gegenüber der CPU-Kodierung.
- Einstiegsprojekt: Wandeln Sie eine eigene Aufnahme in 1080p- und 720p-Versionen um. Prüfen Sie die Wiedergabe auf den vorgesehenen Geräten, die Tonsynchronisation, die Lesbarkeit der Inhalte und die Dateigrößen.
- Beispiel-Stack: FFmpeg für die Konvertierung mit NVIDIA-unterstützter Kodierung; eine einfache Upload-Warteschlange zur Planung der Aufträge und Speicher für Quelldateien und fertige Auslieferungsversionen.
- Hauptbeschränkung: Die Kapazität hängt von Codecs, Einstellungen, Treibersitzungsbeschränkungen, Datenträgeraktivität und Übertragungsbandbreite ab – nicht allein vom GPU-Speicher.
7. Отправка рендеров Blender на удалённый GPU-воркер
Ошибка: язык должен быть немецкий, а не русский. Исправляю.
7. Blender-Renderings an einen entfernten GPU-Worker senden
Ein Produktdesigner kann weiterhin lokal modellieren, während ein Server die finalen Standbilder oder Turntable-Frames erzeugt. Rendering bedeutet, aus einer bestehenden 3D-Szene die fertigen Bilder zu berechnen, und nicht, ein Bild aus einem Textprompt zu erfinden. Sie liefern die Szene, Materialien, Beleuchtung und Kamera; der Worker berechnet die fertigen Bilder.
Das Rendering-Backend verbindet die Szenenberechnungen mit der RTX-Hardwarebeschleunigung. Sie können Hintergrund-Rendering ohne interaktiven Remote-Desktop ausführen, sodass der vorbereitete Auftrag Ausgabedateien auf dem Server erzeugt. Wählen Sie GPU-Rendering separat aus; der Hintergrundmodus allein bestimmt das Rendergerät nicht.
Die Übergabe benötigt kompatible Blender-Funktionen und alle erforderlichen Assets: Packen Sie Texturen mit dem Projekt oder stellen Sie sicher, dass ihre Pfade auf dem Server aufgelöst werden. Upload- und Vorbereitungszeit können den Nutzen bei sehr kleinen Aufträgen übersteigen. Ein unterstützter Speicher-Fallback kann helfen, größere Szenen unterzubringen, allerdings mit einem Leistungsnachteil.
- Starterprojekt: Rendern Sie eine überschaubare Produktszene zu finalen Standbildern oder einem kurzen Turntable. Prüfen Sie Texturen, Materialien, Beleuchtung und Bildausschnitt eines repräsentativen Frames, bevor Sie alles in die Warteschlange stellen.
- Beispiel-Stack: Blender Cycles für das Szenen-Rendering; NVIDIA OptiX für GPU-Beschleunigung; Hintergrundausführung, um Ausgabedateien ohne interaktiven Remote-Desktop zu erzeugen.
- Haupteinschränkung: Szenen- und Texturspeicher bestimmen, ob alles passt. Mehrere Karten kombinieren Szenenspeicher auf dieser Hardware in der Regel nicht.
8. Ein kleines Modell auf eine wiederholbare Aufgabe anpassen
Fortgeschritten. Man könnte ein kleines Modell so anpassen, dass es Supportanfragen in bestehende Kategorien einordnet: Abrechnung, Kontozugriff oder technische Probleme. Stellen Sie sich das eher vor wie das Einarbeiten eines Mitarbeiters in einen eng umrissenen Ablauf, nicht wie das Ausbilden von Grund auf. Das Ergebnis ist ein Adapter zusammen mit Evaluierungsnachweisen, nicht unbeaufsichtigte Aktionen an Tickets.
QLoRA hält ein quantisiertes Basismodell weitgehend unverändert und trainiert kleine zusätzlich eingefügte Komponenten, die Adapter genannt werden. Dies ist weder ein Training eines Foundation-Modells noch ein vollständiges Feinabstimmen aller Gewichte. Die GPU übernimmt das Training; ein Server stellt einen isolierten, wiederholbaren Job bereit und speichert dessen Artefakte. Andere Workloads für eine einzelne Karte sollten separat eingeplant werden.
Beginnen Sie mit einem unterstützten Trainingsrezept für kleine Textmodelle und nicht mit dem zuvor verwendeten Ollama-Inferenzpaket. Laut Unsloth-Anforderungen sind unterstützte Modelle mit etwa drei bis acht Milliarden Parametern geeignete Ausgangskandidaten. Kurze Sequenzen und kleine Batches helfen, den Speicherbedarf zu kontrollieren, aber nicht jedes Modell oder Rezept passt in 16 GB. Probieren Sie zuerst Prompts aus; verwenden Sie Retrieval für sich ändernde Fakten.
- Einstiegsprojekt: Vergleichen Sie das Originalmodell, eine Version mit starkem Prompt und eine angepasste Version anhand derselben zurückgehaltenen Anfragen, also Beispiele, die nicht im Training verwendet wurden. Prüfen Sie die gewählten Kategorien und die Fehlerfälle.
- Beispiel-Stack: Der von Unsloth dokumentierte Trainingsweg mit dem älteren Textmodell Qwen2.5-7B-Instruct in einem kompatiblen 4-Bit-Rezept; gelabelte Supportbeispiele und Evaluierungscode für die Kategorievorhersagen.
- Hauptbeschränkung: Datenqualität und Evaluierung entscheiden darüber, ob die Anpassung geholfen hat. Abgeschlossenes Training belegt keine Verbesserung.
Was Ihr Projekt neben der GPU benötigt
Sobald Sie ein Projekt im Blick haben, dimensionieren Sie den umgebenden Server. Wenn der VRAM die Werkbank ist, dann ist der System-RAM der nahe gelegene Zwischenspeicher für die Anwendung und die Datenvorbereitung. Wählen Sie die CPU-Kapazität für das Parsen und andere Aufgaben der umgebenden Anwendung. NVMe-SSD-Speicher ist das Lager für aktive Modelle und Assets.
Mehr Speicherplatz vergrößert den GPU-Speicher nicht; das Verlagern von Arbeit in den System-RAM kann dazu beitragen, dass unterstützte Anwendungen hineinpassen, allerdings mit Leistungseinbußen. Prüfen Sie die Hardwareanforderungen Ihrer gewählten Software zusammen mit diesen Ressourcen.
AlexHost bietet Konfigurationen mit einer und zwei Karten an, darunter eine einzelne RTX 4070 Ti SUPER mit 16 GB GPU-Speicher, 64 GB RAM und 1 TB NVMe. Dies ist ein Beispiel dafür, wie die Karte mit Ressourcen für die umgebende Anwendung kombiniert werden kann.
Wenn die Arbeitslast wächst, unterscheiden Sie zwischen einer längeren Warteschlange und einem Job, der nicht mehr hineinpasst. Eine weitere GPU kann unabhängige Jobs übernehmen. Ein größeres Modell oder eine größere Szene benötigt dagegen möglicherweise mehr Speicher pro Karte. Einige Model-Serving-Anwendungen können einen Job auf mehrere Karten verteilen, mit Kommunikationsaufwand; unabhängige Worker sind die einfachere Anordnung:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Lassen Sie neben den Gewichten des Modells Raum für Kontext und temporäre Berechnungen. Eine höhere Bildauflösung und gleichzeitige Anfragen können ebenfalls den Speicherbedarf erhöhen. Die Speicherhinweise von Ollama erklären, warum die Download-Größe nicht dem maximalen Speicherverbrauch entspricht. Bei einer Karte können Warteschlangen oder getrennte Zeitpläne verhindern, dass konkurrierende Modelle den Speicher erschöpfen.
📝 Hinweis:Konzeptionelle Zuordnungen, kein zugesichertes Anbieter-Layout: Zwei separate GPUs mit je 16 GB ergeben insgesamt 32 GB, nicht automatisch eine einzige 32-GB-Zuweisung. Die Aufteilung unterstützter Modelle ist eine eigene Softwarefunktion und kein automatisches Zusammenlegen des Speichers.
Aufnahmebibliotheken benötigen Speicher und Backups, während häufige Übertragungen die Bandbreite zu einem Teil der Dimensionierungsentscheidung machen. Verwenden Sie bei einem öffentlich erreichbaren Dienst eine Authentifizierung und beschränken Sie den Zugriff auf vorgesehene Benutzer. Ein Verantwortlicher für die Wartung muss ihn aktuell halten und die externen Verarbeitungswege prüfen. Dieser Verantwortliche muss außerdem festlegen, wie lange Logs und Backups aufbewahrt werden.
Wiederkehrende Arbeiten können dedizierte Ressourcen rechtfertigen; gelegentliche Nutzung passt eventuell besser zu einer API oder einer gelegentlichen Miete. Wägen Sie den Aufwand für den Betrieb der Anwendung gegen die Mietkosten ab.
Wählen Sie ein nützliches erstes Projekt
Passen Sie das gewünschte Ergebnis an ein kleines Projekt an, das Sie überprüfen können:
| Ihr Ziel | Einstiegsprojekt | Hauptbeschränkung |
|---|---|---|
| 📚 Antworten aus internen Dokumenten | Eine kuratierte Onboarding-Sammlung | Abruf-Qualität und Berechtigungen |
| 🎨 Konzepte für Kampagnenbilder | Variationen eines eigenen Produktfotos | Produktgenauigkeit und Rechte |
| 🎙️Lesbare, durchsuchbare Aufnahmen | Überprüftes Transkript und Untertitel | Audioqualität und Korrektur |
| 💻 Hilfe direkt im Editor | Testentwürfe für ein Modul | Kontext und Code-Review |
| 🧾 Strukturierte Rechnungsdatensätze | Eine Rechnungsfamilie in eine Prüftabelle | Feldvalidierung und Freigabe |
| 🎬 Auslieferungsfertiges Video | Eine Aufnahme in zwei Auflösungen | Codec-Unterstützung und Pipeline-Kapazität |
| 🧊 Fertige 3D-Visualisierungen | Ein kleiner Produkt-Render-Auftrag | Szenenspeicher und Asset-Übertragung |
| 🧠 Konsistentes Modellverhalten—fortgeschritten | Ein Adapter für Support-Kategorien | Trainingsdaten und Auswertung mit Holdout-Daten |
Für Teams mit Dokumenten ist ein Wissensassistent ein zugänglicher Einstieg. Visuelle Kreative können mit Bildbearbeitung beginnen, während Personen mit Aufnahmearchiven mit Transkription starten können. Wählen Sie ein Ergebnis, das auf Eingaben basiert, die Ihnen gehören oder die Sie verwenden dürfen. Machen Sie den Erfolg konkret: eine Antwort, die auf den richtigen Passagen beruht, oder Untertitel, die der Aufnahme folgen.
Wenn Remote-Hosting zu Ihrer Wahl passt, bietet das GPU-Serverangebot von AlexHost Konfigurationen, die Sie mit dem gewählten Projekt vergleichen können. Erstellen Sie dann die kleinste Version, die ein nützliches Ergebnis liefert. Ihr erster Meilenstein ist ein fertiges Ergebnis, das Sie nutzen können – nicht ein Server voller halb fertiggestellter Anwendungen.