Billet ouvert
 +373 79 600002
 Chat en direct Telegram
 F.A.Q
 Français
 English
 Русский
 Română
 Deutsch
 Türkçe
 Español
 Português
 Українська
 български
 Polski
 Indonesia
 中文 (中国)


 sur tous les services d'hébergement


Meilleurs cas d’utilisation des serveurs RTX 4070 Ti SUPER en 2026
Vos documents d’intégration pourraient devenir des réponses sourcées. Une photo de produit dont vous disposez pourrait devenir des concepts d’arrière-plan pour vos campagnes. Une scène 3D existante pourrait devenir des visuels produits finalisés, le tout sans garder un ordinateur portable occupé. Voilà trois cas d’usage pratiques pour un serveur équipé d’une RTX 4070 Ti SUPER : des tâches ciblées aux résultats facilement identifiables.
Les huit options ci-dessous sont des alternatives, et non des applications à charger ensemble. Ici, « meilleur » désigne des résultats utiles accompagnés d’une voie logicielle réaliste, et non un classement de performances. Les modèles compacts combinant image et texte ainsi que les workflows d’édition élargissent les options en 2026 ; l’encodage et le rendu restent également utiles. Choisissez un service ciblé ou un worker en file d’attente capable de fonctionner de manière autonome, indépendamment de votre ordinateur portable.
La limite utile : 16 Go d’espace de travail rapide
La RTX 4070 Ti SUPER dispose de 16 Go de VRAM, la mémoire de travail du GPU. C’est son plan de travail pour les modèles et les scènes, c’est pourquoi les projets ci-dessous utilisent des modèles plus petits et des tâches bornées. Les logiciels NVIDIA compatibles gèrent l’IA et le rendu, tandis que le matériel dédié d’encodage vidéo prend en charge les travaux multimédias. Il s’agit de points de départ étayés par la documentation, et non de benchmarks de déploiement. Chacun suppose une seule carte correctement configurée.
1. Interrogez vos propres documents, pas tout Internet
Un nouveau coéquipier demande quelle liste de contrôle d’intégration s’applique à son poste. Au lieu de chercher dans les dossiers, il reçoit une réponse provisoire liée aux fichiers d’intégration ou runbooks approuvés. Avec le modèle auto-hébergé à distance et un accès d’équipe contrôlé, cela peut devenir un service de connaissances privé.
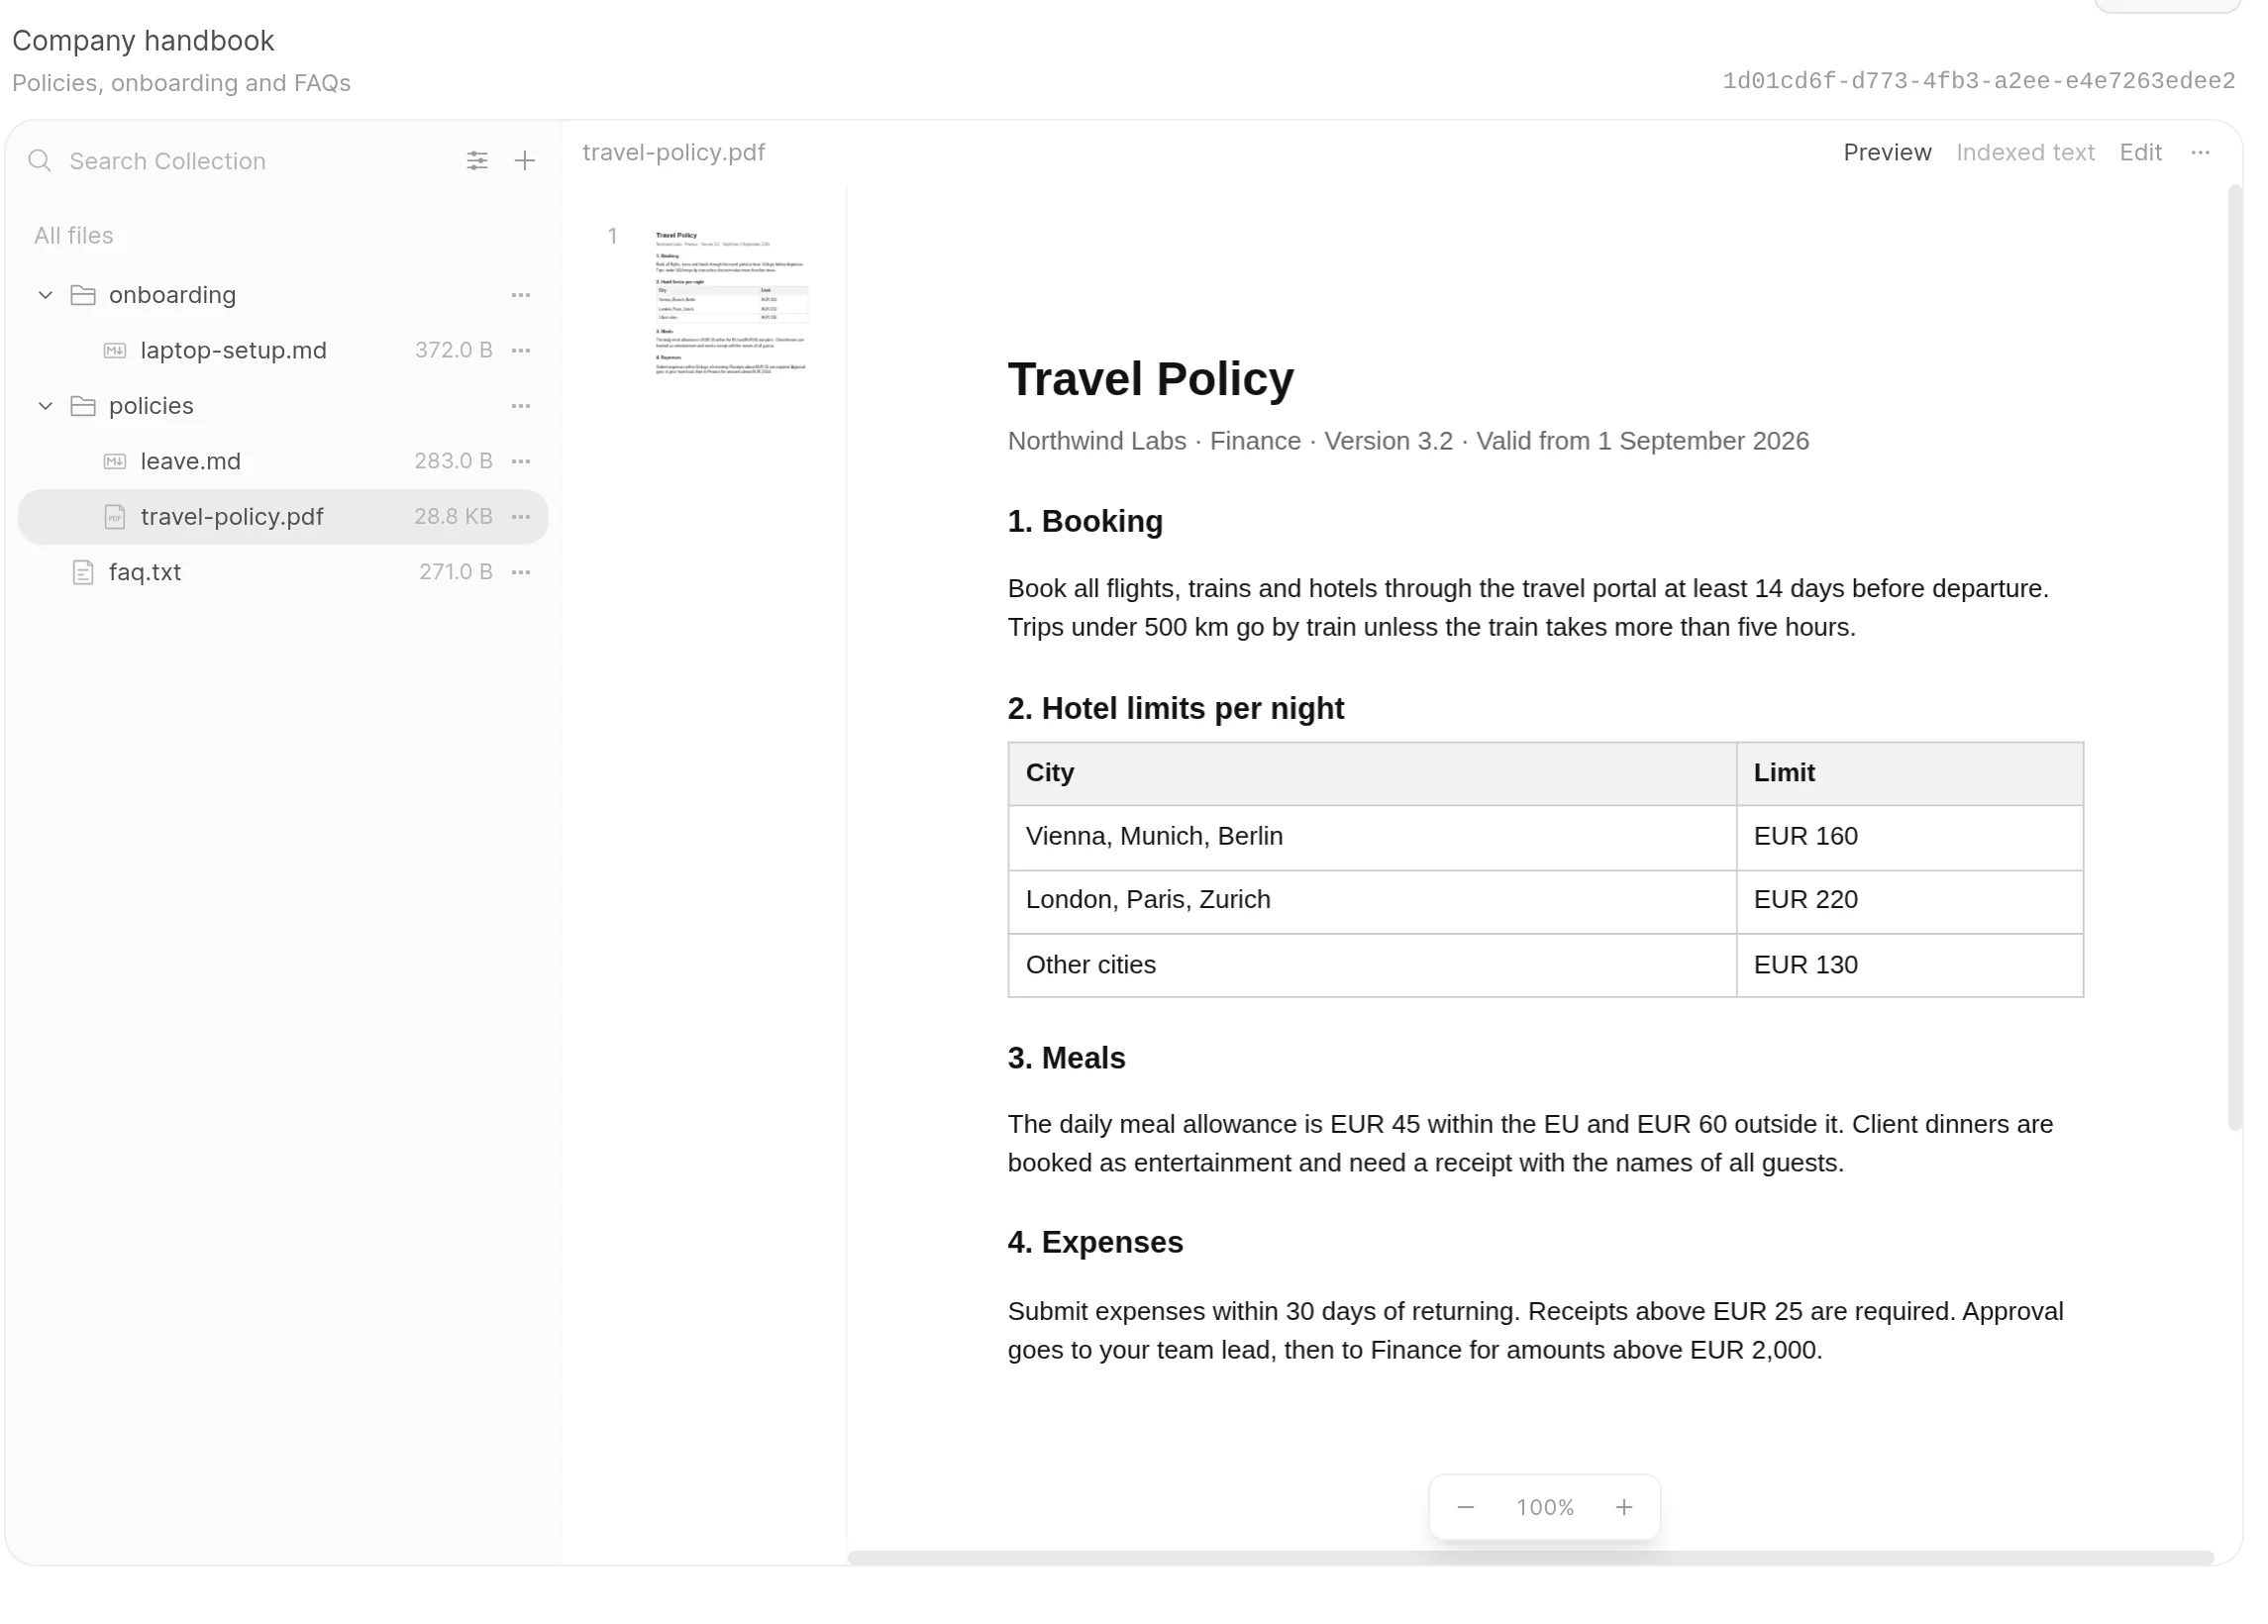
La génération augmentée par récupération, ou RAG, fonctionne comme un assistant à livre ouvert : un logiciel trouve les passages pertinents et les transmet au modèle avant qu’il ne réponde. Les embeddings rendent les passages consultables par le sens et pas seulement par la formulation exacte. Téléverser des documents ne réentraîne pas le modèle ; la réponse dépend du contenu récupéré pour cette question.
📝 Note : L’inférence privée signifie que le modèle s’exécute sur le serveur distant, et non que chaque composant est privé. Vérifiez où s’exécutent les embeddings et l’analyse des documents. Les journaux et les solutions de repli externes doivent aussi être examinés. L’hébergement distant reste une relation de confiance avec le fournisseur.
Le GPU accélère principalement l’inférence : l’utilisation d’un modèle déjà entraîné pour générer la réponse. Un modèle quantifié stocke ses nombres avec moins de bits, ce qui économise la mémoire avec des compromis possibles sur la qualité. La question et les passages récupérés forment une partie de son contexte, c’est-à-dire les informations qu’il garde en vue pour une requête. La correspondance des passages peut utiliser un petit composant auto-hébergé ; le stockage et la recherche de fichiers ne nécessitent pas forcément un autre service GPU important.
- Projet de démarrage : Une collection d’intégration et des questions dont la réponse est connue. Vérifiez les réponses par rapport aux passages cités ; incluez une question sans réponse pour voir si l’assistant reconnaît l’absence d’information.
- Exemple de pile : Open WebUI pour les documents et la récupération ; embeddings auto-hébergés pour la correspondance des passages ; Ollama exécutant Qwen3.5-4B quantifié pour les réponses côté serveur.
- Limite principale : La qualité de la récupération et les autorisations déterminent ce qui atteint le modèle. Les citations aident à vérifier les réponses ; elles ne certifient pas la véracité.
2. Donner à une équipe son propre studio de génération et d’édition d’images
Une petite boutique possède une photo de produit et a besoin de concepts d’arrière-plan pour ses campagnes : un fond de studio, un décor saisonnier, une palette de couleurs différente. Le résultat est un ensemble de brouillons que quelqu’un peut sélectionner et affiner, un objectif de départ plus raisonnable que le remplacement de la photographie produit.
Le flux de travail visuel relie des postes de traitement, appelés nœuds, qui chargent une image de référence, appliquent des instructions et enregistrent les résultats. Le GPU exécute le modèle d’image pour transformer la photo et l’invite en une variante. L’enregistrement de ce flux de travail offre à l’équipe un point de départ reproductible pour le prochain ensemble de concepts.
Les membres de l’équipe peuvent soumettre des tâches à une file d’attente de serveur partagée au lieu de reconstruire la configuration sur des ordinateurs individuels. Le modèle FLUX.2 [klein] 4B proposé utilise la licence Apache-2.0, qui autorise l’utilisation commerciale selon ses conditions. Cette licence s’applique à cette variante, et non à tous les modèles FLUX ; les droits sur les images restent importants.
- Projet de démarrage : Créer quelques variantes d’arrière-plan pour une image de produit dont vous êtes propriétaire. Comparer la forme, le texte d’emballage, les logos et la cohérence de la marque avec l’original avant utilisation.
- Pile d’exemple : ComfyUI pour le flux de travail visuel enregistré et la file d’attente des tâches ; FLUX.2 [klein] 4B distillé pour la génération et l’édition d’images de référence sur le GPU.
- Limite principale : Une image convaincante peut tout de même modifier le produit ou son texte. Considérer les résultats comme des concepts nécessitant une vérification de l’exactitude et des droits.
3. Преобразуйте записи в транскрипты, субтитры и поисковые знания
Wait, the target language is French, not Russian. Correcting that:
3. Transformez les enregistrements en transcriptions, sous-titres et connaissances consultables
Votre webinaire ou une réunion enregistrée avec le consentement approprié peut contenir des informations difficiles à retrouver plus tard. Un travailleur de transcription les transforme en texte horodaté et en fichiers de sous-titres. Organisez les transcriptions vérifiées, et une simple recherche textuelle peut vous aider à localiser un sujet sans réécouter chaque enregistrement.

Le modèle de reconnaissance vocale produit d’abord des segments de transcription avec horodatage. Un wrapper d’export, c’est-à-dire le code applicatif autour de la bibliothèque de reconnaissance, les enregistre ensuite sous forme de texte lisible et de fichiers de sous-titres SRT ou VTT. Ces horodatages relient les mots à l’enregistrement et fournissent à l’exportateur de sous-titres les informations de synchronisation.
Une liste ou file de téléversement permet au serveur de traiter un arriéré d’enregistrements sans supervision, le GPU prenant en charge la reconnaissance vocale. Les résumés optionnels nécessitent un autre modèle, de préférence planifié séparément sur une même carte. Les étiquettes de locuteurs demandent une étape distincte pour distinguer les intervenants ; la transcription seule ne les fournit pas.
- Projet de départ : Traitez plusieurs enregistrements dont l’utilisation est autorisée pour obtenir des transcriptions et des sous-titres. Comparez des échantillons avec l’audio en vérifiant les noms, le vocabulaire technique et la synchronisation des sous-titres.
- Exemple de pile technique : faster-whisper avec large-v3 et des paramètres GPU à précision réduite adaptés ; une file de téléversement ; un wrapper d’export pour les fichiers de sous-titres et le stockage de transcriptions consultables.
- Limite principale : La qualité audio détermine la charge de correction. Le bruit, les accents, les termes inconnus et les locuteurs qui se chevauchent peuvent laisser des erreurs nécessitant une vérification humaine.
4. Connectez un assistant de codage privé à votre éditeur
Sélectionnez une fonction dans votre éditeur et demandez des tests, une explication ou un petit refactoring. Vous obtenez un brouillon de code à côté de la fonction sur laquelle vous travaillez. Votre éditeur et vos fichiers de travail peuvent rester sur l’ordinateur portable, tandis que le code sélectionné est envoyé au serveur pour l’inférence.
L’éditeur envoie le code sélectionné et votre question à un point de terminaison de modèle distant, puis affiche la réponse dans l’espace de travail de développement. Indiquer le comportement attendu de la fonction aide à rendre la requête concrète. Pour une tâche d’écriture de tests, le résultat vous fournit un brouillon à comparer avec ce comportement, plutôt qu’un fichier de tests vierge.
Le GPU gère la génération des réponses, tandis que le serveur fournit un point de terminaison réutilisable pour les requêtes de l’éditeur. Gardez l’exécution et les modifications à risque sous votre contrôle, avec des permissions restreintes. Le chat de l’éditeur est le flux de travail de départ ici ; l’autocomplétion inline réactive a des exigences différentes en matière de modèle et de latence.
- Projet de départ : Rédigez des tests brouillons pour un module. Inspectez-les, exécutez-les dans un environnement de développement contrôlé et vérifiez le comportement attendu, et pas seulement s’ils se compilent.
- Exemple de stack : Continuez avec le chat de l’éditeur et les modifications proposées ; un point de terminaison Ollama contrôlé exécutant Qwen3.5-4B quantifié sur le serveur pour la génération des réponses.
- Limite principale : La qualité des petits modèles, le contexte de code limité et la latence réseau restreignent l’aide. Ce n’est pas un substitut aux plus grands systèmes de codage commerciaux.
5. Transformer les factures et les numérisations en enregistrements structurés
Les images de factures peuvent devenir des champs proposés pour le fournisseur, la date, le numéro de facture et le montant total dans une feuille de calcul de révision. Relier chaque ligne à son document d’origine facilite la comparaison. L’intérêt pratique est un ensemble cohérent d’enregistrements que quelqu’un peut vérifier et transmettre au processus métier suivant.

Un modèle vision-langage accepte des images aussi bien que du texte. Préparez une image de page à la fois, puis demandez-lui les champs dont vous avez besoin. Cela rend le GPU utile pour l’interprétation visuelle, plutôt que de supposer que le modèle peut analyser tous les types de PDF. Les PDF propres et basés sur du texte peuvent ne nécessiter qu’une analyse classique, sans GPU.
Après l’extraction, du code applicatif ordinaire vérifie que les valeurs requises sont présentes et que les dates et les nombres respectent les formats attendus. Il peut aussi contrôler les calculs lorsque c’est possible et rechercher les identifiants de facture en double. Les champs manquants ou incertains restent signalés. Le serveur regroupe les résultats du lot et leurs sources pour la remise en révision :
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Les champs extraits sont des propositions tant que les vérifications ordinaires et la révision humaine ne sont pas terminées ; ce n’est qu’alors qu’ils peuvent devenir des enregistrements approuvés.
- Projet de départ : Convertissez une famille de factures en feuille de calcul de révision avec des références aux sources. Comparez chaque champ sélectionné avec l’original avant d’accepter la ligne.
- Pile technique indicative : Préparation des images de page ; Ollama avec Qwen3.5-4B pour l’extraction visuelle ; code ordinaire de validation et d’export, et une étape de révision pour produire des enregistrements de feuille de calcul approuvés avec des références aux sources.
- Limite principale : Des valeurs plausibles peuvent être fausses. Exigez une approbation humaine avant toute saisie comptable ou tout paiement.
6. Rendre la vidéo téléchargée prête pour différents spectateurs
Une leçon ou une démonstration de produit peut nécessiter plusieurs versions de diffusion, et non de nouvelles prises de vues. Le transcodage convertit une vidéo déjà encodée. Un master adapté peut devenir des copies en 1080p et 720p pour différents écrans et connexions. Réduire la résolution peut faciliter la diffusion ; l’augmenter ne permet pas de retrouver des détails manquants.
NVENC est l’encodeur vidéo spécialisé de NVIDIA, distinct du calcul des modèles de langage. Un codec est la technologie utilisée pour encoder et décoder une vidéo. H.264 est un choix de départ largement compatible ; AV1 est une autre option lorsque vos appareils de lecture cibles la prennent en charge. Le décodage et la mise à l’échelle peuvent faire intervenir d’autres composants matériels GPU ou le CPU.
Le serveur peut appliquer des paramètres de conversion cohérents aux téléchargements en file d’attente et stocker les copies de diffusion séparément du master. Le matériel multimédia gère l’encodage pris en charge, mais les paramètres influencent toujours le résultat. Choisissez l’encodage matériel pour le débit, et non pour des gains de qualité garantis par rapport à l’encodage CPU.
- Projet de départ : Convertir un enregistrement dont vous êtes propriétaire en versions 1080p et 720p. Vérifiez la lecture sur les appareils visés, la synchronisation du son, la lisibilité du contenu et la taille des fichiers.
- Exemple de pile : FFmpeg pour la conversion avec un encodage pris en charge par NVIDIA ; une file d’attente de téléchargement simple pour planifier les tâches, et un stockage pour les fichiers sources et les versions de diffusion finales.
- Limite principale : La capacité dépend des codecs, des paramètres, des restrictions de sessions du pilote, de l’activité disque et de la bande passante de transfert, et non de la seule mémoire GPU.
7. Envoyer des rendus Blender à un worker GPU distant
Un designer produit peut continuer à modéliser en local pendant qu’un serveur produit les images finales ou les séquences de rotation. Le rendu désigne le calcul des images finales à partir d’une scène 3D existante, et non la création d’une image à partir d’une invite textuelle. Vous fournissez la scène, les matériaux, l’éclairage et la caméra ; le worker calcule les images finales.
Le backend de rendu connecte les calculs de la scène à l’accélération matérielle RTX. Vous pouvez exécuter le rendu en arrière-plan sans bureau distant interactif, ce qui permet à la tâche préparée de produire les fichiers de sortie sur le serveur. Sélectionnez le rendu GPU séparément ; le mode arrière-plan seul ne choisit pas le périphérique de rendu.
La transmission nécessite des fonctionnalités Blender compatibles et tous les éléments requis : intégrez les textures au projet ou assurez-vous que leurs chemins sont résolus sur le serveur. Le temps de transfert et de préparation peut dépasser le gain pour les très petites tâches. La prise en charge du repli sur la mémoire peut aider les scènes plus volumineuses à tenir, au prix d’un compromis sur les performances.
- Projet de démarrage : Rendez une scène produit modeste en images finales ou en courte séquence de rotation. Vérifiez les textures, matériaux, éclairage et cadrage d’une image représentative avant de mettre tout en file d’attente.
- Pile d’exemple : Blender Cycles pour le rendu de scène ; NVIDIA OptiX pour l’accélération GPU ; exécution en arrière-plan pour produire les fichiers de sortie sans bureau distant interactif.
- Limite principale : La mémoire de la scène et des textures détermine ce qui peut tenir. Plusieurs cartes ne combinent normalement pas leur mémoire de scène sur ce matériel.
8. Adapter un petit modèle à une tâche répétable
Plus avancé. Vous pourriez adapter un petit modèle pour classer les demandes de support dans des catégories existantes : facturation, accès au compte ou problèmes techniques. Pensez à former un employé à une procédure précise, et non à lui apprendre tout depuis le début. Le livrable est un adaptateur accompagné de preuves d’évaluation, et non des actions automatiques sur les tickets sans supervision.
QLoRA maintient un modèle de base quantifié largement figé tout en entraînant de petits composants ajoutés appelés adaptateurs. Il ne s’agit pas d’un entraînement de modèle de fondation ni d’un ajustement fin de l’ensemble des poids. Le GPU effectue l’entraînement ; un serveur fournit une tâche isolée et répétable et stocke ses artefacts. Planifiez séparément les autres charges de travail sur une seule carte.
Commencez par une recette d’entraînement prise en charge pour un petit modèle de texte, plutôt que par le package d’inférence Ollama utilisé précédemment. Selon les exigences d’Unsloth, les modèles pris en charge d’environ trois à huit milliards de paramètres constituent des candidats de départ. Des séquences courtes et de petits lots aident à maîtriser l’utilisation de la mémoire, mais tous les modèles et toutes les recettes ne tiendront pas dans 16 Go. Essayez d’abord les prompts ; utilisez la recherche augmentée (retrieval) pour les informations qui changent.
- Projet de départ : Comparez le modèle d’origine, une version avec un prompt renforcé et une version adaptée sur les mêmes demandes mises de côté, c’est-à-dire des exemples exclus de l’entraînement. Examinez les choix de catégories et les échecs.
- Pile d’exemple : La voie d’entraînement documentée par Unsloth, utilisant le modèle de texte plus ancien Qwen2.5-7B-Instruct dans une recette 4 bits compatible ; des exemples de support étiquetés et du code d’évaluation des prédictions de catégories.
- Limite principale : La qualité des données et l’évaluation déterminent si l’adaptation a été utile. La fin de l’entraînement ne démontre pas une amélioration.
Ce dont votre projet a besoin au-delà du GPU
Une fois que vous avez un projet en tête, dimensionnez le serveur qui l’entoure. Si la VRAM est l’établi, la RAM système est l’espace de préparation voisin pour l’application et la préparation des données. Choisissez la capacité CPU pour l’analyse syntaxique et les autres tâches applicatives annexes. Le stockage NVMe SSD est l’entrepôt des modèles et des ressources actifs.
Un stockage plus important n’agrandit pas la mémoire GPU ; déplacer une partie du travail vers la RAM système peut aider les applications prises en charge à tenir en mémoire, avec un surcoût de performance. Vérifiez les exigences matérielles de votre logiciel choisi en parallèle de ces ressources.
AlexHost propose des configurations à une et deux cartes, notamment une seule RTX 4070 Ti SUPER avec 16 Go de mémoire GPU, 64 Go de RAM et 1 To de NVMe. Ceci est un exemple de combinaison de la carte avec des ressources pour l’application environnante.
Lorsque la charge augmente, distinguez une file d’attente plus longue d’une tâche qui ne tient plus. Un autre GPU peut traiter des tâches indépendantes. Un modèle ou une scène plus grand(e) peut en revanche nécessiter davantage de mémoire par carte. Certaines applications de service de modèles peuvent répartir une tâche sur plusieurs cartes, avec un surcoût de communication ; des workers indépendants constituent l’organisation la plus simple :
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Prévoyez de la marge au-delà des poids du modèle pour le contexte et les calculs temporaires. Une résolution d’image plus élevée et des requêtes simultanées peuvent également augmenter les besoins en mémoire. Le guide de mémoire d’Ollama explique pourquoi la taille du téléchargement ne correspond pas à la consommation maximale de mémoire. Sur une seule carte, des tâches mises en file d’attente ou des planifications séparées peuvent empêcher des modèles concurrents d’épuiser la mémoire.
📝 Note :Attributions conceptuelles, et non une configuration garantie par le fournisseur : deux GPU séparés de 16 Go fournissent 32 Go cumulés, et non une allocation automatique de 32 Go. La répartition d’un modèle prise en charge est une fonctionnalité logicielle distincte, et non une mise en commun automatique de la mémoire.
Les bibliothèques d’enregistrements nécessitent du stockage et des sauvegardes, tandis que des transferts fréquents font de la bande passante un élément du dimensionnement. Pour un service exposé, utilisez une authentification et limitez l’accès aux utilisateurs prévus. Un responsable de la maintenance doit le maintenir à jour et vérifier les chemins de traitement externes. Ce responsable doit aussi décider de la durée de conservation des journaux et des sauvegardes.
Un travail récurrent peut justifier des ressources dédiées ; une utilisation sporadique peut mieux correspondre à une API ou à une location occasionnelle. Pesez l’effort d’exploitation de l’application par rapport aux coûts de location.
Choisissez un premier projet utile
Associez le résultat dont vous avez besoin à un petit projet que vous pouvez vérifier :
| Votre objectif | Projet de départ | Contrainte principale |
|---|---|---|
| 📚 Réponses à partir de documents internes | Une collection d’intégration sélectionnée | Qualité de la recherche et permissions |
| 🎨 Concepts d’images pour campagnes | Variations d’une photo produit dont vous disposez | Exactitude du produit et droits |
| 🎙️Enregistrements lisibles et consultables | Transcription et sous-titres relus | Qualité audio et correction |
| 💻 Aide dans votre éditeur | Tests préliminaires pour un module | Contexte et revue de code |
| 🧾 Registres de factures structurés | Une famille de factures dans un tableur de contrôle | Validation des champs et approbation |
| 🎬 Vidéo prête à être diffusée | Un enregistrement en deux résolutions | Prise en charge des codecs et capacité du pipeline |
| 🧊 Visuels 3D finalisés | Un petit travail de rendu de produit | Mémoire de scène et transfert des ressources |
| 🧠 Comportement de modèle cohérent—avancé | Un adaptateur pour les catégories de support | Données d’entraînement et évaluation sur données réservées |
Pour les équipes disposant de documents, un assistant de connaissances constitue un point de départ accessible. Les créateurs visuels peuvent commencer par la retouche d’images, tandis que les personnes disposant de bibliothèques d’enregistrements peuvent commencer par la transcription. Choisissez un seul livrable à partir de données que vous possédez ou pour lesquelles vous avez l’autorisation de les utiliser. Rendez le succès concret : une réponse appuyée par les bons passages, ou des sous-titres qui suivent l’enregistrement.
Si l’hébergement à distance convient à votre choix, l’offre de serveurs GPU d’AlexHost vous propose des configurations à comparer avec le projet que vous avez sélectionné. Ensuite, construisez la version la plus simple qui produit un résultat utile. Votre premier jalon est un résultat fini que vous pouvez utiliser, et non un serveur rempli d’applications à moitié commencées.