Bilet otwarty
 +373 79 600002
 Czat na żywo w Telegramie
 F.A.Q
 Polski
 English
 Русский
 Română
 Deutsch
 Français
 Türkçe
 Español
 Português
 Українська
 български
 Indonesia
 中文 (中国)


 na wszystkich usługach hostingowych


Najlepsze zastosowania serwerów z RTX 4070 Ti SUPER w 2026 roku
Twoje dokumenty wdrożeniowe mogą stać się odpowiedziami z podanymi źródłami. Należącą do Ciebie fotografię produktu można przekształcić w koncepcje tła do kampanii. Istniejąca scena 3D może posłużyć do stworzenia gotowych wizualizacji produktów, a wszystko to bez zajmowania laptopa. To trzy praktyczne zastosowania serwera z RTX 4070 Ti SUPER: konkretne zadania o rozpoznawalnych wynikach.
Osiem poniższych opcji to alternatywy, a nie aplikacje do uruchomienia razem. Tutaj „najlepsza” oznacza użyteczne rezultaty z realistyczną ścieżką programistyczną, a nie ranking wydajności. Kompaktowe modele obrazowo-tekstowe i przepływy pracy do edycji rozszerzają w 2026 roku liczbę możliwości; kodowanie i renderowanie również pozostają przydatne. Wybierz jedną, skupioną usługę lub kolejkowy worker, który może działać niezależnie od Twojego laptopa.
Realna granica: 16 GB szybkiej przestrzeni roboczej
RTX 4070 Ti SUPER ma 16 GB VRAM — pamięci roboczej procesora graficznego. To jego stół roboczy dla modeli i scen, dlatego poniższe projekty wykorzystują mniejsze modele i ograniczone zadania. Zgodne oprogramowanie NVIDIA obsługuje AI i renderowanie, a dedykowany sprzęt do kodowania wideo wspiera pracę z multimediami. Są to punkty wyjścia oparte na dokumentacji, a nie testy wydajności wdrożeniowej. Każde z nich zakłada jedną odpowiednio skonfigurowaną kartę.
1. Ask your own documents, not the whole internet
Новый сотрудник спрашивает, какой чек-лист адаптации относится к его роли. Вместо поиска по папкам он получает черновик ответа со ссылками на утверждённые файлы адаптации или руководства. Когда модель размещена на удалённом сервере с контролируемым доступом команды, это может стать закрытым сервисом знаний.
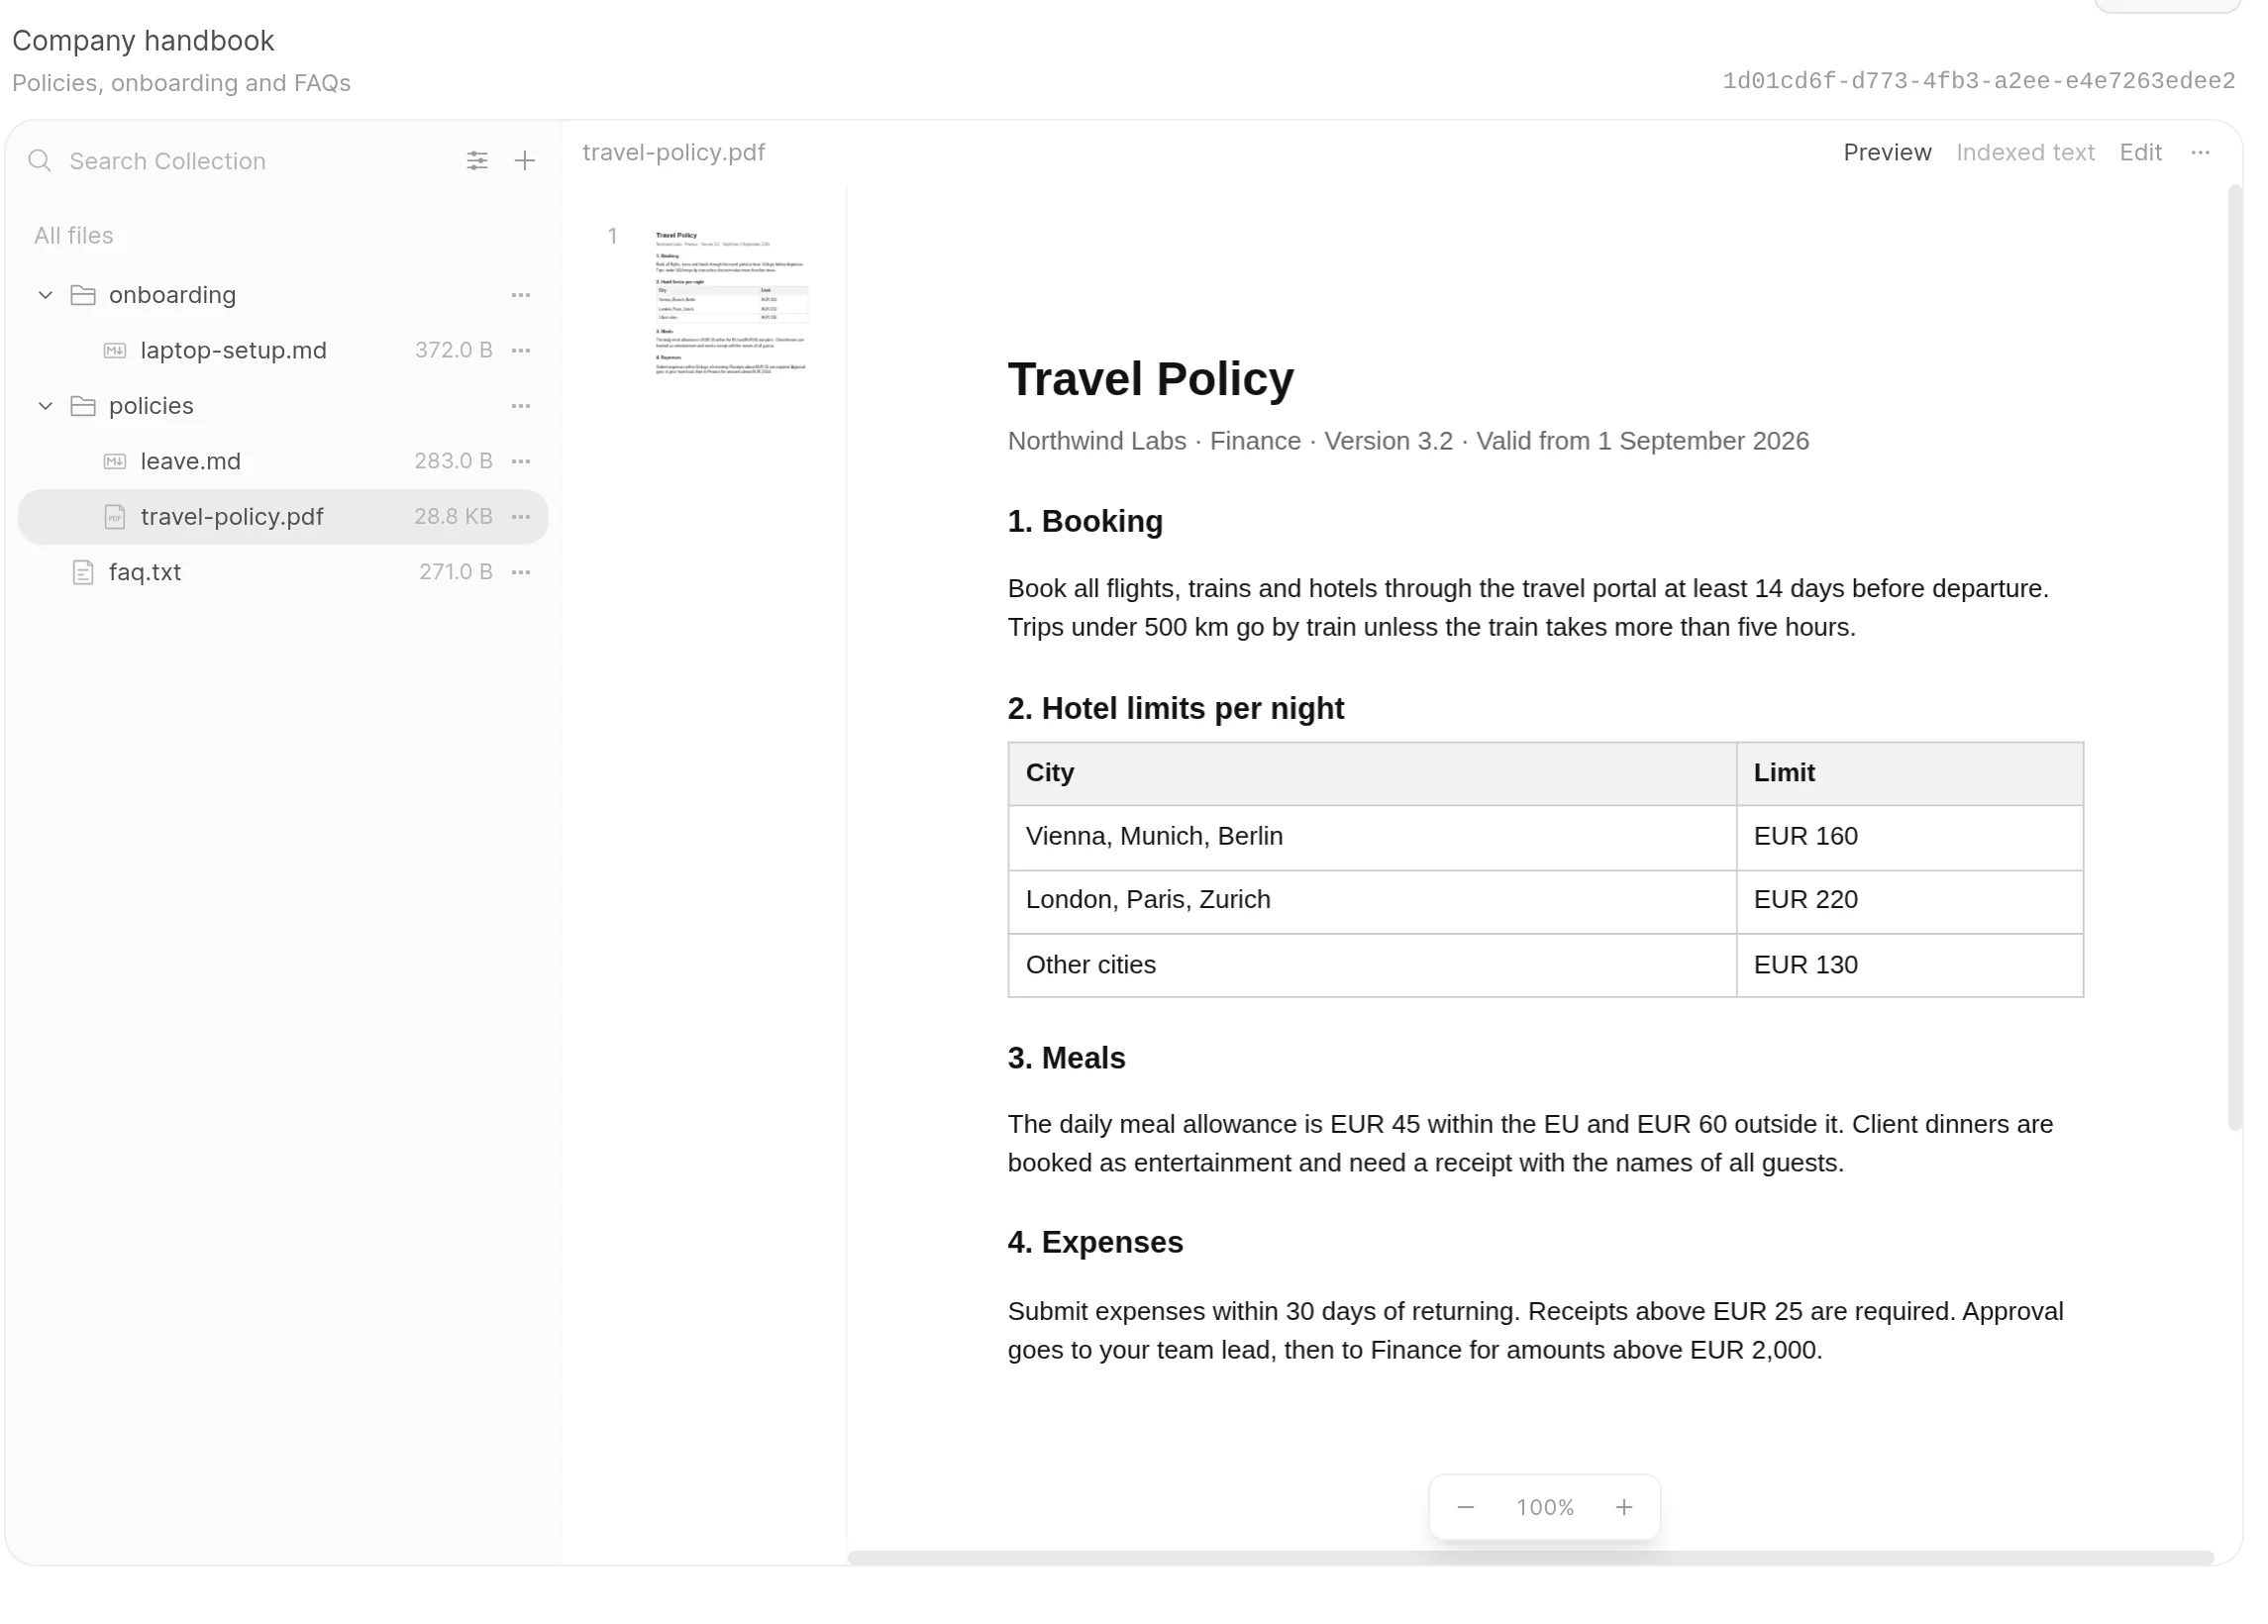
Retrieval-augmented generation, или RAG, работает как ассистент с открытой книгой: программа находит релевантные фрагменты и передаёт их модели до того, как она даст ответ. Эмбеддинги делают фрагменты доступными для поиска по смыслу, а не только по точной формулировке. Загрузка документов не переобучает модель; ответ зависит от материалов, найденных для конкретного вопроса.
📝 Примечание: Приватный инференс означает, что модель работает на удалённом сервере, но не то, что каждый компонент является приватным. Проверьте, где выполняются эмбеддинги и разбор документов. Логи и внешние резервные варианты также требуют проверки. Удалённый хостинг остаётся доверительными отношениями с провайдером.
GPU в основном ускоряет инференс: использование уже обученной модели для генерации ответа. Квантованная модель хранит свои числа с меньшим количеством бит, экономя память, но возможно с компромиссами по качеству. Вопрос и найденные фрагменты составляют часть её контекста — информации, которую она держит в поле зрения для запроса. Сопоставление фрагментов может использовать небольшойself-hosted компонент; хранение и поиск файлов не обязательно требуют отдельного большого GPU-сервиса.
- Стартовый проект: Одна коллекция материалов адаптации и вопросы с известными ответами. Проверяйте ответы по цитируемым фрагментам; добавьте вопрос без ответа, чтобы увидеть, признаёт ли ассистент отсутствие информации.
- Пример стека: Open WebUI для документов и поиска; self-hosted эмбеддинги для сопоставления фрагментов; Ollama, работающий с квантованной Qwen3.5-4B для ответов на сервере.
- Главное ограничение: Качество поиска и права доступа определяют, что попадёт в модель. Цитаты помогают проверять ответы; они не подтверждают их истинность.
2. Дайте команде собственную студию генерации и редактирования изображений
Ошибка: переводить нужно на польский, не на русский. Исправляю ниже.
2. Daj zespołowi własne studio generowania i edycji obrazów
Mały sklep posiada zdjęcie produktu i potrzebuje koncepcji tła do kampanii: studyjnego tła, sezonowej scenerii, innej palety kolorów. Wynikiem jest zestaw wersji roboczych, z których ktoś wybiera i je dopracowuje — to bardziej przystępny pierwszy cel niż zastąpienie fotografii produktowej.
Przepływ pracy z obrazami łączy stanowiska przetwarzania, zwane węzłami (nodes), które wczytują obraz referencyjny, stosują instrukcje i zapisują wyniki. Karta GPU uruchamia model obrazowy, który przekształca zdjęcie i prompt w wariant. Zapisanie tego przepływu daje zespołowi powtarzalny punkt wyjścia dla kolejnego zestawu koncepcji.
Członkowie zespołu mogą przesyłać zadania do wspólnej kolejki na serwerze zamiast odtwarzać konfigurację na indywidualnych komputerach. Proponowany model FLUX.2 [klein] 4B jest objęty licencją Apache-2.0, która zezwala na użytek komercyjny na jej warunkach. Licencja dotyczy tego wariantu, a nie wszystkich modeli FLUX; prawa do wygenerowanych obrazów nadal mają znaczenie.
- Projekt startowy: Stwórz kilka wariantów tła dla jednego posiadanego zdjęcia produktu. Przed użyciem porównaj kształt, tekst na opakowaniu, logo i spójność marki z oryginałem.
- Przykładowy stos: ComfyUI do zapisanego przepływu wizualnego i kolejki zadań; destylowany FLUX.2 [klein] 4B do generowania i edycji na podstawie obrazu referencyjnego na GPU.
- Główne ograniczenie: Przekonujący obraz nadal może zmienić produkt lub jego tekst. Traktuj wyniki jako koncepcje wymagające weryfikacji dokładności i praw.
3. Превращение записей в транскрипты, субтитры и поисковые знания
Ошибка: я переводила на русский, но система требует польский. Исправляю ниже.
3. Zamień nagrania w transkrypcje, napisy i wiedzę możliwą do przeszukania
Twoje webinarium lub spotkanie nagrane za odpowiednią zgodą może zawierać informacje, które później trudno znaleźć. Moduł transkrypcji zamienia je na tekst z znacznikami czasu oraz pliki z napisami. Uporządkuj sprawdzone transkrypcje, a zwykłe wyszukiwanie tekstu pomoże znaleźć temat bez ponownego odtwarzania każdego nagrania.

Model mowy najpierw tworzy segmenty transkrypcji ze znacznikami czasu. Wrapper eksportu, czyli kod aplikacji wokół biblioteki rozpoznawania, zapisuje je następnie jako czytelny tekst oraz pliki napisów SRT lub VTT. Te znaczniki czasu łączą słowa z nagraniem i dostarczają eksporterowi napisów informacji o czasowaniu.
Folder przesyłania lub kolejka pozwala serwerowi przetwarzać zaległe nagrania bez nadzoru, a rozpoznawaniem mowy zajmuje się GPU. Opcjonalne podsumowania wymagają innego modelu, najlepiej uruchamianego osobno na tej samej karcie. Etykiety mówców wymagają osobnego etapu rozróżniania osób; sama transkrypcja ich nie zapewnia.
- Projekt startowy: Przetwórz kilka nagrań, do których masz zgodę, na transkrypcje i napisy. Porównaj próbki z nagraniem audio, sprawdzając nazwiska, terminologię techniczną i czasowanie napisów.
- Przykładowy stos: faster-whisper z modelem large-v3 i odpowiednimi ustawieniami GPU o zmniejszonej precyzji; kolejka przesyłania; wrapper eksportu do plików napisów i przeszukiwalnego przechowywania transkrypcji.
- Główne ograniczenie: Jakość dźwięku decyduje o nakładzie pracy przy korekcie. Szumy, akcenty, nieznane terminy i nakładające się głosy mogą pozostawiać błędy wymagające weryfikacji przez człowieka.
4. Подключите приватного помощника по программированию к редактору
Ошибка: я должен переводить на польский, а не на русский. Исправляю:
4. Połącz prywatnego asystenta programistycznego z edytorem
Zaznacz funkcję w edytorze i poproś o testy, wyjaśnienie lub niewielki refaktoring. Otrzymasz szkicowy kod obok funkcji, nad którą pracujesz. Edytor i pliki robocze mogą pozostać na laptopie, podczas gdy zaznaczony kod trafia na serwer w celu wnioskowania.
Edytor wysyła zaznaczony kod oraz Twoje pytanie do zdalnego punktu końcowego modelu, a następnie wyświetla odpowiedź w środowisku deweloperskim. Dołączenie zamierzonego działania funkcji pomaga sprecyzować żądanie. W przypadku zadania pisania testów wynik daje Ci szkic do porównania z tym działaniem, zamiast pustego pliku testowego.
Procesor graficzny (GPU) odpowiada za generowanie odpowiedzi, a serwer udostępnia wielokrotnego użytku punkt końcowy dla żądań z edytora. Wykonywanie kodu i ryzykowne zmiany pozostają pod Twoją kontrolą, z ograniczonymi uprawnieniami. Czat w edytorze jest tu punktem wyjścia; responsywne autouzupełnianie w linii ma inne wymagania dotyczące modelu i opóźnień.
- Projekt startowy: Przygotuj szkicowe testy dla jednego modułu. Sprawdź je, uruchom w kontrolowanym środowisku deweloperskim i zweryfikuj zamierzone działanie, a nie tylko to, czy się kompilują.
- Przykładowy stos: Kontynuuj z czatem w edytorze i proponowanymi zmianami; kontrolowany punkt końcowy Ollama działający na serwerze z kwantyzowanym modelem Qwen3.5-4B do generowania odpowiedzi.
- Główne ograniczenie: Jakość małego modelu, ograniczony kontekst kodu i opóźnienia sieci ograniczają pomoc. To nie jest substytut największych komercyjnych systemów do programowania.
5. Zamień faktury i skany w uporządkowane rekordy
Obrazy faktur mogą zostać przekształcone w proponowane pola dostawcy, daty, numeru faktury i sumy w arkuszu do weryfikacji. Powiązanie każdego wiersza z oryginalnym dokumentem ułatwia porównanie. Praktyczną korzyścią jest spójny zestaw rekordów, który ktoś może sprawdzić i przekazać do kolejnego procesu biznesowego.

Model vision-language przyjmuje zarówno obrazy, jak i tekst. Przygotuj jeden obraz strony na raz, a następnie poproś o pola, których potrzebujesz. Dzięki temu GPU służy do interpretacji wizualnej, a nie zakłada się, że model poradzi sobie z każdym typem PDF. Czyste, tekstowe pliki PDF mogą wymagać jedynie zwykłego parsowania, bez udziału GPU.
Po ekstrakcji zwykły kod aplikacji sprawdza, czy wymagane wartości są obecne oraz czy daty i liczby mają oczekiwany format. Może też sprawdzić poprawność arytmetyczną, jeśli jest to możliwe, oraz wyszukać zduplikowane identyfikatory faktur. Brakujące lub niepewne pola pozostają oznaczone. Serwer zestawia wyniki wsadowe wraz z ich źródłami na potrzeby przekazania do weryfikacji:
Invoice image → GPU extraction
                      ↓
    +------------------------------------+
    | Ordinary validation + human review |
    +------------------------------------+
                      ↓
         Approved spreadsheet/record
Wyodrębnione pola są propozycjami do momentu zakończenia zwykłych kontroli i weryfikacji przez człowieka; dopiero wtedy powinny stać się zatwierdzonymi rekordami.
- Projekt startowy: Przekształć jedną rodzinę faktur w arkusz do weryfikacji z odniesieniami do źródeł. Porównaj każde wybrane pole z oryginałem przed zaakceptowaniem wiersza.
- Przykładowy stack: Przygotowanie obrazów stron; Ollama z Qwen3.5-4B do ekstrakcji wizualnej; zwykły kod walidacji/eksportu oraz etap weryfikacji, który tworzy zatwierdzone rekordy w arkuszu z odniesieniami do źródeł.
- Główne ograniczenie: Wiarygodnie wyglądające wartości mogą być błędne. Wymagaj zatwierdzenia przez człowieka przed wprowadzeniem do księgowości lub wypłatą.
6. Подготовка загруженного видео для разных зрителей
Translation must be into Polish, not Russian. Correcting:
6. Przygotowanie przesłanego wideo dla różnych odbiorców
Lekcja lub prezentacja produktu może wymagać kilku wersji do odtwarzania, a nie nowego materiału. Transkodowanie konwertuje istniejące zakodowane wideo. Odpowiedni plik główny może zostać przekształcony w kopie 1080p i 720p dla różnych ekranów i połączeń. Zmniejszenie rozdzielczości może ułatwić dostarczanie, natomiast jej zwiększenie nie odtworzy brakujących szczegółów.
NVENC to wyspecjalizowany koder wideo firmy NVIDIA, niezależny od obliczeń modeli językowych. Kodek to technologia służąca do kodowania i dekodowania wideo. H.264 jest szeroko kompatybilnym, dobrym wyborem na start; AV1 to kolejna opcja, gdy docelowe urządzenia odtwarzające ją obsługują. Dekodowanie i skalowanie mogą wykorzystywać inny sprzęt GPU lub procesor CPU.
Serwer może stosować spójne ustawienia konwersji do przesłanych kolejką plików i przechowywać kopie do dostarczenia osobno od pliku głównego. Sprzęt multimedialny obsługuje kodowanie w zakresie wspieranym, ale ustawienia nadal wpływają na wynik. Wybieraj kodowanie sprzętowe ze względu na przepustowość, a nie gwarantowaną poprawę jakości w porównaniu z kodowaniem na CPU.
- Projekt startowy: Przekonwertuj jedno własne nagranie na wersje 1080p i 720p. Sprawdź odtwarzanie na docelowych urządzeniach, synchronizację dźwięku, czytelność treści oraz rozmiary plików.
- Przykładowy zestaw: FFmpeg do konwersji z kodowaniem obsługiwanym przez NVIDIA; prosta kolejka przesyłania do planowania zadań oraz pamięć na pliki źródłowe i gotowe wersje do dostarczenia.
- Główne ograniczenie: Wydajność zależy od kodeków, ustawień, ograniczeń sesji sterownika, aktywności dysku i przepustowości transferu — nie tylko od pamięci GPU.
7. Відправка рендерів Blender на віддалений GPU-воркер
Ah, wait — the system prompt says the output must be in Polish, not Ukrainian. Correcting that below.
7. Wysyłanie renderów Blender do zdalnego workera GPU
Projektant produktu może dalej modelować lokalnie, podczas gdy serwer generuje gotowe nieruchome obrazy lub klatki obrotu modelu. Renderowanie oznacza obliczanie gotowych obrazów na podstawie istniejącej sceny 3D, a nie tworzenie obrazu na podstawie opisu tekstowego. Ty dostarczasz scenę, materiały, oświetlenie i kamerę; worker oblicza gotowe obrazy.
Backend renderowania łączy obliczenia sceny z akceleracją sprzętową RTX. Możesz uruchomić renderowanie w tle bez interaktywnego zdalnego pulpitu, dzięki czemu przygotowane zadanie wygeneruje pliki wynikowe na serwerze. Renderowanie GPU wybierasz osobno; sam tryb tła nie wybiera urządzenia renderującego.
Przekazanie zadania wymaga zgodnych funkcji Blendera oraz wszystkich wymaganych zasobów: dołącz tekstury do projektu lub upewnij się, że ich ścieżki są rozpoznawalne na serwerze. Czas wysyłania i przygotowania może przewyższyć korzyść przy bardzo małych zadaniach. Obsługiwany mechanizm awaryjny pamięci może pomóc większym scenom zmieścić się, kosztem wydajności.
- Projekt startowy: Wyrenderuj jedną skromną scenę produktu jako gotowe nieruchome obrazy lub krótki obrót modelu. Sprawdź tekstury, materiały, oświetlenie i kadrowanie reprezentatywnej klatki, zanim dodasz wszystko do kolejki.
- Przykładowy stos: Blender Cycles do renderowania sceny; NVIDIA OptiX do akceleracji GPU; wykonywanie w tle, aby generować pliki wynikowe bez konieczności korzystania z interaktywnego zdalnego pulpitu.
- Główne ograniczenie: Dopasowanie zależy od pamięci sceny i tekstur. Wiele kart zazwyczaj nie łączy pamięci sceny w tym sprzęcie.
8. Адаптація невеликої моделі до одного повторюваного завдання
Wait — the target language is Polish, not Ukrainian. Correcting the output:
8. Adaptacja małego modelu do jednego, powtarzalnego zadania
Bardziej zaawansowane. Możesz zaadaptować mały model tak, aby klasyfikował zgłoszenia do pomocy technicznej do istniejących kategorii: rozliczenia, dostęp do konta lub problemy techniczne. Myśl o tym jak o szkoleniu pracownika w zakresie wąskiej procedury, a nie o nauczaniu go od podstaw. Efektem jest adapter oraz dowody z ewaluacji — a nie nienadzorowane działania na zgłoszeniach.
QLoRA utrzymuje w dużej mierze stały, skwantyzowany model bazowy, trenując niewielkie dodatkowe komponenty zwane adapterami. Nie jest to trening modelu fundamentowego ani pełne dostrajanie wszystkich wag. Trening wykonuje karta GPU, a serwer zapewnia izolowane, powtarzalne zadanie i przechowuje jego artefakty. Pozostałe obciążenia wymagające jednej karty należy planować osobno.
Zacznij od obsługiwanego przepisu treningowego dla małych modeli tekstowych, a nie od wcześniejszego pakietu inferencyjnego Ollama. Zgodnie z wymaganiami Unsloth, obsługiwane modele o rozmiarze około trzech do ośmiu miliardów parametrów są dobrymi kandydatami na start. Krótkie sekwencje i małe partie danych pomagają kontrolować zużycie pamięci, ale nie każdy model ani przepis zmieści się w 16 GB. Najpierw wypróbuj podpowiedzi (prompty); do zmieniających się faktów używaj wyszukiwania (retrieval).
- Projekt startowy: Porównaj oryginalny model, wersję z dobrze skonstruowanym promptem i wersję zaadaptowaną na tym samym zestawie wstrzymanych zgłoszeń — przykładach wykluczonych z treningu. Sprawdź wybory kategorii i błędy.
- Przykładowy stos: Udokumentowana przez Unsloth ścieżka treningowa z użyciem starszego modelu tekstowego Qwen2.5-7B-Instruct w zgodnym przepisie 4-bitowym; oznaczone przykłady zgłoszeń oraz kod ewaluacji predykcji kategorii.
- Główne ograniczenie: Jakość danych i ewaluacja decydują o tym, czy adaptacja pomogła. Ukończenie treningu nie dowodzi poprawy.
Что нужно вашему проекту помимо GPU
Когда у вас есть проект, подберите окружающий сервер. Если VRAM — это рабочий стол, то системная RAM — это соседняя зона для подготовки приложения и данных. Выбирайте мощность CPU для парсинга и другой сопутствующей работы приложения. NVMe SSD-хранилище — это склад для активных моделей и ресурсов.
Больший объём накопителя не увеличивает память GPU; перенос работы в системную RAM может помочь поддерживаемым приложениям поместиться в память, но с накладными расходами на производительность. Проверьте требования к оборудованию выбранного ПО вместе с этими ресурсами.
AlexHost предлагает конфигурации с одной и двумя картами, включая одиночную RTX 4070 Ti SUPER с 16 GB памяти GPU, 64 GB RAM и 1 TB NVMe. Это один из примеров сочетания карты с ресурсами для сопутствующего приложения.
Когда нагрузка растёт, отличайте более длинную очередь от задачи, которая больше не помещается. Другая GPU может обрабатывать независимые задачи. Более крупная модель или сцена может потребовать больше памяти на каждую карту. Некоторые приложения для обслуживания моделей могут распределять задачу между картами с накладными расходами на коммуникацию; независимые воркеры — более простой вариант:
+-------------------+
| GPU 1: 16 GB VRAM | → Knowledge assistant
+-------------------+

+-------------------+
| GPU 2: 16 GB VRAM | → Queued image jobs
+-------------------+
Оставляйте запас памяти сверх весов модели для контекста и временных вычислений. Более высокое разрешение изображений и одновременные запросы также могут увеличить потребность в памяти. Руководство Ollama по памяти объясняет, почему размер загрузки не равен пиковому использованию памяти. На одной карте очереди задач или отдельные расписания могут не дать конкурирующим моделям исчерпать память.
📝 Примечание:Концептуальные назначения, а не обещанная схема провайдера: две отдельные GPU по 16 GB дают в сумме 32 GB, а не автоматическое выделение 32 GB. Разделение модели между картами — это отдельная функция ПО, а не автоматическое объединение памяти.
Библиотекам записей нужны хранилище и резервные копии, а частые передачи делают пропускную способность частью решения о мощности. Для сервиса, доступного извне, используйте аутентификацию и ограничивайте доступ предполагаемыми пользователями. Ответственный за обслуживание должен поддерживать его в актуальном состоянии и проверять внешние пути обработки. Этот же ответственный должен решить, как долго хранить логи и резервные копии.
Регулярная работа может оправдать выделенные ресурсы; эпизодическое использование может лучше подойти API или разовой аренде. Соотнесите трудозатраты на эксплуатацию приложения со стоимостью аренды.
Wybierz jeden przydatny pierwszy projekt
Dopasuj wynik, którego potrzebujesz, do małego projektu, który możesz sprawdzić:
| Twój cel | Projekt startowy | Główne ograniczenie |
|---|---|---|
| 📚 Odpowiedzi z dokumentów wewnętrznych | Jedna wyselekcjonowana kolekcja materiałów wdrożeniowych | Jakość wyszukiwania i uprawnienia |
| 🎨 Koncepcje obrazów kampanii | Warianty jednego posiadanego zdjęcia produktu | Dokładność produktu i prawa |
| 🎙️Czytelne, przeszukiwalne nagrania | Sprawdzona transkrypcja i napisy | Jakość audio i korekta |
| 💻 Pomoc w edytorze kodu | Szkice testów dla jednego modułu | Kontekst i przegląd kodu |
| 🧾 Ustrukturyzowane rekordy faktur | Jedna rodzina faktur w arkuszu do przeglądu | Walidacja pól i zatwierdzanie |
| 🎬 Wideo gotowe do dostarczenia | Jedno nagranie w dwóch rozdzielczościach | Obsługa kodeków i wydajność potoku |
| 🧊 Gotowe wizualizacje 3D | Mały projekt renderowania produktu | Pamięć sceny i transfer zasobów |
| 🧠 Spójne zachowanie modelu—zaawansowane | Adapter dla kategorii wsparcia | Dane treningowe i ewaluacja na zbiorze wydzielonym |
Dla zespołów posiadających dokumenty asystent wiedzy stanowi przystępny punkt wyjścia. Twórcy wizualni mogą zacząć od edycji obrazów, a osoby posiadające biblioteki nagrań mogą zacząć od transkrypcji. Wybierz jeden wynik, korzystając z danych, które posiadasz lub do których masz pozwolenie. Określ sukces konkretnie: odpowiedź oparta na właściwych fragmentach lub napisy zgodne z nagraniem.
Jeśli hosting zdalny odpowiada Twojemu wyborowi, oferta serwerów GPU AlexHost zapewnia konfiguracje do porównania z wybranym projektem. Następnie zbuduj najmniejszą wersję, która daje przydatny rezultat. Twoim pierwszym kamieniem milowym jest gotowy wynik, którego możesz użyć—a nie serwer pełen niedokończonych aplikacji.